The TorchTPU Team · PyTorch · 2026-10-20
原文:Introducing TorchTPU
TorchTPU 的主要变化,是让 PyTorch 程序通过原生后端使用 TPU,而不是先接受另一套框架的执行习惯。它把 eager、torch.compile 和分布式接口都放在设计中心。对研究者而言,入口可以更熟悉;对系统工程师而言,编译延迟、张量形状、通信语义和精度仍决定实际表现。把设备名从 cuda 改成 tpu,是兼容性的起点,不是性能调优的终点。
相同接口下面,仍然是 TPU 编译栈
后端通过 PyTorch dispatcher 的 PrivateUse1 接入,并提供设备相关 tensor storage。高层算子下降到 StableHLO,自定义 Pallas kernel 可走 Mosaic,最终由 OpenXLA 生成 TPU executable,PjRT 负责编译、派发和数据搬运。标准后端的运行时不要求 JAX;使用 JAX/Pallas 编写自定义 kernel 是另一个可选入口,这两点并不矛盾。
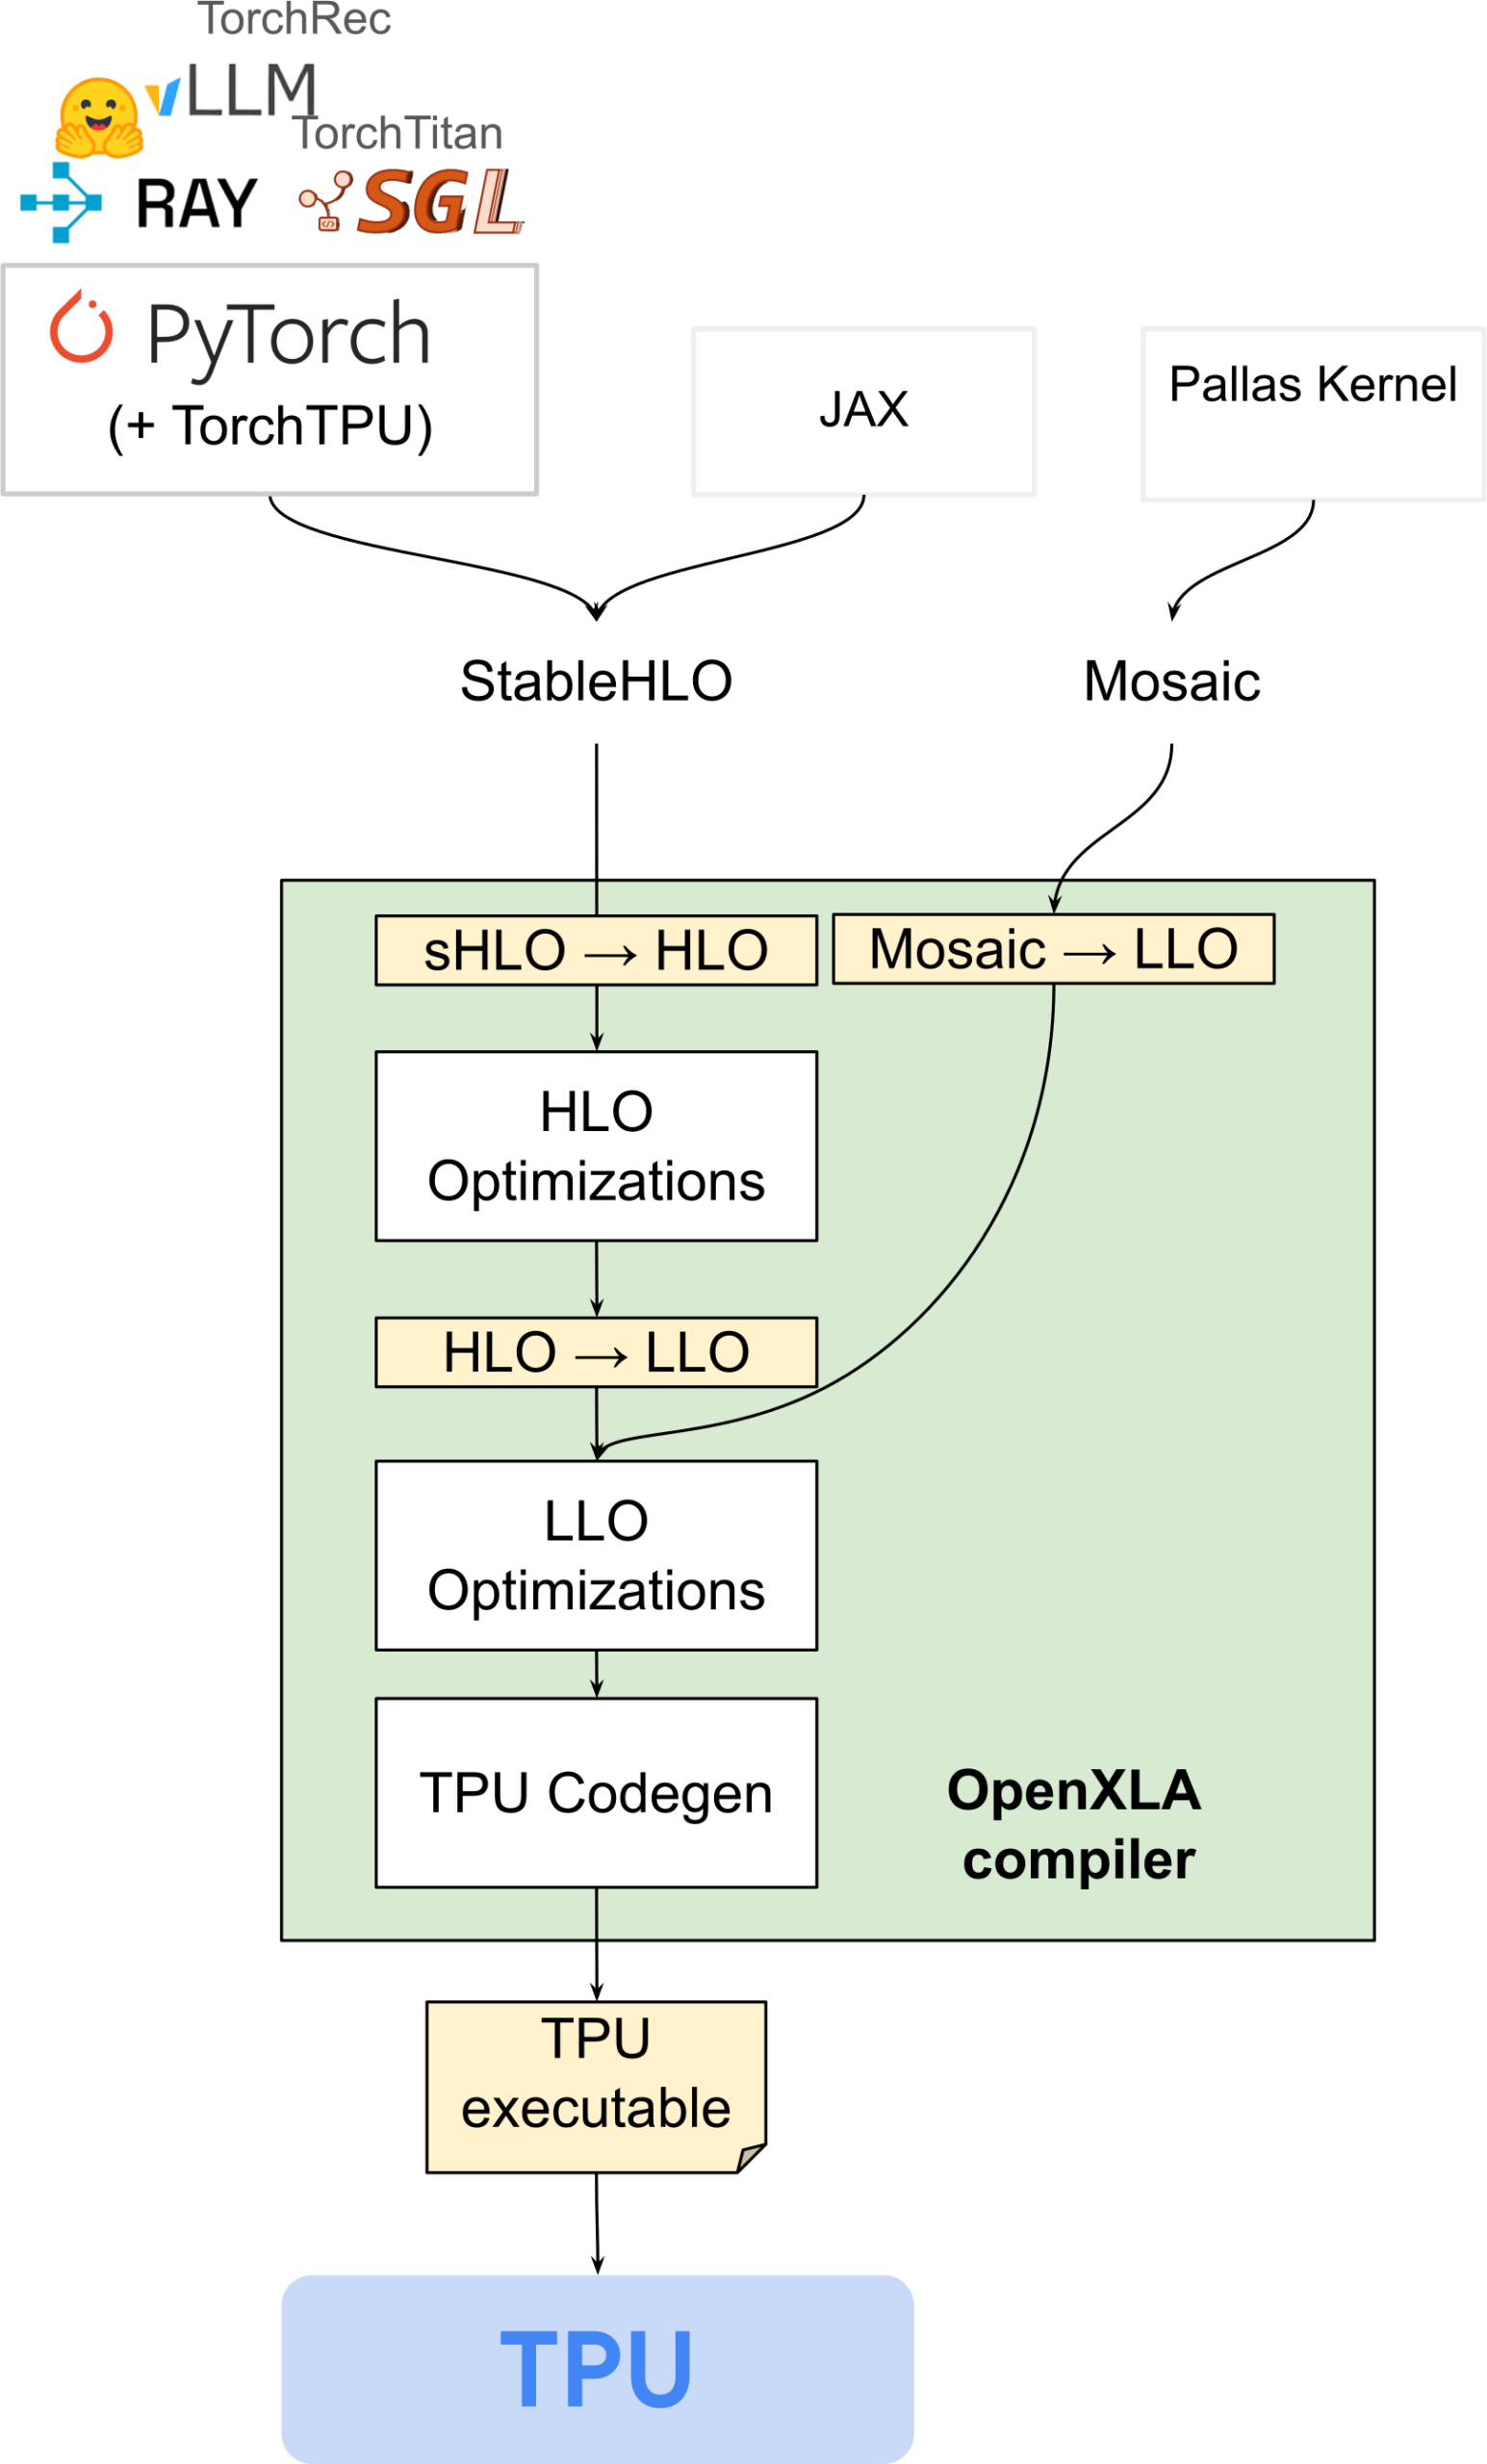
PyTorch 与 JAX 可分别进入 StableHLO,自定义 kernel 进入 Mosaic;路径在 OpenXLA 中汇合后生成 TPU 可执行程序。
这条路径必须协调 PyTorch 可变 view 与 StableHLO 的单赋值语义。原文介绍 view 分解及反向更新,使熟悉的原地修改行为能在编译表示中成立。它也强调形状通常要在编译时已知,并推进有上界的动态维度支持。因而“程序能跑”之外,还需关注形状变化是否触发重编译、view 更新是否制造额外工作。
Eager 不再只有逐算子派发
Strict 模式逐个算子异步提交,保留 PyTorch 用户熟悉的交互方式;Debug 逐算子同步,牺牲速度换取定位能力。DeferAndFuse 则先记录一段算子,在需要取回 CPU 值等 materialization point 处组织图、检查存活值、查编译缓存并派发。短暂延后让多个算子可以融合,减少临时 HBM 状态。
这里的工程取舍是首轮编译与后续重用。热缓存下,CPU 追踪和派发可以领先于设备计算;冷启动或不断变化的图却未必能摊薄编译成本。带副作用的 collective 不能被当成死代码删掉,其顺序也必须保留。评价这种模式,应区分首次执行、稳定迭代与形状扰动,单个热身后的均值不足以解释交互体验。
官方给出的 FLUX 优化路径很有说明性:起点 eager 步时为 11.49 秒,DeferAndFuse 为 9.95 秒;加入 SimpleFSDP 后为 6.52 秒,Pallas attention 后为 5.55 秒,完整 compile 后为 3.02 秒,再经特定模型重写达到 2.78 秒。这是逐步叠加多项优化的结果,不能把从 11.49 到 2.78 秒的全部收益归给某一个开关,也不是与任意 GPU 的直接比较。
分布式兼容性比改设备名更难
TorchTPU 采用每设备一进程,通过 Process Group 接入 PyTorch collective。TPU 后端却需要跨 rank 一致的通信表示;不同 rank 的分支或不均匀 DTensor 切分,可能导致编译模块不一致。默认 Skinny Collectives 把每个通信操作编译成独立模块,避免同步标志和缓冲偏移不匹配,但减少计算通信重叠。
作者给出约 30–40% 端到端性能损失的例子,说明保守兼容性有成本。已知为 SPMD 的区域可用 spmd_safe 标注让编译器扩大优化范围,但错误标注会使系统脆弱。跨副本比较图的 compilation handshake 是另一方向,不能把尚在推进的机制视为默认已保证所有情况安全。
物理拓扑也参与决策。张量、上下文与专家并行等高通信量维度应优先匹配 slice 内高速 ICI,跨 slice 的 DCN 更适合低频通信。熟悉的 DeviceMesh 只描述逻辑关系;如果 rank 与实际设备的映射不对,自定义分布式 kernel 仍可能把数据送错位置。文章专门讨论逻辑寻址与 ProcessGroup 映射的修正,值得多设备使用者细读。
精度与覆盖率要按工作负载解释
后端默认 medium 矩阵乘精度使用 BF16 输入与 FP32 累加;high 和 highest 通过多遍算法改善精度,原文给出约三倍、六倍 MXU 计算成本。它们不是免费更准确的标签,也不是整模型必然慢同样倍数。数值敏感层的收敛与输出误差需要和吞吐一起判断。
团队报告约 450 个 ATen 算子支持,并验证热门 5,000 个 Hugging Face 模型的开箱执行;这表示覆盖面,不表示每个模型都达到同样性能。训练例子中,BF16 Llama 3 405B 在 1,024 张 v7x、8K context 下达到每 chip 每秒 500 token、超过 50% MFU;这些条件不能从数字旁边删掉。单 TPU 只能由一个用户进程访问,也使 RL 训练与采样共置存在额外限制。
以一次服务生命周期组织性能判断
这份发布说明同时面向训练和推理,二者对同一优化的价值可能不同。长训练可以用很多迭代摊薄编译成本,短任务或频繁扩缩容则更在意首次可用时间;训练的激活保存与反向计算需要全图协同,推理的动态 batch 和序列长度又会不断改变输入形状。一个后端同时支持两类任务,是统一接口的进展,并不意味着两者的瓶颈已经相同。
对照原文的机制,可以把性能问题拆成三段。第一段是图能否稳定重用,关系到编译次数;第二段是设备执行中有多少临时内存、padding 和串行小操作,关系到融合与 kernel;第三段是跨设备通信能否和计算重叠,关系到图一致性及拓扑。只看最后一步时延,很容易把前两段中的额外成本遗漏。
TorchTitan 案例中的 SimpleFSDP 很能说明第三段:把 collective 表达为图中的普通操作,编译器才更有机会调整其位置,并让 SparseCore 与矩阵计算并行。它不是取消通信,而是增加调度器可见的信息。类似地,激活 offload 通过转移状态释放 HBM,却引入主机传输;是否值得仍取决于内存压力、带宽和重叠机会。
因此,此次发布的阅读价值不只是一张支持表,更是展示怎样为 PyTorch 语义建立 TPU 后端。生态迁移减少重复实现,特定硬件调优仍须明确核算;将二者分开,才能判断“更容易使用”何时真的转化成“更高效运行”。
代码复用也需要区分算子语义和性能实现。通用路径能让更多模型启动,定制 attention、稀疏专家计算和内存布局则决定某些热点能否充分利用设备。原文将二者同时展示,恰好说明覆盖率与优化程度应该分别报告:前者减少迁移阻力,后者回答特定负载能运行得多好。
值得关注的是 PyTorch 生态迁移成本下降,以及编译器开始更完整地接管通信、内存和计算协同。原文提供大量实现机制与选定案例,但还不是跨模型、跨硬件、统一价格条件的全面评测。阅读优先级应放在 eager 到 compiled 的边界和 collective 的正确性,再看自己的模型形状、精度与冷启动条件是否匹配报告中的优势。