强化学习中,推理引擎采样轨迹,训练引擎重新计算这些 token 的概率并更新参数。如果相同权重、相同前缀在两边算出不同概率,训练优化的策略就与采样策略产生数值偏差。低精度、动态 batch 和不同并行布局都会放大这一问题。本次 vLLM 工程报告尝试在高性能部署路径上做到逐位一致,同时保留大部分 rollout 吞吐。
原文:Finish RL Training Faster: Bitwise-Consistent, High-Performance, Agent-Driven
Yan Bai(NVIDIA DevTech)、Ao Shen(Inferact)· 发布:2026-10-14
零差异需要一个精确的比较对象
文章比较每次更新前、同一权重版本和 token 前缀下,rollout 与训练重算的有效响应 token logprob;最大、平均、标准差以及 k3 KL 都要求精确为零。它排除参数更新造成的正常策略变化,也不能消除异步训练中旧权重采样的问题。配方每步只更新一次,使比较和更新边界清楚。
只固定随机种子不够。一个请求在不同 batch 中可能选到不同矩阵乘内核;prefill 与 decode 可能用不同注意力算法;MoE 输出可能按不同顺序合并。浮点加法顺序变化会改变末位,Top-K 等离散选择又可能把小差异变成不同上下文或专家集合。因此,要统一的不只是输入,还有计算路径、量化规则、平局处理和累加顺序。
让训练前向使用推理的数值
作者以推理内核作为数值参考,让训练前向直接调用修改后的 vLLM 算子,再另加反向。训练仍保留 BF16 主权重,前向按部署规则量化;FP8 量化的梯度用直通估计器处理。这保留低精度推理能力,却把保存中间量、实现反向与验证梯度的负担放在训练侧。前向一致不证明梯度正确,必须单独对照独立参考。
DeepSeek-V4-Flash 的 dense GEMM 统一到 batch-invariant DeepGEMM,放弃随小 batch 切换的部分优化。稀疏注意力的 Top-K 固定同分选择,并按固定位置顺序排列,确保选到相同集合后仍按同样次序累加。MoE 也统一量化舍入、逐行计算和专家输出合并,而非仅记录路由再回放。
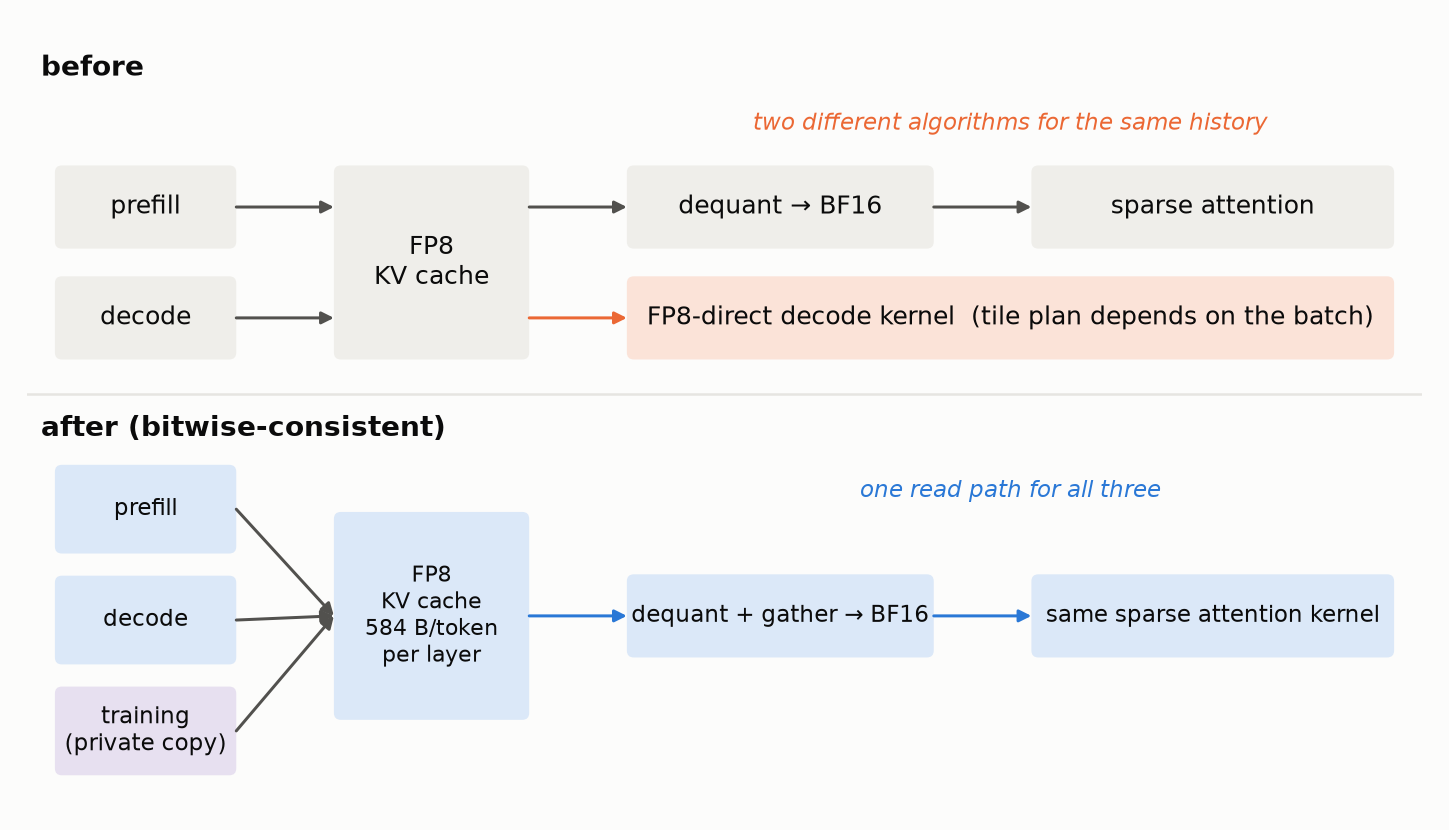
上方两阶段使用不同读取算法;下方保留 FP8 存储,让三条路径均经过反量化与 gather 后进入同一注意力算子。
FP8 KV 提供一个直观例子:原先 prefill 先反量化,decode 走直接读取 FP8 的另一条路径。新实现让 decode 也 gather、反量化到 BF16,再使用同一稀疏注意力算子;训练则建立私有缓存副本,经历相同 FP8 往返。缓存仍以 FP8 保存,但 decode 多了准备成本。该路径当前不覆盖 MTP 或投机解码。
跨 GPU 一致性也有明确取舍。该 DeepSeek 配方要求 TP=1,避免比较路径上的 tensor-parallel 归约;专家输出返回 token 所属 GPU 后,按固定 slot 顺序在 FP32 中合并。CUDA Graph 则要求 eager 与捕获路径一致,工作区地址稳定,更新权重时原地复制,且检查恢复后的第一步。它不是对任意并行配置的通用承诺。
两组结果,要连同分母一起读
DeepSeek-V4-Flash-Base 实验使用 DAPO 格式数学任务、GRPO、超长惩罚,每组八台机器共 32 张 GB200 GPU,每步 128 个 prompt、各八个回答,执行 100 步。两组均每步更新一次,不用 TIS、MIS 等算法修正。基线的训练/推理 KL 从约 0.002 升到 29.9,并伴随奖励回落;一致版本每步差异为零,奖励保持。
一致版本平均 rollout 为 24.22 token/ms,基线为 26.53,即 91.3%。但基线在第 90 步后吞吐下降,取前 89 步比例为 88.6%;两组响应长度还随训练变化,所以比例同时反映工作负载变化,不能完全归因于内核速度。训练侧开销没有单独测量,完整重计算还会多执行前向。
迁移实验采用 Nemotron-3.5-Lightning-30B-A3B,结合 Mamba-2、attention、MoE 与 NVFP4。SWE-bench Pro 训练子集包含 375 个筛选任务,每步 32 个任务、各八条轨迹,平均每条约 57K token,每组八个 GB200 节点。基线使用 QAT 与 R3,两组都每步更新一次且不用 TIS/MIS。一致版本前十步到后十步训练奖励从 0.56 到 0.59,基线从 0.56 降至 0.22;前 30 步 rollout 吞吐为基线的 87.5%。这是筛选子集上的训练奖励,不是公开测试榜单分数。
一致性有多个层面,修好一处还不能验收
文中的核对顺序很有工程价值:先让推理自身在单请求与混合 batch 间一致,再检查整段 prefill 与逐 token decode,之后才接入训练比较。否则,一旦两边出现差异,很难判断来自训练实现,还是推理本来就随 batch 改变。定位到第一个发生偏差的层,比只看最后的 KL 更能缩小原因范围;末端差异可能已经被多个离散选择放大。
另一个容易漏掉的是更新后的状态。CUDA Graph 记住内存地址,若同步新权重时另分配存储,图仍可能读取旧位置。第一步一致并不覆盖这种生命周期错误。原文要求检查更新、导出、重新载入以及 checkpoint 恢复后的执行,这把验证从固定输入的一次比较扩展到真实训练循环。
性能解释也需要同样细致。作者曾发现两组通信路径分别使用较慢的 Ethernet RDMA 与较快的 MNNVL,导致比较混入传输配置差异;统一条件后才有意义。其教训不是某个网络一定更适合全部模型,而是数值对齐版本与基线必须获得相同的性能维护,不能通过削弱基线缩小开销比例。
Nemotron 的迁移进一步涉及递归算术:decode 重放 prefill 的分块计算顺序,训练复用同一算子,而非只要求最终状态近似。它支持方法可迁移到另一类结构,但仍需要逐算子对齐。该组奖励图还排除了只有少量轨迹返回的一致版本第十步;曲线解读必须保留这种数据条件,不能把平滑后的趋势当作每步都有同样样本量的结果。
Agent 工作流的价值在可检查的工程目标
作者把定位首个分歧算子、构造最小案例、对齐前向、验证反向、恢复 checkpoint 和逐项优化整理为 C0–C10 工作流。先用保留全部算子类型的小模型排错,再进入完整深度、长上下文和多 GPU 配置。Agent 承担追踪与回归,人仍审查基线、精度取舍与训练配方;工程时间节省尚未量化。
阅读判断:这是数值协议与性能共同设计的实证案例。 两条基线都只探索了单个配方,没有充分调优;观察到的崩溃不能推出所有常规 RL 配方都会失败。文章也尚未比较达到同一训练目标的端到端墙钟时间,标题中的“更快完成”仍需要长程证据。零差异能消除同权重下的一类偏差,但训练质量、反向正确性、旧策略数据和总体成本仍是各自需要验证的问题。