多轮 Agent 每次调用模型都会携带越来越长的历史。预填充与解码分离后,两类计算可以独立配置,但缓存也随之分散:decode 手里已有上轮生成内容的 KV,下一轮 prefill 却可能重新计算。vLLM 这篇文章的关键变化,是让已有 KV 能从 decode 回到 prefill,并把跨轮定位、保留时间和重算选择一起纳入执行路径。
原文:Improve TTFT for Multi-Turn Agentic Workloads with Bi-Directional KV Transfer in vLLM
Sunita Nadampalli (AWS) · vLLM Blog · 2026-10-12
为什么单向传输还会重复计算
传统 P→D 流程先由 prefill 计算输入 KV,再由 decode 拉取这些块并继续生成。生成完成后,decode 不仅持有输入历史,也持有新增响应的状态。到了下一轮,这段响应已经成为提示的一部分,prefill 却没有反向读取能力,只能补算。若本地前缀被淘汰,或者请求落到另一台 prefill,甚至要重算整段会话。
因此,双向传输解决的是“算过的状态留在另一处”。它不消除新工具结果的计算,也不意味着整个会话永远命中;收益取决于可复用块还在不在,以及取回它们是否比重算更便宜。
一轮生成,怎样为下一轮留下入口
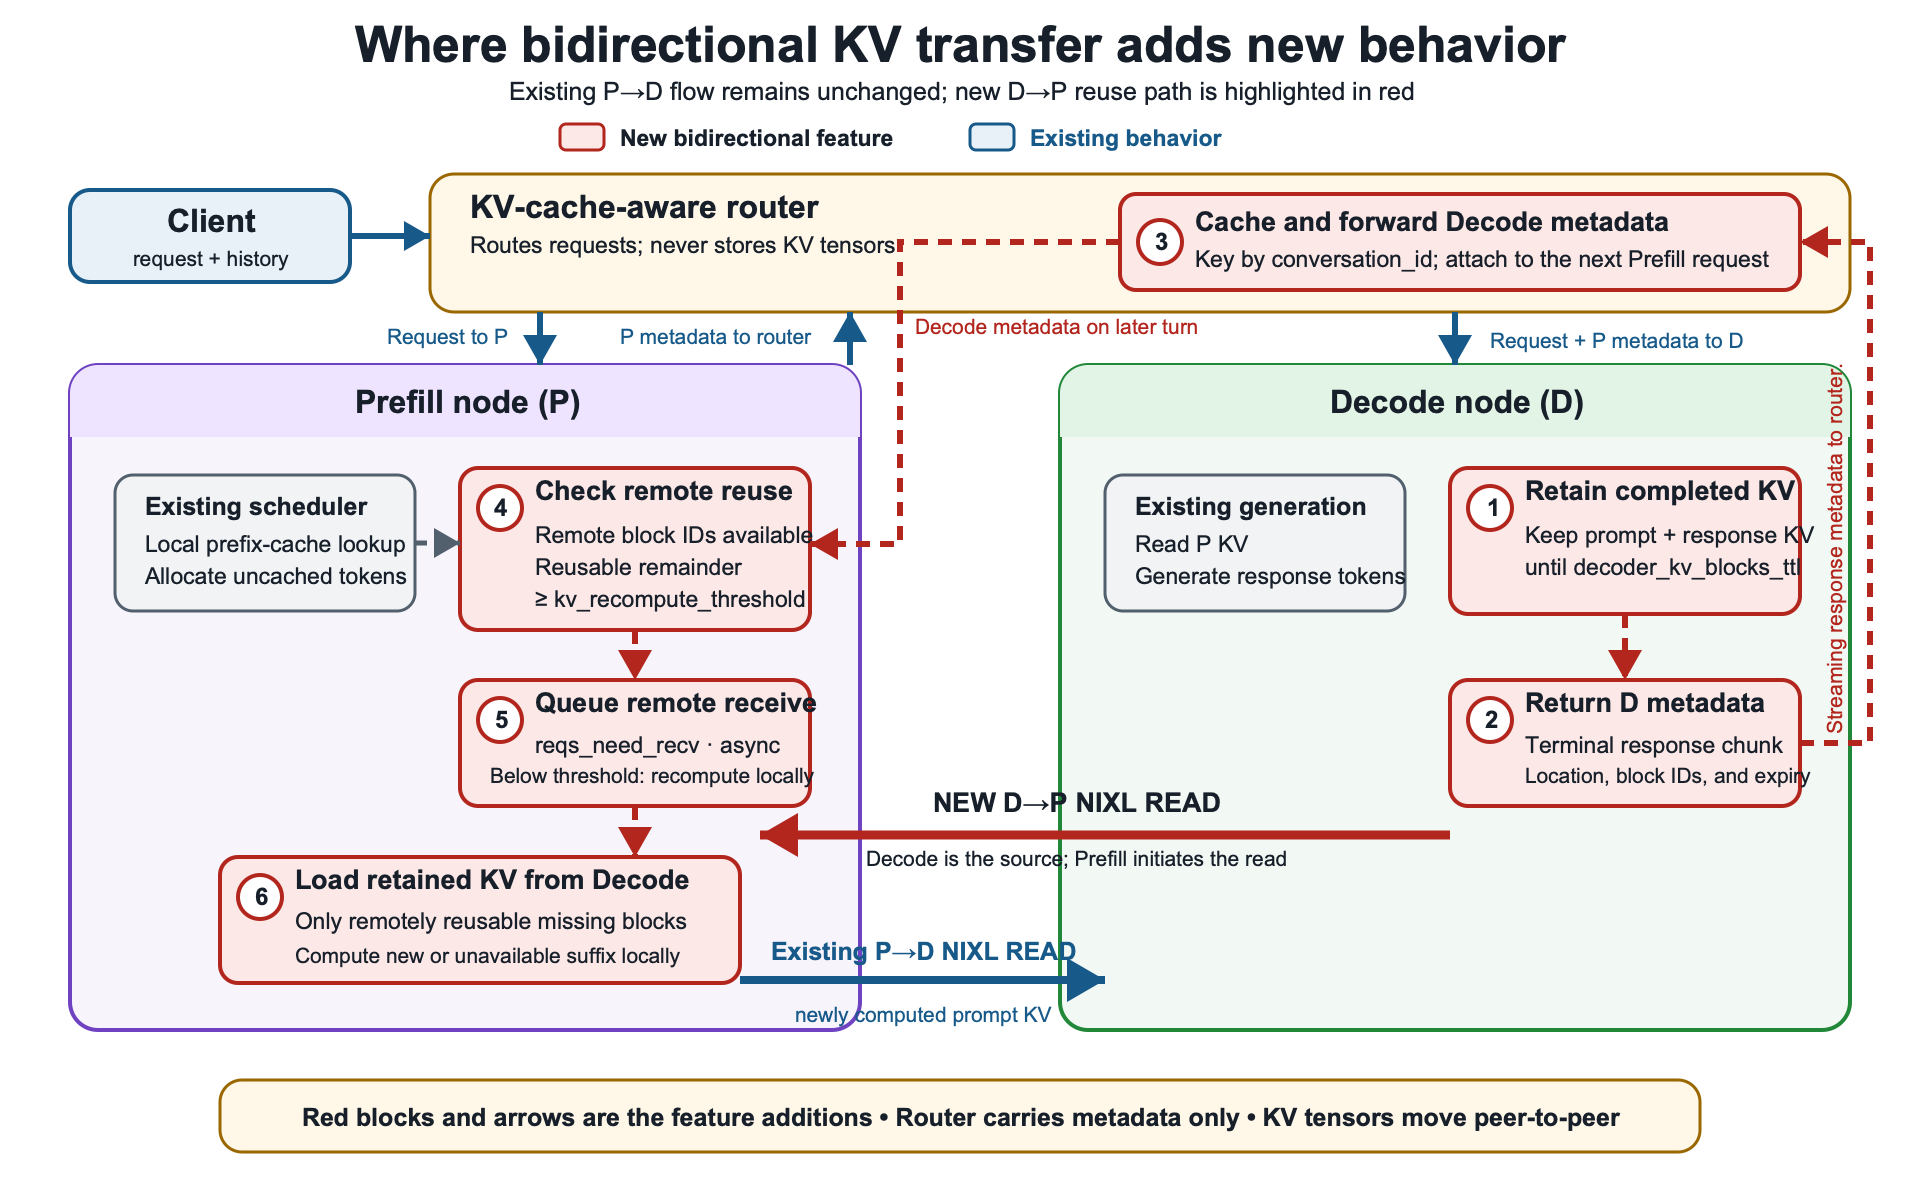
沿红色编号看新增路径:decode 保留块并返回位置,路由器跨轮保存,prefill 检查本地命中后拉回缺失部分;蓝色仍是原有 P→D 路径。
扩展后的 NIXL connector 允许 prefill 成为远端 KV 的消费者,两种方向都使用 NIXL READ。decode 只提供已经缓存的块;prefill 仍负责新内容或不可复用后缀的计算。下一轮请求先完成本地前缀匹配,再判断远端可复用的剩余 token 是否达到阈值,符合条件才异步接收,随后计算后缀。
串起两轮的是有状态路由器。客户端提供 conversation_id,路由器将它映射到 decode 返回的 kv_transfer_params,其中包含块位置等信息。元数据随响应流返回,不需要额外查询;KV 张量在两台计算节点之间移动,不穿过路由器。首轮未命中时走普通流程,响应结束后保存 decode 元数据,后续轮次取出并在完成后刷新。
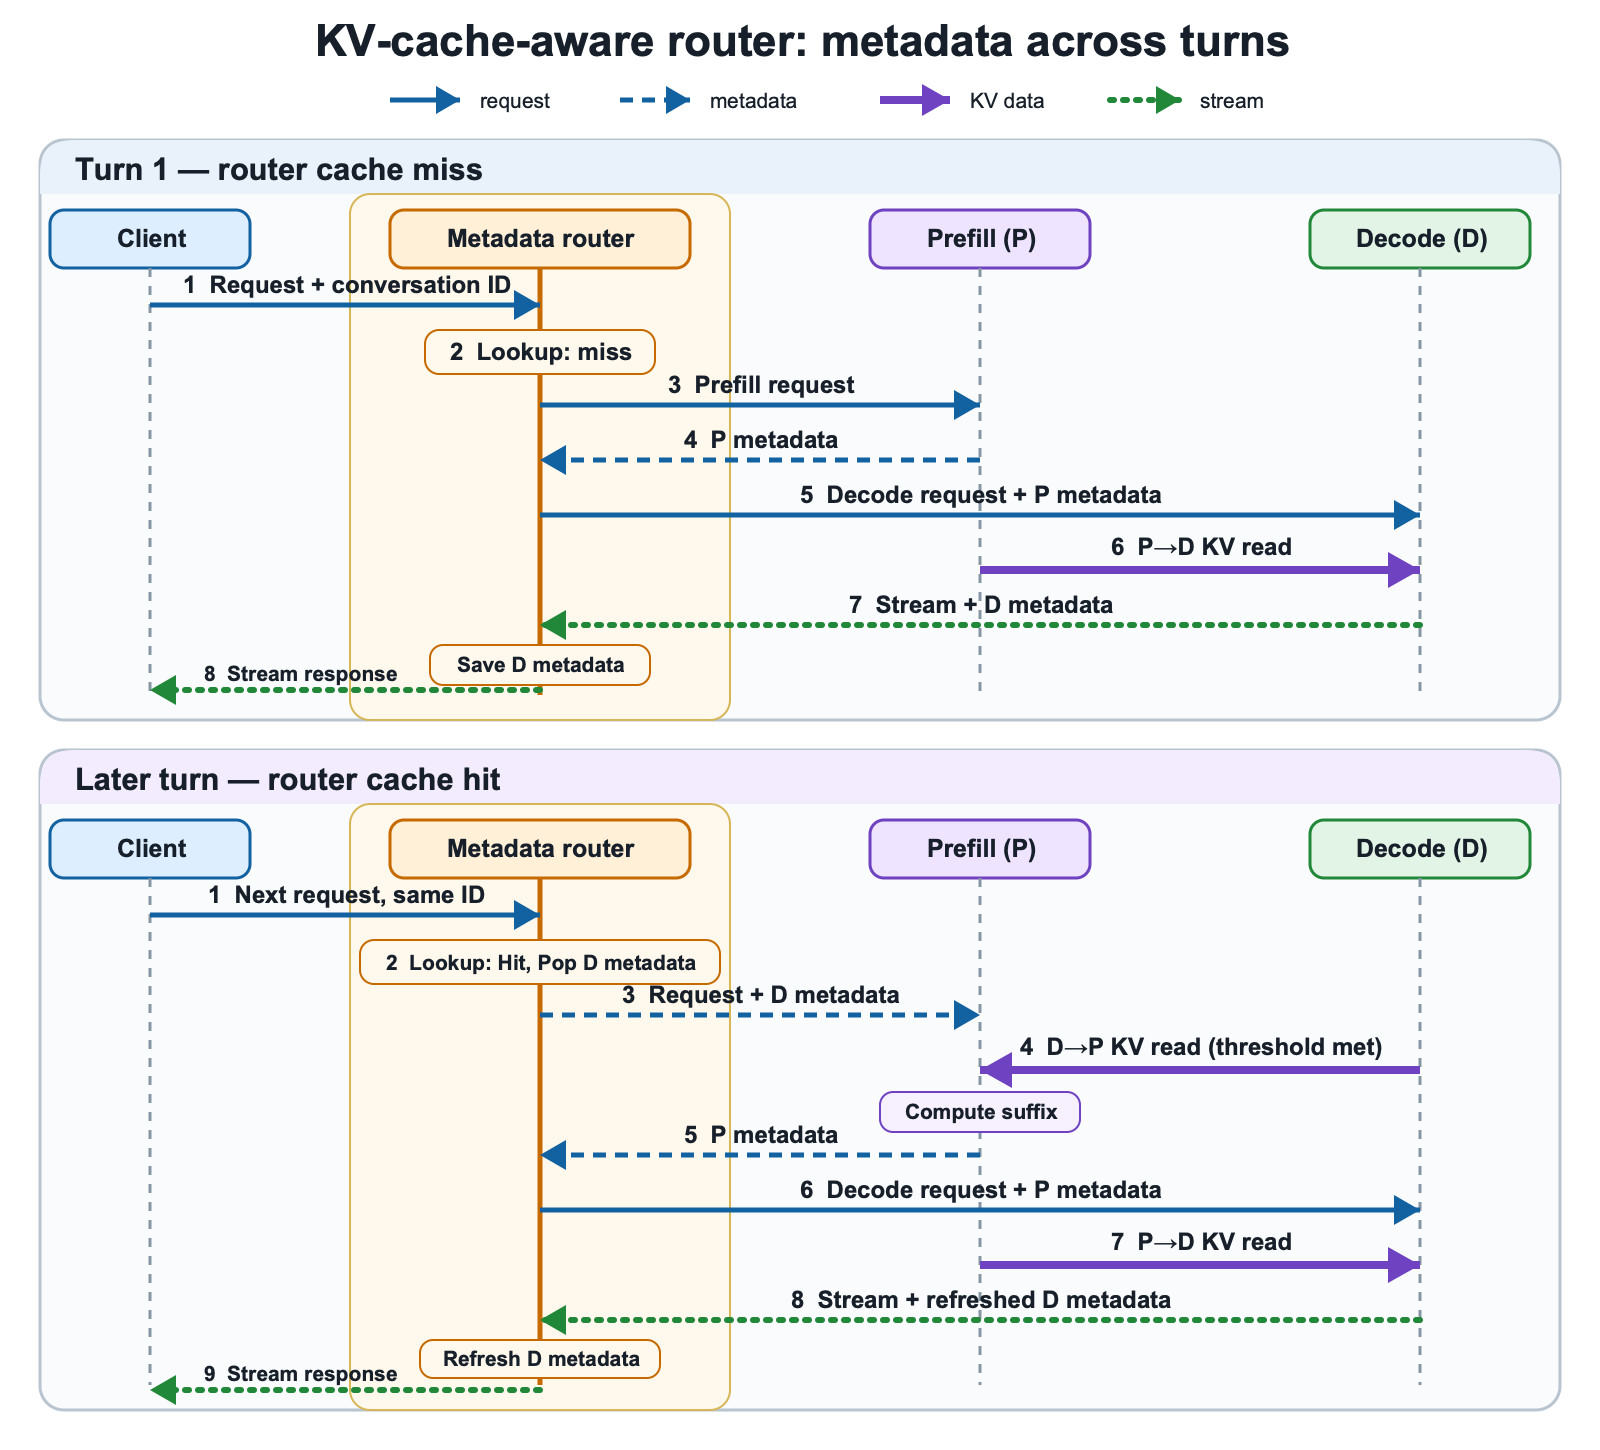
上半图建立首轮元数据,下半图在下一次 prefill 前加入 D→P 读取;紫色箭头表明大块 KV 数据绕过路由器。
从工程上看,转发请求与管理缓存位置已经成为两项相互依赖的职责。仅打开 connector 开关还不够:路由器拿不到流式元数据,就无法为下一轮提供入口。文章给的是示例代理,不能从这张时序图推断它已处理任意并发分支或代理故障恢复。
控制信息正确,数据才有机会复用
会话 ID 解决的是去哪里寻找缓存,实际复用仍要通过本地匹配与远端可用性检查。同一个 ID 不能被理解成整段提示都可直接跳过计算;追加的工具输出和缺失后缀仍需 prefill。普通 P→D 也没有被删除,反向取回历史之后,本轮新产生的输入状态仍要送往 decode。两个方向分担的是不同时间点的工作。
路由器只存元数据有助于避免让代理承担大张量搬运,但也使元数据寿命必须与块寿命协调。文章的故障排查要求代理缓存 TTL 小于 decode 块的 TTL,并用过期远端读取日志定位问题。代理重启会清空进程内映射,这也解释了为什么实验切换开关时会重启代理:旧映射不能被当作新一轮实验的可靠缓存入口。
两个参数控制收益与代价
decoder_kv_blocks_ttl 默认 480 秒。decode 在生成后暂留块,下一轮在过期前抵达才有复用机会,过期则回到正常 prefill。这里是固定且不续期的 TTL;更长的保留时间增加跨轮命中机会,也让已结束请求继续占用显存,影响新请求容量。文章把可由心跳续期的 decode 租约列为后续改进,不能当成已有能力。
kv_recompute_threshold 默认 64 token。短前缀的协调与传输开销可能大于本地重算,因此应针对本地匹配后仍可从远端复用的部分判断。这个阈值是 token 数,不是时间承诺;模型每 token 计算成本、KV 大小和实际网络速率都会改变盈亏点。
由此得到的工程判断是:先看跨轮间隔是否落在保留期内,再看省下的计算能否覆盖查找、搬运与安装状态的成本。更高命中率也可能伴随更紧张的显存,必须把两者放在一起看。
性能数字成立于什么配置
作者使用一台 prefill 加一台 decode 的 1P1D 部署,两台 EC2 p5en.48xlarge 各有八块 H200,通过 EFA 连接,另有节点运行代理与客户端。关键条件是 prefill 关闭前缀缓存,模拟缓存已经淘汰或请求被路由到没有历史 KV 的节点;decode 仍开启前缀缓存。
| 模型与提示长度 | 关闭双向传输的 TTFT | 开启后的 TTFT |
|---|---|---|
| Qwen3-32B,2k token | 158 ms | 122 ms |
| Qwen3-32B,24k token | 778 ms | 460 ms |
| zai-org/GLM-5-FP8,2k token | 500 ms | 358 ms |
| zai-org/GLM-5-FP8,20k token | 2,334 ms | 702 ms |
原文将最长提示收益概括为约 1.6 倍和 3.3 倍。相应 KV 传输时间在所测提示范围内,Qwen3-32B 约为 30–130 ms,GLM-5-FP8 约为 29–110 ms。它增加了网络工作,却省下更多预填充计算,因而降低首 token 延迟。开启后 TTFT 仍随上下文变长而增加,不能称为恒定延迟。
这些数据展示了本地缓存未命中时的机会。若生产流量大部分在 prefill 本地命中,可回收的重复计算更少;较慢网络、较短提示或更长轮间隔也会改变收益。TTFT 改善本身不能证明持续解码速度、总吞吐和高分位延迟都有相同比例改善。
评估时还应区分首轮与后续轮:首轮本来没有上一轮 decode 状态可取,后续轮才检验跨轮传输。对这些结果的合理延伸,是按提示长度与会话轮次观察命中、搬运字节和延迟,而非只汇总一个平均数。增加保留期后,若缓存更常命中但排队变长,用户体验也可能没有改善;这属于需要结合目标负载判断的容量取舍。
实际接入时先核对元数据链路
文章正文称该能力适用于 vLLM v0.21.0 及以后版本,但复现实验附录固定了 vLLM 0.29.0、NIXL 1.4.1,并要求应用 PR #40186,让流式响应携带 kv_transfer_params。版本支持声明与这套具体实验环境应分别理解。P、D 两端都需要启用 bidirectional_kv_xfer,客户端还要稳定提供会话 ID;否则服务能正常回答,也可能始终无法跨轮复用。
观测应对应真实路径:TTFT 来自客户端请求统计,prefill 总时长来自代理,D→P 传输时间和字节数来自发起读取的 prefill 节点。若只看最终延迟,难以区分缓存未命中、块过期、元数据缺失与传输过慢。最值得学习的是这条完整的状态流转链:保留已有结果、跨轮发现位置,再依据重算成本决定是否搬运。它把多轮上下文复用从局部缓存设置推进到了服务编排问题。