一个总参数 40B、每 token 激活约 2.5B 的 MoE,在单 GPU 上能跑多快,取决于活跃专家之外的许多细节:多少层读取完整 KV、低比特权重怎样进入内核、一个 decode 步骤要启动多少小 kernel。vLLM 的 Flint 首日支持文章把这些问题拆成一条具体优化路径。它讨论的是 Recursive 的生成模型 Flint,与同名的多向量检索论文 FLINT 是不同工作。
来源:Inferact and Recursive / vLLM · 首发 2026-10-21
原文:Day-0 Support for Flint on vLLM。以下数字来自官方文章的单 GB200 测量。
49 层中,只有 14 层保留全历史 KV
Flint 使用 49 层 pre-norm 结构、hidden size 2048,支持 262K token 上下文。其中 35 层采用带 RoPE 的 513-token 滑动窗口,其余 14 层做无位置编码的全上下文注意力。这个组合把每步读取的历史限制在大部分层的局部范围,同时让少数层承担长距离信息交互。
文章给出全历史缓存增长成本为每 token 28 KiB。理解这个数字时,关键不是“长上下文不花内存”,而是只有部分层的 KV 随整个序列增长;窗口层仍需保留局部状态,权重、工作区和运行时分配也另占空间。因此 262K 是模型上下文能力,不能单独推出任意显卡在该长度下的并发容量。
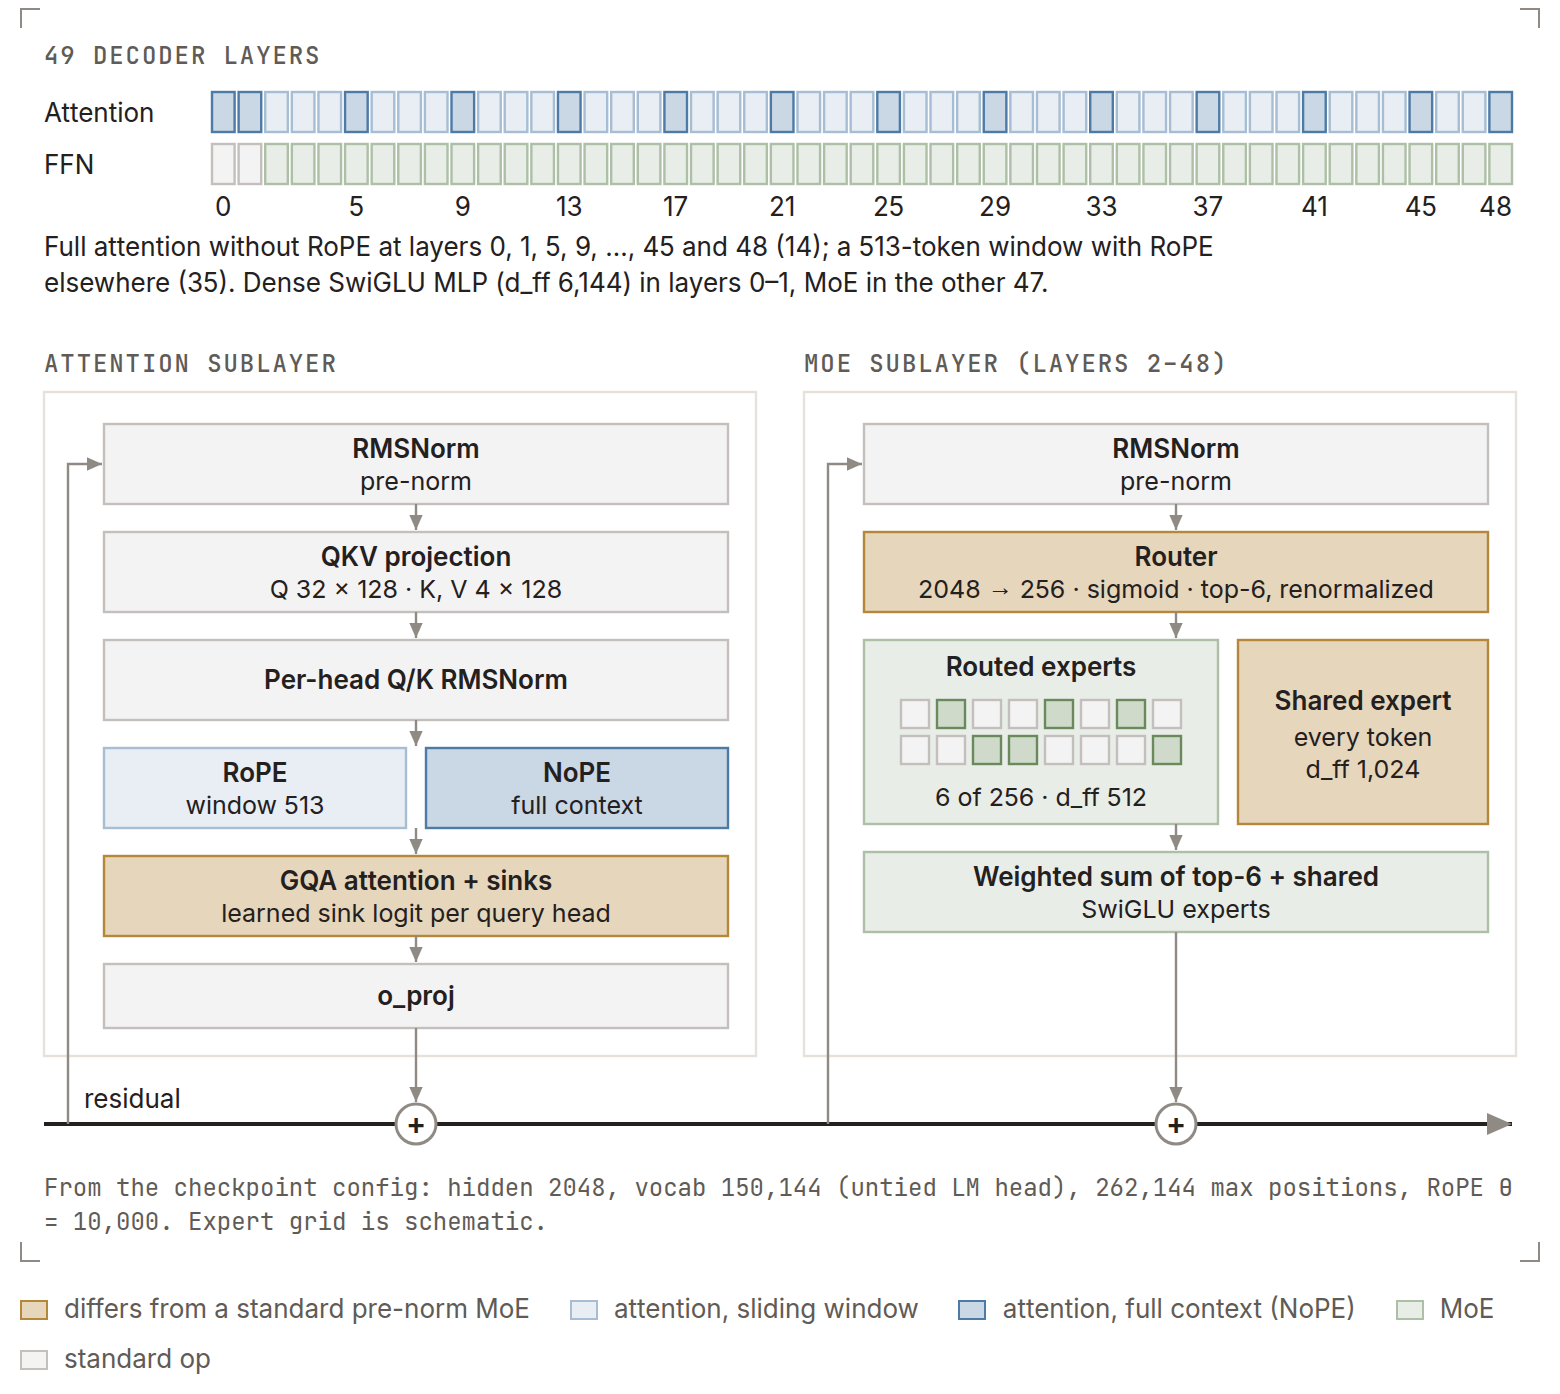
上方标出全局与窗口注意力层,下方分别展示注意力和 MoE 子层;多数层只看局部,路由专家之外还有共享专家。
注意力采用 32 个 Query 头、4 个 KV 头的 GQA,并有 per-head Q/K RMSNorm 和可学习 attention sinks。前两层使用 dense MLP,其余层有 256 个路由专家、sigmoid top-6 选择以及共享专家。每 token 只激活少量专家解释了计算稀疏性,但整体权重仍要可被访问;专家读取、路由与启动开销都可能支配小 batch 延迟。
NVFP4 文件与运行时数据类型要分开
模型提供独立 NVFP4 与 BF16 检查点。NVFP4 版本以 GGUF 存储,块内格式与 NVIDIA NVFP4 对应,但字节顺序不同;vLLM 装载时无损重排,然后以 W4A16 运行,激活和 KV cache 保持 BF16。它不是把全部计算与所有缓存压到 4 bit,也不能按权重压缩比估算整个请求显存。
官方强调每个 Flint 专用 kernel 遵循参考实现的舍入点,并在 GSM8K、GPQA-Diamond、长上下文 MRCR 和工具调用套件上对齐准确性。这说明优化同时考虑了数值路径。文章没有逐项给出这些基准分数与误差分布,因此可以说作者报告与参考实现匹配,不能把它延伸为所有提示逐 token 恒等,或任意量化设置都具有同样质量。
从 1,096 次 kernel 启动压到 346 次
最初使用 vLLM 通用层的实现,在小 batch decode 中每步运行 1,096 个 kernels;其中许多面向大 batch 调优。文章逐步替换为 Flint 专用实现,包括把 Q/K norm、RoPE 和 KV 写入融合,把 MoE 路由和专家 GEMV 调整到只读选中专家,以及为小 batch dense GEMV、norm、SiLU 和 attention 选择合适路径。
这里有两个互相补充的方向。融合减少多个小操作之间的启动与中间处理成本;选择专用 GEMV 则让硬件工作匹配“少请求、少活跃专家”的形状。仅仅把参数换成更低精度,不会自动消除 kernel 启动或不合适形状的成本。优化后的完整前向需要 346 个 kernels,仍然是多阶段流水,而非一个巨型内核完成所有工作。
对于最多 8 个请求,低延迟路径把每个 MoE 层组织为 7 个 kernels,将 Q/K norm、RoPE、路由和专家合并融入相邻 GEMV。programmatic dependent launch 允许后续 kernel 在前一个仍运行时提前加载权重。这个收益依赖具体架构与依赖关系,并不意味着绕过数据依赖;只有准备工作可以提前。
1.78 ms 前向,不等于 1.78 ms 完整输出
官方给出的基准条件是单 GB200、batch 1、100K 上下文 decode,prefill 单独使用 8,192-token 输入。各项结果如下:
| 测量对象 | 初始实现 | 优化后 | 加速 |
|---|---|---|---|
| NVFP4 decode 模型前向 | 4.81 ms | 1.78 ms | 约 2.7× |
| BF16 decode 模型前向 | 3.53 ms | 2.34 ms | 约 1.5× |
| 8K-token prefill | 207 ms | 145 ms | 约 1.4× |
这些是逐步优化后的累计结果,原文列出的各阶段百分比不宜简单相加。更接近用户感受的是端到端 served decode:同样 batch 1、100K 上下文,约 2.06 ms/token,即 485 tokens/s,额外包含 LM head 和 sampling。文章开头的“约 500 tokens/s”是这个数量级的概括,并非模型前向倒数的另一项独立实测。
对交互系统,TTFT 与后续 token 延迟也需要分开。8K prefill 的 145 ms 不能替代 100K prompt 的首 token 时间,单请求 decode 的 485 tokens/s 也不能推导高并发总吞吐。本文最有价值的证据,是在一个明确硬件与形状上定位并减少开销,而不是给所有部署提供统一速度。
兼容性不仅是权重能加载
Flint 输出 GLM-4.7 风格的工具调用和 thinking blocks,因此官方接入使用 glm47 工具与推理解析器;当 tool_choice 为 none 时,排除工具定义的设置用于匹配参考提示构造。若协议层解析不一致,即使 token 生成很快,也可能无法得到应用预期的结构化工具响应。
文章默认采样为 temperature 1.0、top-p 0.95、top-k 20,并提醒 reasoning 计入 max_tokens,困难任务建议至少给 32K 预算。这个预算是输出限制的一部分,不是额外免费空间;相同最终回答长度也可能对应不同推理开销。比较服务延迟或成本时,应保留这些条件。
当前专用 kernels 面向单 Blackwell GPU、TP=1 与 BF16 KV;其他配置回退到 vLLM 通用层。因此“支持运行”和“走已优化快速路径”是两个层次。首日文章还将主线支持描述为正在合入,阅读时应使用它明确对应的镜像或代码版本,而不能假设任意现有安装都包含同一实现。
这项工作的进展在于,把混合注意力、稀疏专家和低比特权重的架构特征落实到小 batch 执行路径,并报告前向与端到端的差别。优先读架构图和逐步优化分解,才能判断速度来自模型设计、数据布局还是启动开销,也才能识别它迁移到其他硬件、并发和长上下文条件时仍待回答的问题。
用一个缓存估算理解长上下文代价
仅按文章的全历史增长项估算,100,000 个 token 乘以 28 KiB,约为 2.67 GiB。这是十进制 token 数下的算术示例,不是该模型实测总显存;它没有加入窗口层、权重和临时空间。示例说明混合注意力怎样改变增长斜率,也说明长上下文容量与服务并发需要分别核算。若多条请求没有共享缓存,这部分状态需求还会随请求数增加。
低延迟设计同样有形状依赖。小 batch 的瓶颈可能是权重读取和频繁启动;batch 增大后,矩阵运算复用、专家分布和排队时间都会变化,专门为单请求省下的步骤不一定按相同比例改善吞吐。文章把最多八请求的路径单独描述,是理解结果边界的重要线索。
还有一个容易被“首日支持”遮住的层面:模型算子、采样器、工具解析与提示模板共同组成可用服务。数值测试只能回答其中一部分问题。对有工具调用的应用,输出是否被正确解析、是否按预期结束,也会决定一次任务的实际延迟与成功率。官方文章没有给出这些端到端任务指标,所以它提供的是服务实现的速度证据,而不是完整智能体任务质量报告。