vLLM 这次 DeepSeek-V4.1-Flash 优化最值得看的,是从单节点走向整机架时瓶颈如何移动。模型的 KV 很小,decode 的主要成本转向 MoE 权重读取;扩大专家并行后,CPU 调度、请求接纳和 KV 传输又可能抵消 GPU 上的收益。文章把这些变化逐项拆开,比单一吞吐数字更有工程价值。
原文:Serving DeepSeek-V4.1-Flash at Scale: vLLM Matches DeepInfer and Scales to GB300 NVL72
Inferact and the vLLM Team · 2026-10-23
先弄清吞吐到底数了什么
作者报告,在 GB300 NVL72 上采用 prefill/decode 分离与 Wide-EP,AgentX 达到每 GPU 954K tokens/s,对应每用户 P90 196 tokens/s。这个总量包含缓存命中的输入、未命中的输入和输出。它衡量工作负载被服务的 token 规模,不能读成每 GPU 每秒新生成 954K token。
7.9 倍比较的是团队此前的单节点聚合部署,也不是对 DeepInfer 的倍数优势。另一个 826 tokens/s 结果来自四张 B300、并发 1 的专用低延迟路径,原文为用户 P90,不能与整机架高吞吐配置拼成一个同时成立的服务点。两种结果分别展示容量和低并发体验。
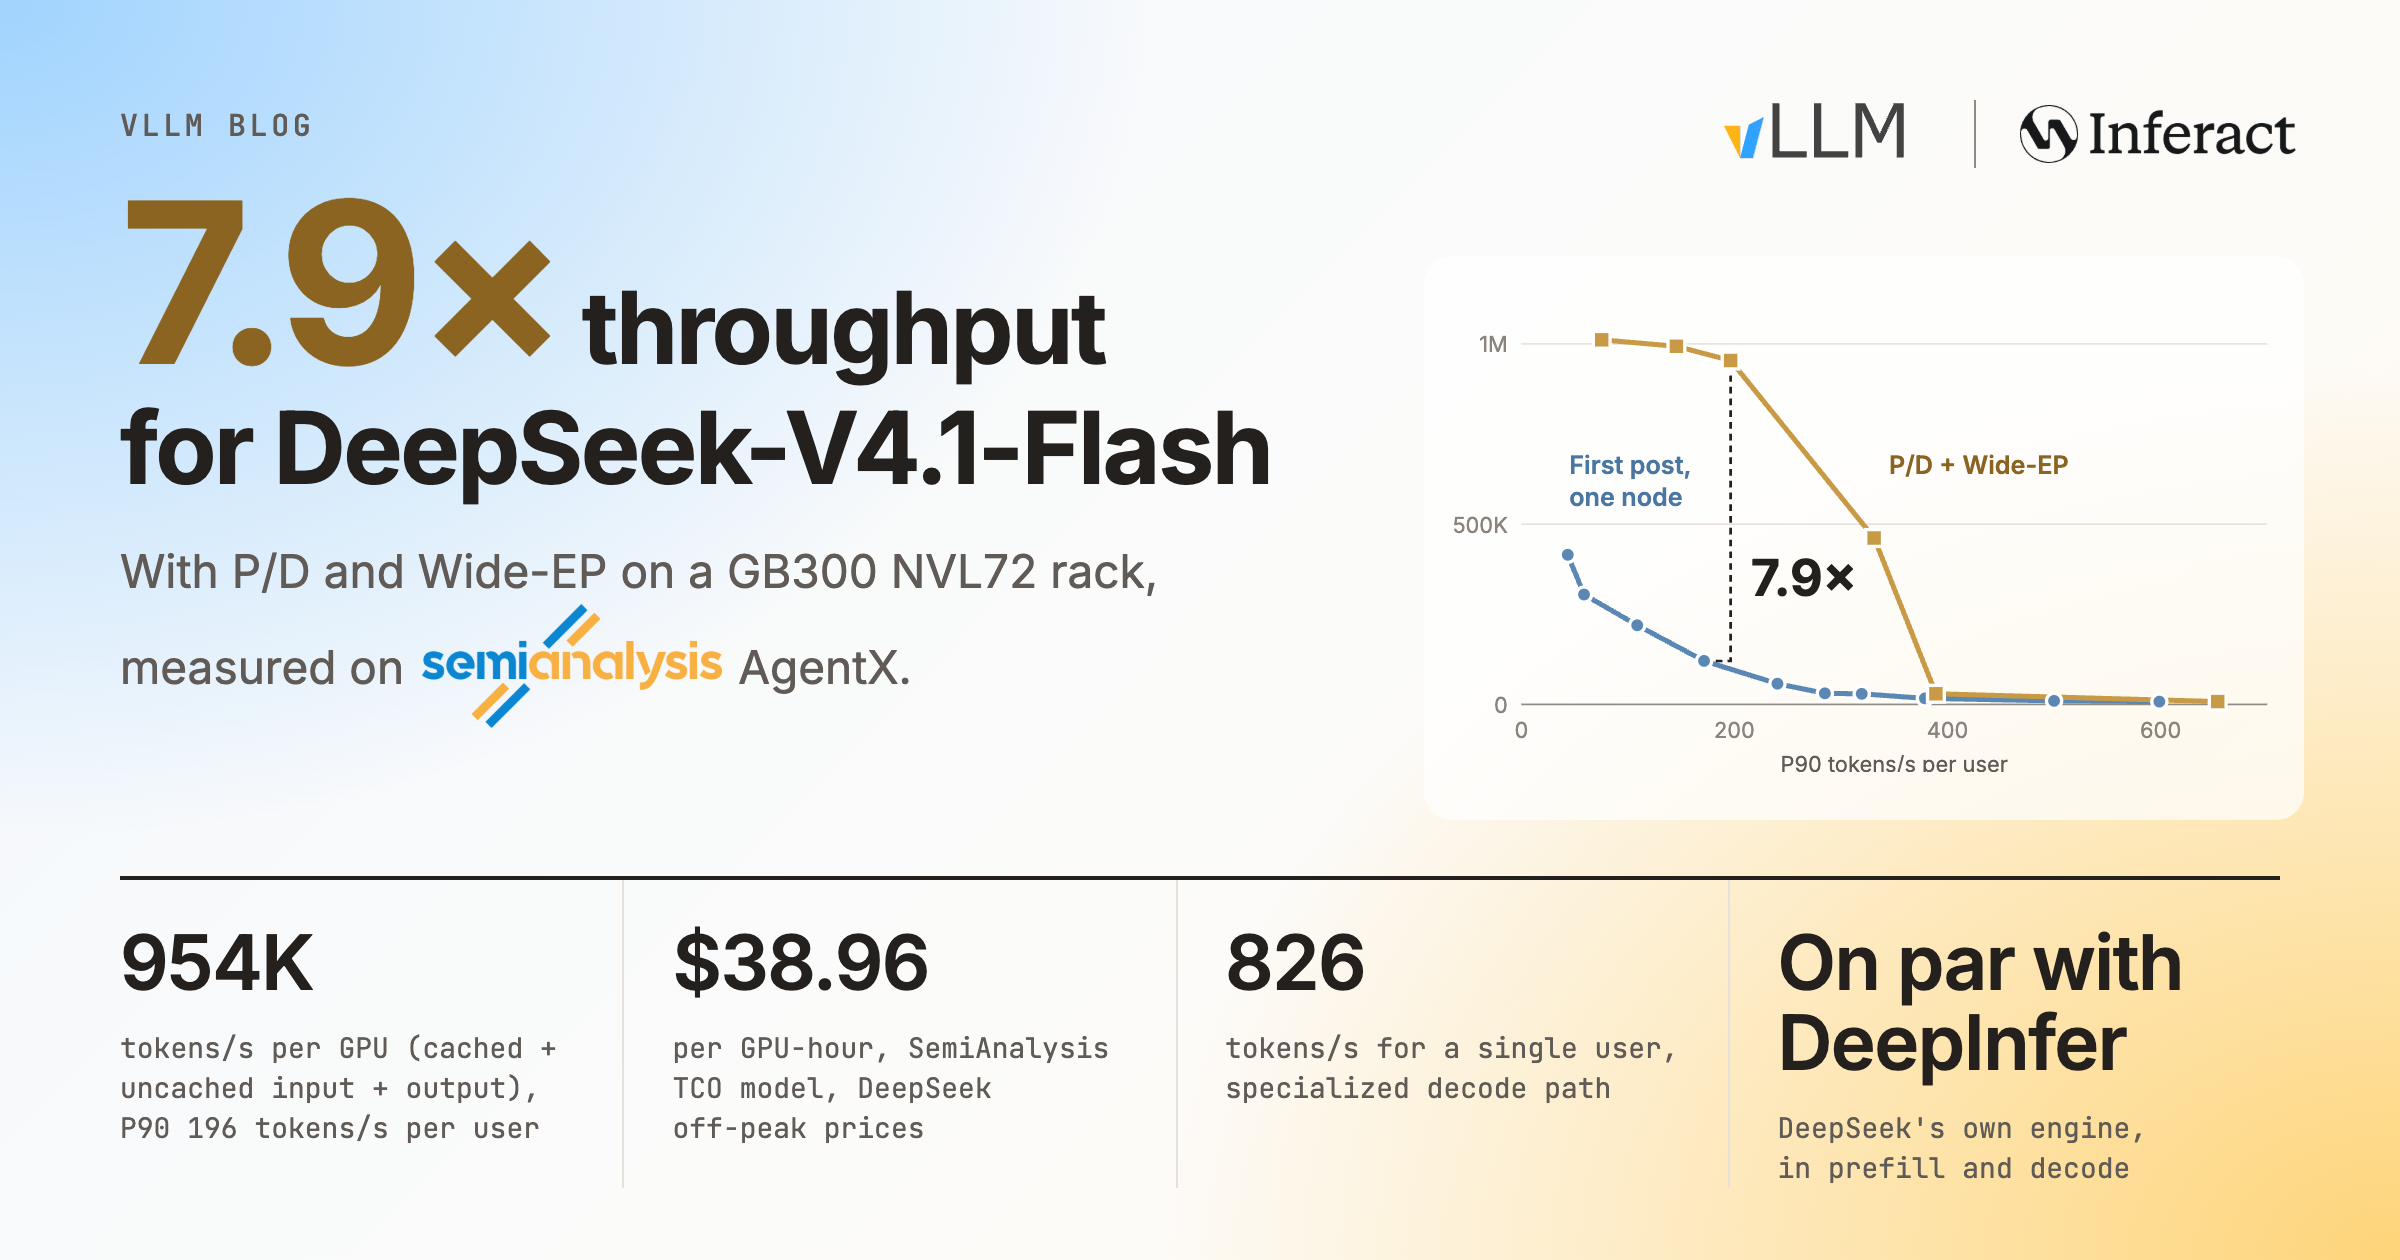
总 token 吞吐、单用户速度和 DeepInfer 对比属于不同测量;左下明确总量包含缓存输入。
与 DeepInfer 的 decode 对照在 GB200、131K 上下文、nextn=3、batch 8–256 条件下,与其公开曲线差距在 6% 内。Prefill 对照更不对称:DeepInfer 的图未标硬件,使用 EP4DP4、32 个冗余专家和 140-token replay;vLLM 用 GB300 DEP2、无冗余专家及 128-token replay,提示也不同。原文只说曲线接近,不把差值当作严格引擎加速比。
为什么 prefill 小规模,decode 大规模
DEP 表示数据并行注意力加专家并行。该模型跨层共享与 FP4 压缩后,全局 KV 每 token 约 890 字节;后段层采用有界 replay,且长上下文增加对目标 forward 时间的影响较小。GB300 DEP32、每 rank 16 请求、每请求 6 token 时,上下文从 128K 增到 855K,目标 forward 从 8.93 ms 到 9.53 ms。这个表只测目标模型,不包含完整服务路径。
因此 prefill 不必为了容纳 KV 一味扩大实例。AgentX prefill-only、并发 256 时,DEP2 每 GPU 64.4K tokens/s,DEP4 为 53.3K。镜像请求与错峰重放进一步显示,DEP4 更容易受 DP 不均衡影响。规模增大带来更多资源,也增加各 rank 等待和协同的成本。
Decode 则受专家权重读取支配。在 128K 上下文、每 GPU 64 请求的扩展实验中,DEP4 到 DEP32 将目标 MegaMoE 时间从 13.4 ms 降至 6.0 ms,其余工作仍约 10 ms。收益逐渐递减,草稿通信也开始抵消继续扩展的好处。这说明应分别为两个阶段选择并行规模,而不是统一配置。
GPU 优化与专家均衡怎样协同
Prefill 的三项改动分别处理多余计算、地址转换和候选排序:将第 20 层 replay 的非 KV 写入工作限制到最后 128 token;Engram 主机表改用支持 2 MB GPU 页的分配,减少 TLB miss;索引器使用 DeepSelect top-k。在 128K 缓存前缀、32K 新 token 条件下,三项组合使新 token 吞吐提高 42.5%。分项数字来自逐步叠加,不能简单相加。
Wide-EP 也需要 EPLB,否则最忙 rank 决定整个实例步时。作者每 3,000 步根据前 1,000 步负载重排专家,目标均衡度由 0.35 到 0.94,草稿由 0.21 到 0.89。均衡度定义为平均 rank 负载除以最大负载,接近 1 表示更均匀。目标与 DSpark 草稿的专家数和路由不同,因此分别记录负载和布局。
这里的启示是,草稿并非总成本中的小尾巴。若只均衡目标,草稿仍可能卡住下一步;若扩大并行缩短 GPU 执行,CPU 的可隐藏时间也同时缩短。优化需要沿完整执行循环追踪,而非仅看某个专家 kernel。
机架规模为什么暴露 CPU 开销
未优化的 DEP32 步时为 17.57 ms,比 DEP16 的 13.84 ms 更慢,尽管 GPU 执行快了 1.1 ms。同步层数与 rank 数增加后,一个慢 CPU 就可能让所有 GPU 等待。作者相应处理同步 KV 读取、Gloo all-reduce、集中接纳突发请求,以及随提示长度增长的主机处理。
这些修复分别改变了传输方向、CPU 集体通信算法、每步允许的新 KV load 数量和提示表示。效果表的行来自不同配置,不能把它们相乘当作单一配置总收益。一个代表性微基准是 855K 提示的接纳 CPU 时间从 38.8 ms 降到 6.0 ms,直接说明长提示即使缓存命中也仍有主机成本。
文章展示了通用服务栈吸收模型专用 kernel 后的潜力。更值得迁移的是测量方法:分开 GPU forward、引擎 decode、专家不均衡和请求接纳,再解释最终 AgentX 曲线。模型架构、GPU 互联、缓存比例与并发改变时,瓶颈也会改变;954K 和 826 应保留各自条件,不能作为任意部署的容量承诺。
用受控重放定位规模损失
文章的 mirror 与 lag 实验值得单独理解。Mirror 让每个 DP rank 同时收到相同请求,lag 则让 rank 按序每次错开五秒收到同样工作。总任务保持相同,主要变化是不同 rank 是否同步忙碌。关闭前缀缓存后,DEP2 实例吞吐从 138.7K 到 130.5K,损失 5.9%;DEP4 从 267.6K 到 231.1K,损失 13.6%。这比拿两段随机 Agent 流量直接比较,更容易把损失归到负载不齐。
专家侧又用了另一种对照:同样 decode batch 下,将真实路由与均匀随机路由比较。均匀路由本身仍有采样波动,在 DEP32、每 GPU 72 请求时,目标均衡度约 0.96,草稿约 0.94。因此 EPLB 达到 0.94 和 0.89 已经接近该对照,不应要求所有随机工作负载都达到完美的 1。剩余时间也未必还能靠重排专家消除。
面向低延迟用户时,最优点又不同。四张 B300 的专用路径将并发一时的 P90 速度由 575 提至 826 tokens/s,约提高 44%。小 batch 更在意每步固定成本,高并发更在意资源摊销与整体吞吐;同一个引擎保留多条执行路径,正是承认这两类目标不会自然收敛到一个配置。
这些实验提供了一种可迁移的性能推理顺序:先建立每个阶段应付出的 GPU 成本,再给出负载不齐的对照,最后定位主机与传输造成的差额。尤其是在规模变大却反而变慢时,继续堆叠 kernel 优化可能无法触及根因。服务级测量需要保留队列、接纳和同步等待,才能说明用户真正获得了什么改善。
还有一个与可观测性有关的细节:作者使用实际 execute_model 路径测 GPU forward,再用 DecodeBenchConnector 观察引擎级 decode。两个时间之间的差额不是天然无用的开销,它可能包含请求组织、跨 rank 协调和服务必须承担的状态管理。判断优化价值时,应确认差额下降有没有改变工作负载或省略必要工作,而不只追求两条曲线贴合。
接纳突发尤其值得留意。限制每步新 KV load 数量可以让已有请求更平稳地前进,却也可能改变新请求排队。因而仅看 decode 用户速度不足以证明所有体验改善,完整评价还需同时查看首 token 与等待时间。这里是对调度取舍的分析,原文不同配置中的收益数值并未量化全部排队影响。