本期看点
一次推理请求可能跨过服务引擎、CUDA 和 GPU 通信,而一次训练又会产生大量集合通信记录。TELLER 尝试把前者重新拼成请求级诊断证据;NIXT 则让后者按时间、节点和通信配置查询。两者都关注观测数据如何帮助定位问题,但一个研究推理故障归因,另一个分析训练通信性能,不能把二者的实验结果直接比较。
01 · TELLER:将请求跨层轨迹和日志拼成诊断证据
TELLER: Non-intrusive Cross-Layer Root-Cause Analysis for LLM Inference
Ruilin Xu、Junyi Li、Pengfei Chen、Zongxuan Xie · 2026-08-03 · ASE 2026
推理服务出错时,单独查看日志可能看不到 GPU 上实际执行的操作,原始 profiler 时间线又缺少请求语义。TELLER 的目标是将引擎、前后端、CUDA 调用、kernel 与跨节点通信连起来,让诊断模型看到与同一请求有关的结构和文本。
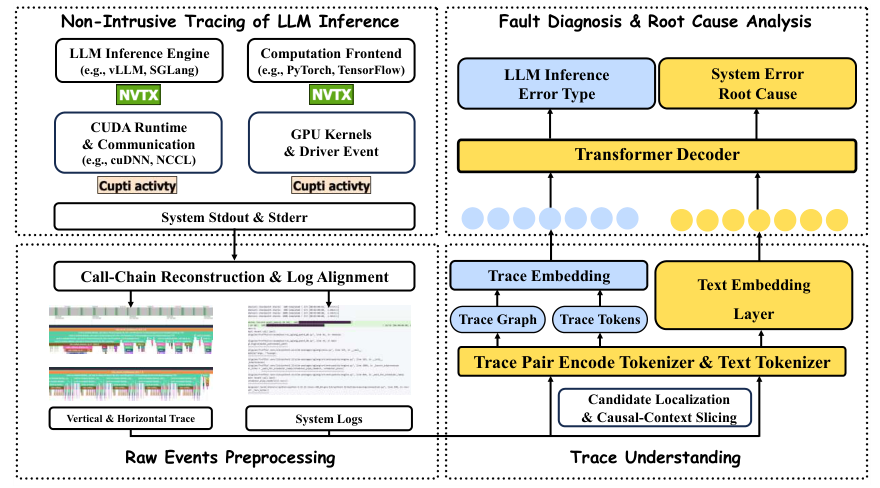
读图:左侧采集并对齐请求轨迹和日志;右侧先截取可疑上下文,再联合编码轨迹与文本,预测故障类型并生成解释。
系统利用 NVTX 和 CUPTI 收集信号,重建请求调用链,并按请求标识或时间窗口对齐日志。它先用数值信息定位候选异常,再保留父子关系、时间顺序和通信关系,提取与候选有关的上下文。Trace Pair Encoding(TPE)将轨迹压缩为结构 token,并保留父节点、深度和时长等属性;解码模型结合日志预测异常与可疑算子,生成自然语言解释。它提供的是缩小排查范围的证据,不是对因果关系的自动证明。
作者构建了 300 条请求轨迹,涉及 SGLang、Torch FSDP 和不同 vLLM 设置,共 2,482 个执行步骤;故障主要由受控注入产生。词表为 256 的 TPE 将平均每步 2,241.92 个事件压缩至 361.43 个,减少 83.88%;进一步压缩虽然更短,却损失诊断效果。联合轨迹与日志的故障类型 macro F1 为 0.476,高于只用其中一种信号的 0.292 和 0.446。
这个结果也有明确边界:训练和测试按请求分开,但同一工作负载或注入活动的相关轨迹仍可能跨集合,因此结果主要反映分布内表现。主实验基于双节点 A40;一次追踪开销测量中,运行时间从 64.77 秒增加至 71.15 秒(9.8%),非侵入式并不意味着零成本。论文还用真实 vLLM 故障案例说明,引擎把新请求误路由到 decode、设备执行相应 kernel 的矛盾,需要跨层证据才能看清;这与受控注入基准的整体准确率应分开理解。
02 · NIXT:把集合通信指标变成可查询的训练观测
NIXT: A NCCL Inspector Exporter Tool for Observability of Collective Communication in Large Model Training
Ziyang Jia、Sirshak Das、Jason Sewall、Laxmi Bhuyan、Pasha Shamis、Daniel Wong · 2026-08-02
NCCL Inspector 能持续报告集合通信统计,但海量逐 rank 记录不容易直接回答“哪个通信器、节点或消息大小出现异常”。NIXT 建立在已有 Inspector 和其 Prometheus 接口之上,新增面向分析的字段分类、结构化存储和可复用查询,而非替代 NCCL 或发明新的通信协议。
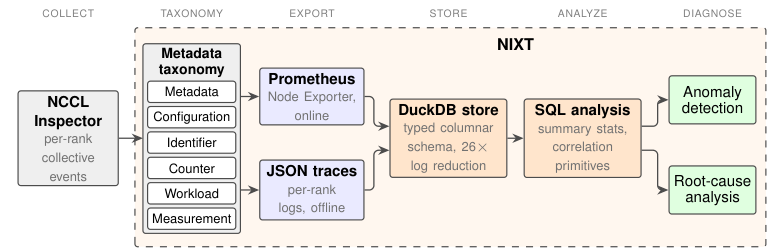
读图:Inspector 记录经在线或离线路径进入列式存储,再按配置、时间和位置查询,辅助异常发现与根因分析。
NIXT 将通信器配置、rank 与主机标识、计数器、工作负载和带宽等测量分开组织,也从记录推导互连类别。分析层通过 SQL 聚合,既能比较不同消息大小和拓扑,也能按节点或时间寻找被平均值掩盖的变化。它提出离线 JSON 和在线 Prometheus 输入;论文中具体的 DuckDB 导入和查询开销测量是事后分析,不能直接当作持续在线分析的完整成本。
作者在 H100 集群上分析 Nemotron-4 15B 和 340B 训练,规模从 16 到 2,048 GPU。340B 的最大轨迹中,17.7 GB 原始 JSON 转为 0.67 GB 存储,导入耗时 56 秒,单项分析查询各低于 0.3 秒;Inspector 本身在所测训练中增加不到 2% 的端到端开销。15B 随数据并行规模扩大,AllGather 通信量增加;固定 2,048 GPU 时,340B 的通信组合更丰富,更多流量经过跨节点网络。它们是特定模型与集群的观测,不证明 NIXT 已自动定位任意故障。