本期看点
本期优先读两项把观测推进到故障内部的工作。IntAct 追问:模型发出的正确工具调用,经过包装器、Shell 和进程接口后,是否还是同一个动作?PonyTail 则追问:慢请求到底走了不同代码、执行了更多循环,还是遇到不同的硬件瓶颈?它们分别补上了调用轨迹和全局热点统计容易遗漏的证据。
两篇的价值都在于缩小诊断单位。前者用接收端解析器定位第一次语义偏差,再选择传输方式;后者把控制流和硬件事件归到单个请求,帮助工程师设计优化。它们也保留了清楚的边界:执行忠实不等于用户目标正确,找到慢请求的特征也不等于自动找到根因。关注 Agent 工具可靠性先读 IntAct,关注服务性能分析先读 PonyTail。
01 · IntAct:先确认工具调用有没有被执行路径改写
Do Tool Calls Execute as Intended? Measuring and Repairing Intent-Execution Correspondence in LLM Agents
Boyang Yang, Zhenhao Li, Ziyao Yang, Kanghui Jia, Xin Yin, Mingmou Liu, Haoye Tian · 首发 2026-10-03
正确的调用,也可能执行成别的动作
工具调用通常要经过序列化、宿主包装器、Shell 解析、进程接口和目标解析器。引号被吞掉、反斜杠被合并、长文本被截断,都可能让程序收到不同参数。若只查看模型发出的文本和最终返回,错误很容易被归到模型,随后重试甚至会把原本正确的调用改坏。
论文把“意图—执行对应性”(IEC)限定为:实际动作是否符合已发出调用在工具契约下的含义。这里的意图不是用户的最终愿望;模型本来就写错的命令仍是生成错误。相较于只检查单层包装器或让模型解释失败轨迹,这项工作的增量是逐跳观察,并按接收端语义比较。
先找第一次偏差,再决定怎么传
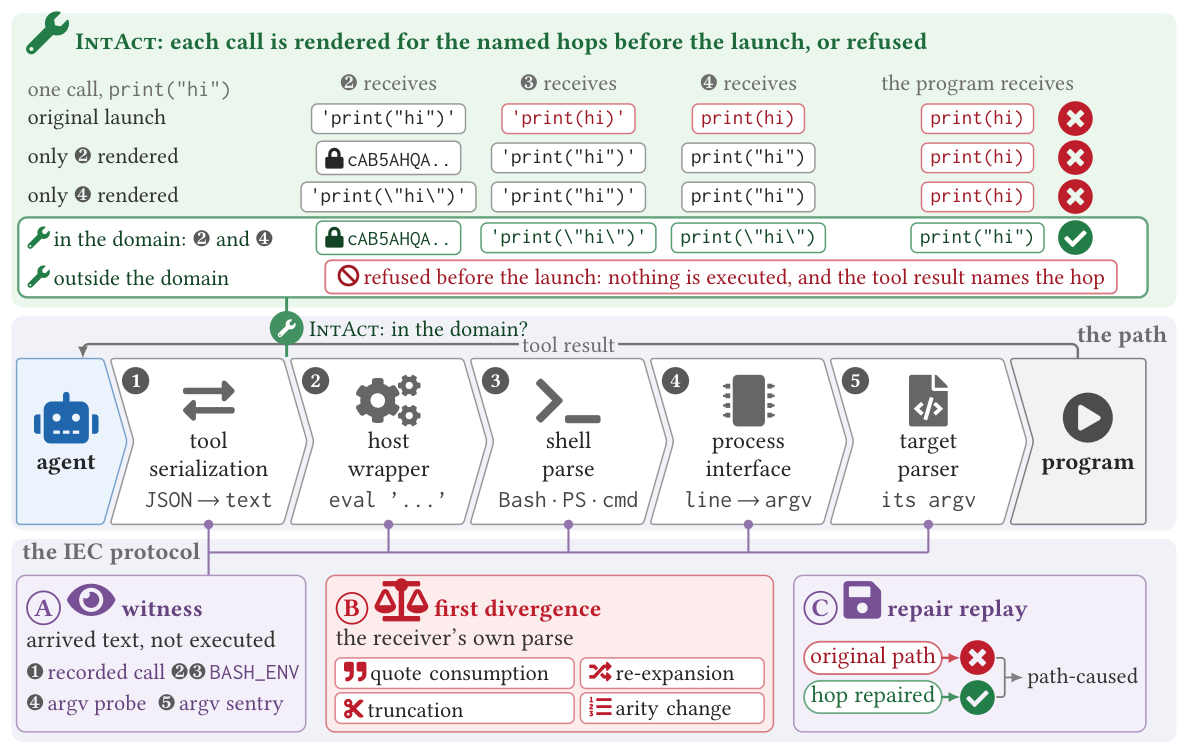
读图:中间是调用经过的五跳;下方依次采集接收证据、定位首次偏差、用修复回放验证归因;上方展示只修一跳可能仍失败,组合修复或拒绝执行才保住调用含义。
IEC 的 witness 保留原有启动路径,以探针代替目标程序,记录收到的文本或参数而不执行原命令。随后用接收端解析器比较动作,避免把字符串不同误当作语义不同;受控修复回放再保持已记录动作不变,只修改定位出的传输环节,检查失败能否消失。
IntAct 接收已识别的路径、问题跳点和调用文本,输出适合该跳的表示,或明确拒绝。Bash 包装器可改用文件传递,PowerShell 路径可能需要先按原生参数规则处理,再编码以绕过包装器的二次解析。若两跳都会改写,单修一跳不够;超出支持范围则拒绝,不能靠更多引号保证成功。
数字要跟着分母读
作者分析的 Windows 生产语料包含 6 位开发者、261 个会话、47,828 次 Shell 调用。其中 Claude Code Bash 的 7,491 次暴露于特定文本风险的调用有 12.0% 被改变,不能写成所有调用的故障率。已运行且反斜杠被改变的 663 次调用中,535 次没有报告错误,即 80.7%。
IEC-Bench 覆盖 67 组模式对、135 条依赖调用链和 46 个跨平台任务。固定原动作回放时,IntAct 恢复了 173 个调用被改变的失败任务对中的 137 个,即 79.2%;另 187 个调用未改变的失败对没有被修好。带模型实验中,按表中各条件合计,原路径每个通过任务消耗的 token 是 IntAct 路径的 2.4 倍,不能直接解释成总费用下降相同比例。
阅读判断:值得精读的执行契约研究。 发布形态的新增调用开销为 2.1–396 ms,取决于集成方式,不能只引用最快值。方法依赖具体 Shell、启动方式和可支持的语法,不保证模型选对工具或满足用户目标。优先看对应性定义、逐跳修复和固定动作对照;作者发布的实现入口可供继续追踪,本文未安装或运行。
02 · PonyTail:沿着慢请求寻找代码与硬件原因
PonyTail: Profiling and Improving Service Tail Latency
Roee Wodislawski, Adam Morrison · 首发 2026-10-03
调度之外,慢请求自身也值得优化
响应时间包括排队与实际服务时间。当调度已经接近适合当前分布的策略时,进一步缩短尾延迟需要看请求本身为何慢。传统热点分析按全程序累计时间排序,罕见的尾部行为容易被淹没;PonyTail 因而按请求分组,对比慢请求和普通请求的代码与硬件足迹。
它区分三类原因:执行了不同静态代码;执行相同代码,但循环次数等动态行为不同;代码行为相似,却遇到不同微架构瓶颈。这是一套辅助人工分析的方法和工具,不是自动修复器,也不是替代调度的策略。
把低层事件重新归到请求
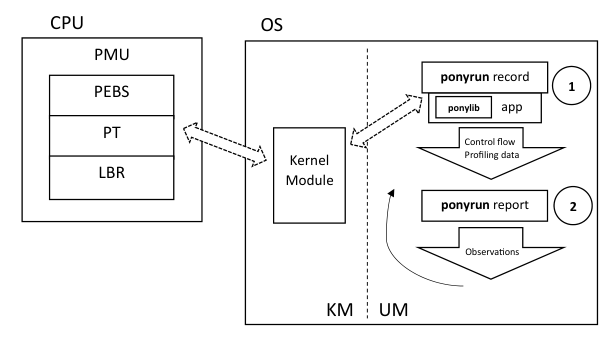
读图:左侧 CPU 的跟踪和采样数据经过内核进入记录工具;应用中的 ponylib 标记请求边界;下方报告工具将数据转成可用于分析的观测。
应用通过 ponylib 标记请求开始、结束,以及服务内部调度导致的暂停和恢复。ponyrun 基于 Linux perf 记录 Intel PT 控制流、PEBS 事件样本或性能计数器,再把数据按请求活动区间拆开。输出包括按服务时间排序的动态基本块热图、流水线使用分解,以及代码块执行次数或时间与请求耗时的相关性。
工程师先看慢请求是否形成独特分组,再只对这组做热点分析;若问题是同一循环执行更多次,就继续追查循环和输入的关系。相关性提供排查方向,仍要结合源码和修改后的测量验证原因。
案例展示的是不同优化机会
作者在 Intel Xeon Gold 6442Y 上分析五个 TailBench 服务。实验采用单工作线程、FCFS 队列、客户端与服务合并的配置,关闭动态频率和超线程,固定核心;报告时间取三次运行平均。
Silo 的极慢请求暴露了周期性内存回收:将回收频率提高五倍,使每次处理的积压更少。在 32% 负载下,最大服务时间改善 4.3 倍,但 p99 仅改善 1%。这说明修掉最远尾部不一定显著改变 p99,必须保留百分位条件。
Xapian 的分析发现,文档查询在块内部查找比定位块更费时。将数据库块从 2 KB 缩到 1 KB,平均与尾部服务时间约下降 30%;再结合微架构优化,完整方案在 87% 负载、1,200 RPS 下,使平均和 p99 响应时间分别改善 5.3 倍、4.6 倍。较大的响应收益包含排队效应,不能当成每条查询的计算加速。
诊断收益需要付出采集与分析成本
追踪与采样在所测三个服务上的平均服务时间几何平均增幅分别为 16.5%、13.7%;采样条件是每 100 K 周期一次。追踪离线分析每一秒单核服务执行需约 4.5–6 分钟,峰值虚拟内存可达数百 GB。原型面向 C/C++,不支持 JIT 或自修改代码,不适合常开部署。
阅读判断:有具体案例支撑的性能诊断方法。 先读请求级分组和案例,再看采集代价。其现实意义是帮助解释尾部,而非承诺一套通用优化。论文前面的理想服务器模拟与后面的实际案例也应分开:模拟展示潜力,案例才验证具体修改在特定负载下的效果。
同批观点:把结果指标和执行证据一起看
Camila(@AiCamila_)原帖发表于 2026-10-02 16:12 UTC,即北京时间 10 月 3 日 00:12。帖子建议联合观察结果、延迟、成本、可靠性、质量与饱和度六组指标;它是一份实践检查清单,没有提供对照实验。
与两篇论文合看,这条提醒适合作为仪表盘的入口:指标提示结果有没有改善,逐跳证据和请求级分析帮助解释为什么。两种证据互补,但帖子本身并不验证 IntAct 或 PonyTail 的效果。本节保留文字概括,不以社交配图代替方法证据。