本期看点
本期值得优先读两项关于“协调”的工作。vLLM-Omni 把文本、语音与扩散生成拆成独立阶段,用共同的控制面处理推进、取消和输出;动态并发研究则追问,编码 Agent 自行分工以后,更多执行者能否换来更完整的软件。前者给出可检查的运行时设计,后者用配对实验展示并行收益与交付风险,适合连起来理解系统瓶颈怎样跨组件移动。
另外三篇分别关注测量稳定性、诊断证据和审查有效性:推理速度要能重复测量,外部结果要能绑定到实际运行版本,第二个模型的意见也要经过完整输入和退出状态检查。它们把可靠性的讨论推进到具体执行记录,而不只停留在最终分数。
01 · vLLM-Omni:把多模态生成接入同一套调度
vLLM-Omni Technical Report: A Unified Serving Runtime for Omni-Modality Generation
vLLM-Omni Team · arXiv · 2026-10-07
用阶段边界承接不同生成方式
语音助手可能先推理、再产生语音码、最后合成波形;图像模型则要迭代去噪。它们的调度假设不同,把所有工作塞进一个解码循环很困难,分别搭服务器又容易重复实现路由、流式输出和取消。vLLM-Omni 的增量,是在专用引擎之上统一请求生命周期,而让阶段内部保留各自的计算方式。
一个 stage 绑定模型组件、执行引擎和资源预算。请求从 AsyncOmni 进入,orchestrator 决定下一阶段、目标副本,以及结果该交给用户还是下游;token 调度、KV 管理和去噪仍由引擎负责。重张量由 OmniConnector 传输,控制队列只带轻量元数据,避免所有数据都挤过调度进程。
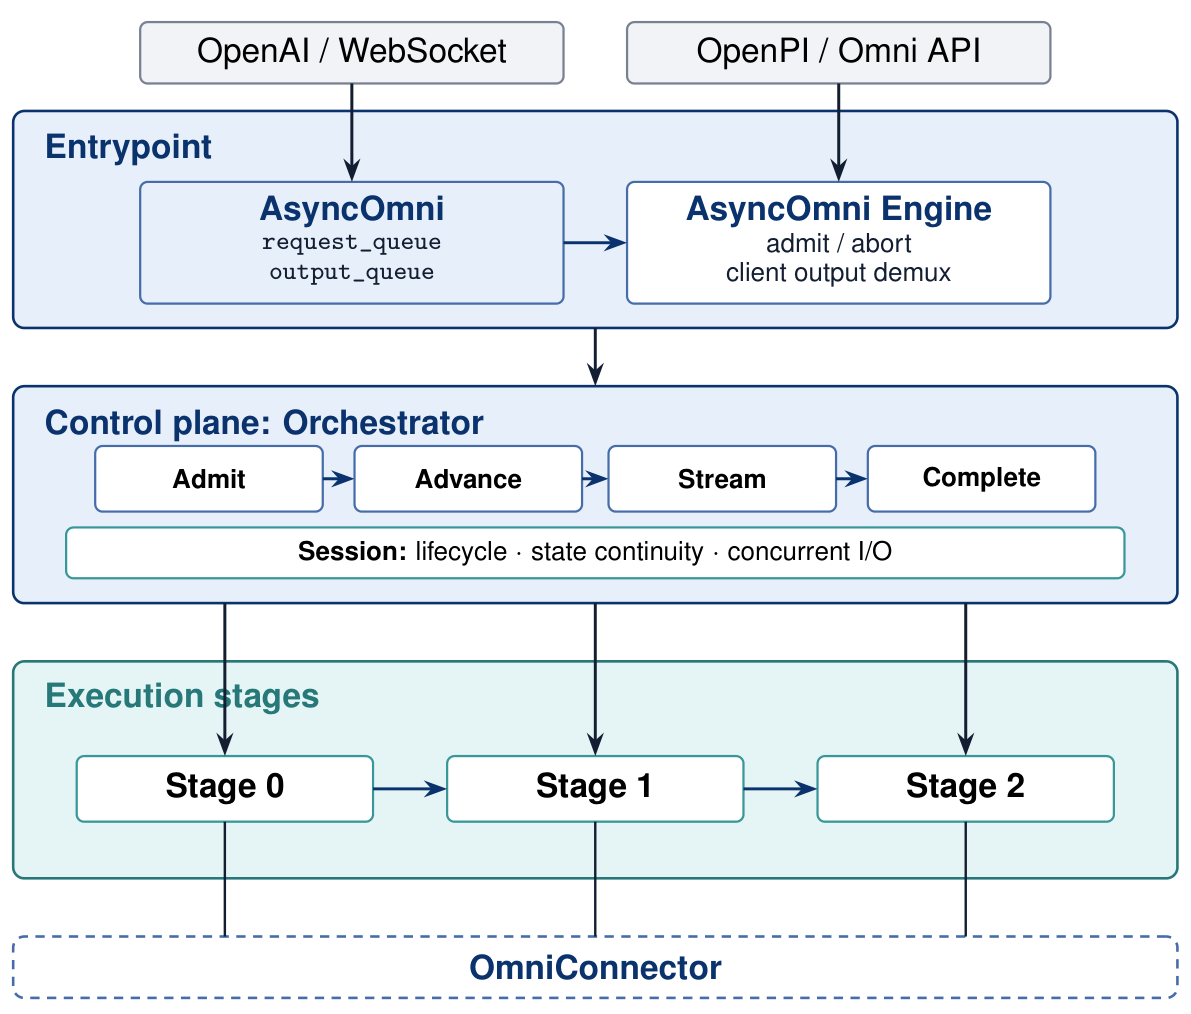
读图:从入口向下看请求推进;阶段之间传递生成状态,底部连接器承担数据搬运,控制面保留生命周期管理。
尽早启动下游,也要保留状态归属
以 Qwen3-Omni 的 thinker→talker→code2wav 为例,开启 async_chunk 后,下游先收到占位请求,随后随语音码分块到达而开始解码,和上游生成重叠。边可以选择分块或完整负载传输,并非所有模型都适合相同粒度。阶段池还能独立增加副本;已有请求维持副本亲和性,使后续流式片段和阶段内缓存落在原处。
连接器处理隐藏状态、语音码、latent 和 KV 等不同负载,具体语义由其上层管理。长寿命会话则在相同控制面上补充状态连续性和并发输入输出。这种分工的价值,是把“谁推进请求”和“谁执行模型”分开,但它也要求取消、状态清理和跨阶段交接始终一致。
跨阶段 KV 与隐藏状态也不能混为一谈:前者从分页块表导出,需要专门的提取、键管理和目标端安装;后者用来条件化下游生成。共用传输接口只统一搬运,不会自动统一缓存有效性。对运行时设计者,这意味着优化网络路径之外,还要清楚每段状态何时可用、属于哪个请求,以及何时才能释放。
性能改善随负载和瓶颈变化
在两张 H100、Fixed-Len-2500/900、文本加音频输出的测试中,32 并发时,分块将平均端到端时延从 136.62 秒降至 72.63 秒,平均音频实时因子从 0.927 降至 0.630;后者是合成耗时与音频时长的比值。单并发时,端到端时延为 25.07→18.51 秒,说明收益并非固定倍率。
增加下游副本也不保证持续获益。三张 H100、talker/code2wav 各两副本时,32 并发的实时因子为 0.732,反而高于两卡分块配置。作者据此提出上游准入和交接可能成为瓶颈,尚不能据这组数值认定唯一原因。报告另一组 H200 的 MRv2 结果还使用了启动属性访问的一行保护修改,不能与原配置无条件等同。
阅读价值在架构与负载诊断。 优先看控制面、分块传输和并发扫描,而不是把模型支持列表当成普遍加速保证。报告主要依托固定的 nightly 配方,没有给出本版跨框架性能排名;更广泛的会话、闭环机器人和跨硬件评估仍待补齐。
02 · 动态并发:多开子 Agent,收益取决于协调
When Sub-Agents Work in Parallel: The Promises and Pitfalls of Dynamic Concurrency in Long-Horizon Coding Tasks
Han Li, HanHaoNing Li, Ziqian Jiang, Yiling Lou · arXiv · 2026-10-07
比较执行策略,而非固定多 Agent 工作流
动态并发允许主 Agent 在运行中决定何时分工、交给谁、如何接回结果。它与预先安排角色和任务图的方式不同:同一道题既可能得到有用的独立实现,也可能产生重复调查、接口遗漏和共享文件冲突。这里的核心问题是,在相同时间预算下,自主分工是否改善最终交付。
作者对 354 个任务进行 2,124 次执行,比较 Codex/GPT-5.4、Claude Code/Claude Opus 5 和 Kimi Code/Kimi K3 开启与关闭原生并发的结果。配对保持模型、提示、环境和时间预算一致;任务覆盖 RepoZero、NL2Repo、ProgramBench、LoopsBench 及短任务对照 SWE-bench Verified,使用分层抽样子集,而非这些榜单的全部任务。
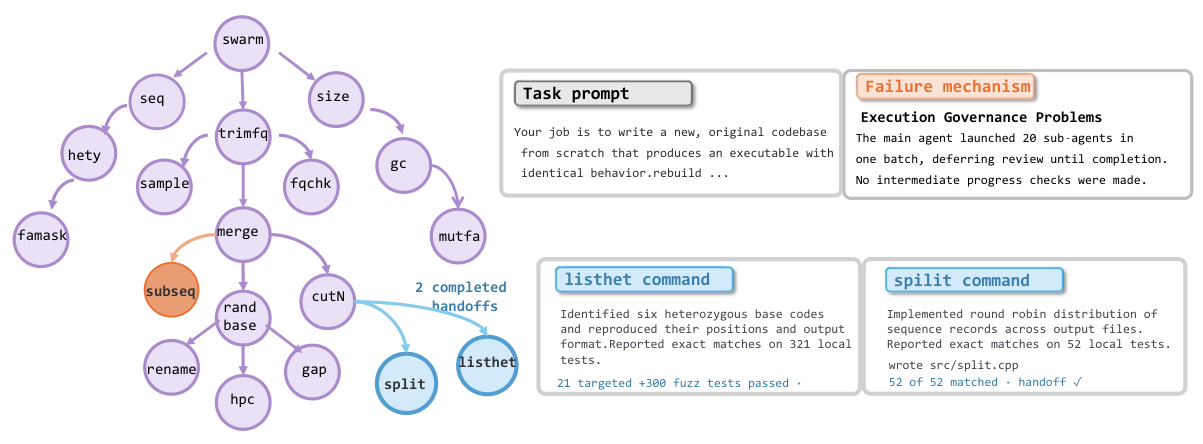
读图:左侧分出多个命令实现任务,右侧展示局部完成证据;只有少数完成交接,主 Agent 的整体等待挤掉了集成验证时间。
越复杂越有机会,但并发不自动缩短工期
在 LoopsBench 中,Claude Code 的任务通过率从 7.1% 升到 21.4%,提高 14.3 个百分点;平均耗时也从 74.8 分钟升到 91.5 分钟。相同 Agent 在 SWE-bench Verified 子集上却从 83.0% 降到 59.0%。Codex 在 NL2Repo 上从 34.6% 升到 57.7%,token 用量从 2.87M 增至 8.00M。收益明显依赖任务和工具,不能从一个增长数字推导出默认开启并发的规则。
作者观察到,按基准平均实现规模排序,长任务上的测试通过率优势总体变大;这是关联,不是把任务加长就能获益的因果保证。ProgramBench 中所有配置的完整任务通过率仍为零,部分测试进步与完成整个程序必须区分。
失败常发生在分工之后
seqtk 案例很具体:40 分钟预算内,主 Agent 到第 17.5 分钟才一次启动 20 个子 Agent,随后以两小时超时假设等待整批返回。两个任务虽然交付了局部测试结果,整体却没进入计划中的集成验证,最终只通过 440 个测试中的 92 个。局部完成报告无法替代最终程序的完整性。
对全部 1,062 条并发轨迹的人工分析得到四大类、13 个子类和28种失败模式;804 个模式实例中,共享状态与合并问题占 33.2%。这个比例的分母是模式实例,不是生产请求。有效案例则体现出互补实现、并行尝试后选择、独立验证三种收益路径,而主 Agent 仍须负责整合与验收。
失败分类采用双人独立标注,先以 50 条轨迹建立编码表,再讨论分歧;报告的一致性 κ 为 0.77。这个过程为案例解释提供支持,但没有把某种失败模式与成功率变化做独立因果实验。尤其是所有 Agent 共用同一类任务预算时,增加子任务可能同时增加验证机会和资源竞争,两种效应需要一起看。
值得读的是调度行为和失败分类。 明确文件归属、共享接口、失败接管及最终检查时间,比单纯提高并发上限更贴近论文证据。结论受原生工具版本、样本和有限重复运行约束,也尚未证明某一种新调度器能够消除这些失败。
03 · Sequential Isolation:让推理回归测试更稳定
Reproducible LLM Inference Benchmarking: A Sequential Isolation Protocol for Regression Testing
Arnold Olympio, Juan Manuel Servera Bondroit, Wael Abdelmalek, Guang Lu, João Carvalho · arXiv · 2026-10-07
推理版本更新带来几毫秒差异时,测量噪声可能掩盖真实回归。作者让测试矩阵逐项运行,每次切换上下文长度才重启服务;每轮先预热 30 秒、轮间间隔 10 秒,单轮内部仍保留并发用户。它控制的是测量生命周期,并非把在线请求改成串行。
单张 A100 80GB、vLLM 0.9.1 上,三个 7–8B 级模型覆盖六种上下文长度和八档并发,每配置重复五次,共 720 轮;输出目标固定为 512 token。最终平均 CV 约 2.2%,最低控制阶段为 15.2%;144 个配置中 113 个低于 3%。CV 针对五次运行的 P50 首 token 时延,不能当成单次请求尾延迟。
这为回归测试提供了参考流程,但逐步叠加控制的实验没有分离各措施的因果贡献。200–500 并发间的时延跃升,也只定位到测试区间,不能把 200 当作通用容量上限。原文没有独立方法图,适合直接阅读协议与局限章节。
04 · OOM-RL II:知道结果,还不等于知道原因
OOM-RL II: Reality Is an Oracle, Not a Debugger Provenance-Constrained Diagnosis in Continually Evolving Agent-Engineered Systems
Kun Liu, Liqun Chen · arXiv · 2026-10-07
真实收益可以证明某段结果发生过,却未必说明是哪版模型或哪项修改造成。作者回顾一个持续演化的交易系统:全年账户收益为 +11.1391%,CSI300 为 −6.0997%,但主要年度规格下 alpha 的 HAC(3) p 值为 0.27526,未达到统计显著。事后选出的弱势区间也不能自动证明某个冻结模型失效。
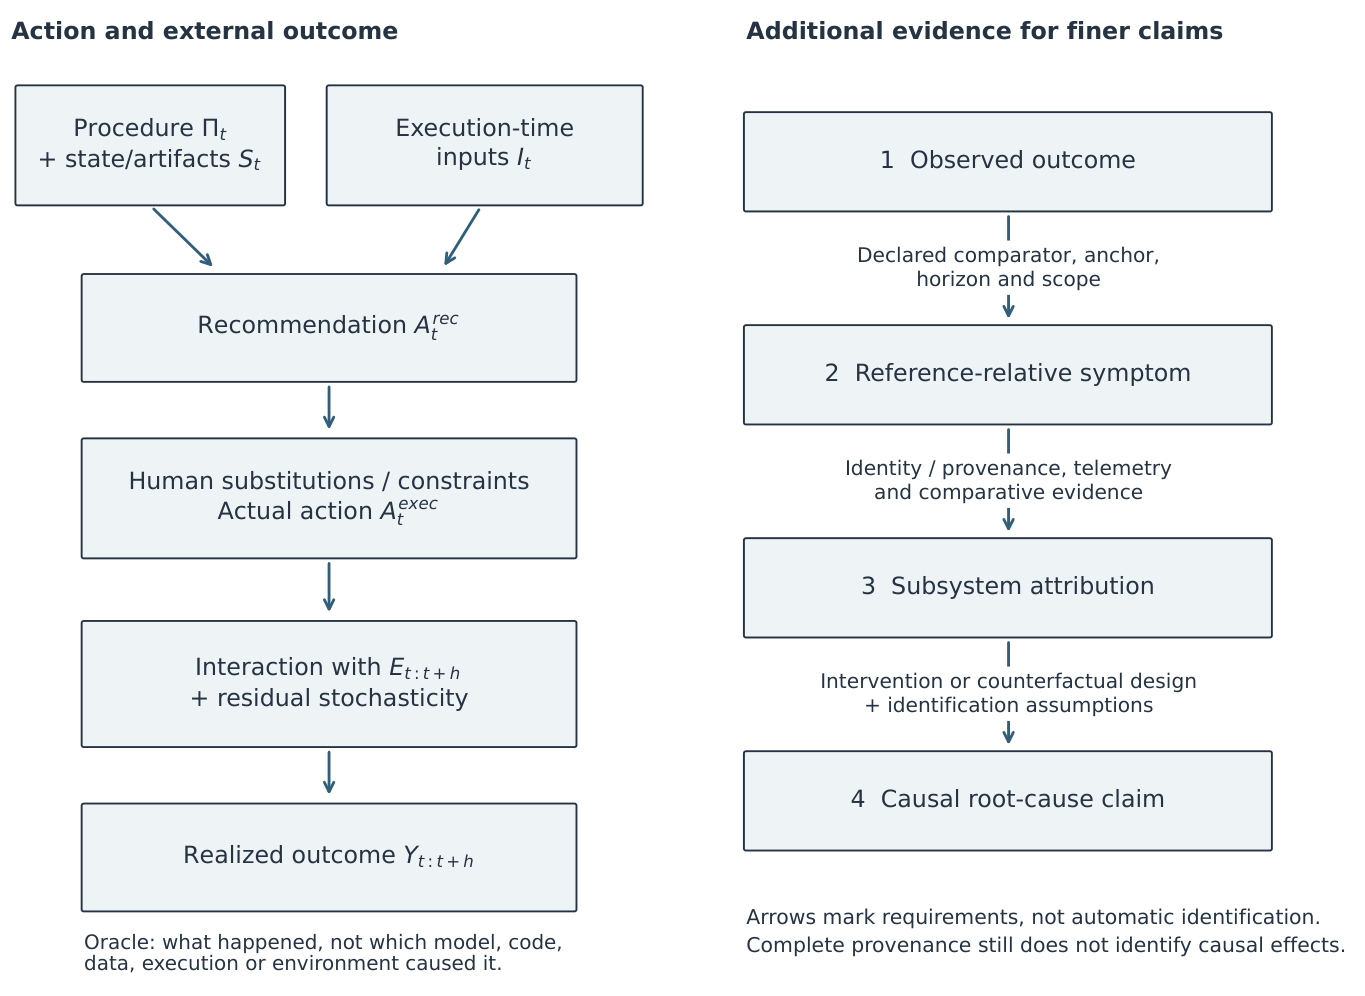
读图:左侧区分模型建议与实际执行;右侧越具体的诊断需要越多识别结构,完整溯源本身仍不等于因果解释。
论文将评估对象分为冻结实例、预先规定的自适应程序和临时开发过程,建议逐次绑定代码、配置、模型、输入、建议与实际行动。重点是让结果能够对应真实运行状态。历史档案缺少完整绑定,新协议也尚未前瞻验证,因此它提供的是诊断证据框架,而非经过验证的自动根因定位方法。
05 · 跨供应商审查:先保证每次审查确实有效
Cross-Provider Review as a Runtime Contract for Coding Agents: A Controlled Pilot and Fault-Injection Study
Bowen Xu, Boyu Chen · arXiv · 2026-10-07
第二个模型返回看似合理的意见,不代表审查有效。论文为跨供应商只读审查提出运行时契约:资源池独立、执行有界、输入完整、输出可用,并保存退出状态和每次尝试的证据。它是主答案交付后的建议,不会自动修正已交付代码。
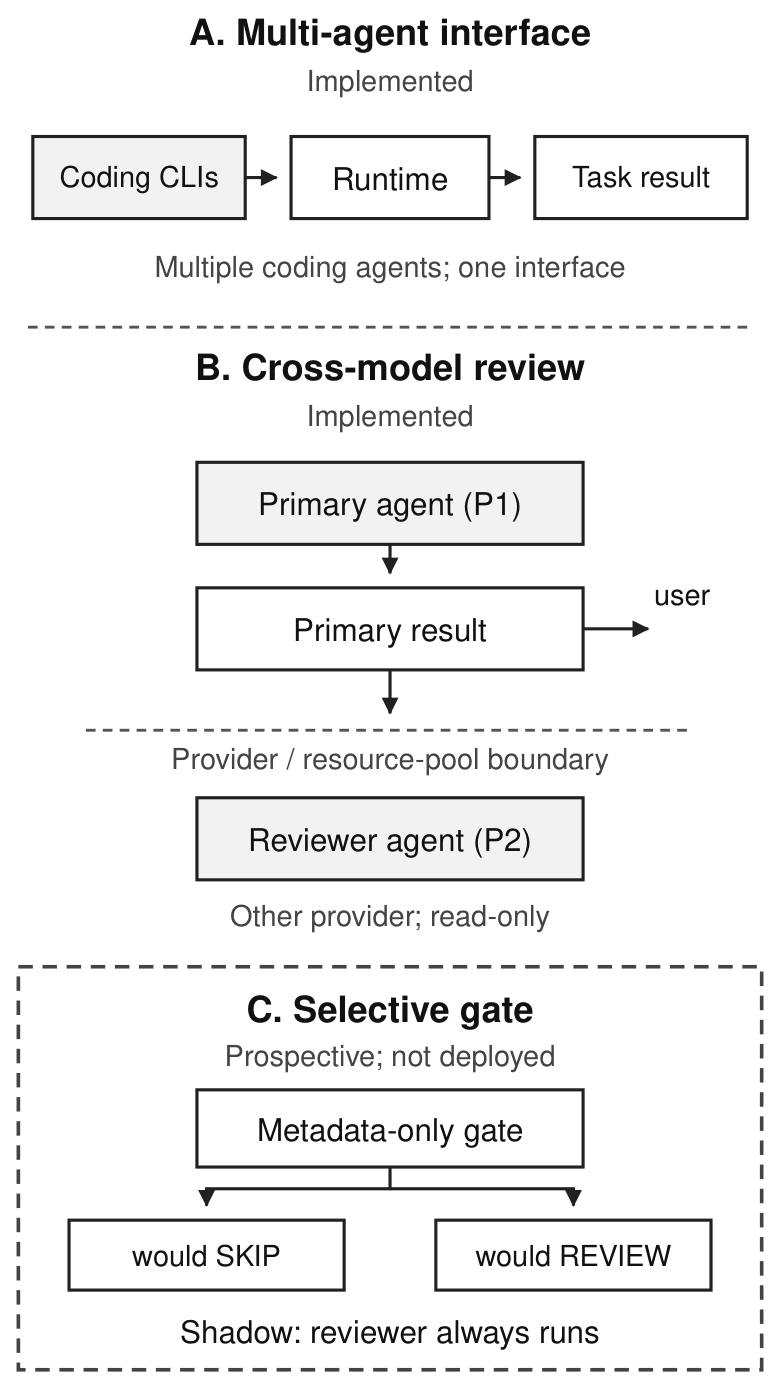
读图:主答案先交付用户,再由另一供应商审查;下方门控仍是前瞻设计,影子评估中每次都执行审查。
20 个配对开发回合中,8 个得到实质意见,95% 精确区间为 19.1–63.9%;任务由 Agent 编写,标签由单一模型裁定,不能据此估计真实用户中的发现率。故障注入揭示了输入截断、回收进程时取消、非零退出却带完整意见仍被算成成功等路径。退出状态漏记还使后续 25 条正式观察无法追溯污染范围,有效测量队列因此重启。最有价值的进展,是把“没发现问题”与“审查失败”区分为可核验的运行事件。
事故响应的另一种证据缺口
ky nichol 的原帖 · @kynichol · 2026-10-07
ky nichol 指出,系统日志记录状态,却往往没有完整记录事故期间人和 Agent 采取了什么行动、顺序如何、哪些奏效。他区分已知故障的脚本化修复与跨团队、跨供应商的重大事故,主张补足控制、执行图、验证和可移植的操作记忆。这是 Cutover 联合创始人的行业观点,不是效果评测;与 OOM-RL II 连读时,值得关注的是行动记录如何支持事后诊断。