本期看点
Agent 的可靠性研究正在细化两个环节:怎样解释一次失败,以及怎样把失败转成有效修改。SSCBench 提醒我们,工具提供过查询入口,不代表 Agent 在作出判断前已经看到反证;SkillMorph 则把执行轨迹、可疑动作和技能文件的修改位置连起来,减少凭一次失败直接重写指导的随意性。这两篇值得优先读,分别帮助理解评测结论和改进机制。
系统侧,IAPRepair 协调故障前的数据修复,Zepp 重新审视 MoE 的均衡目标,ByteExpress 总结 RDMA 的生产部署经验。它们关注的共同问题是:局部优化会怎样改变其他资源的负担。另有 LMCache 安全动态,说明缓存走出单进程后,网络接口本身也成为可靠性边界。
重点解读
01 · SSCBench:先确认反证何时到达,再解释 Agent 的错误
SSCBench: Evaluating the Evidential Validity of Fault-Injection Tests for Tool-Using LLM Agents
Xincheng He、Wanli Dong、Zhaoqiang Guo、Yan Liu、Lei Xu · 首发:2026-10-08
“采信错误”背后有不同的证据条件
设想改签工具返回成功,订单实际上没更新。Agent 随后告诉用户改签完成,确实传播了错误;但若它直到这之后才读回订单,就不能据此说它“明明看到反证仍然坚持错误”。已有故障注入工作常统计错误传播或任务成败,SSCBench 补上的是结论成立所需的观察条件,研究对象是评测证据的有效性。
难点在于,反证不是数据库里存在一个正确值就够了。它必须涉及同一实体、同一状态或逻辑请求,来自足够权威且未被注入同步篡改的信息,并且根据 Agent 可见的语义足以反驳错误。商品记录与订单选项看似冲突,也要先确认记录对应订单中的哪个变体,才能构成有效反证。
从案例可核查,到本次执行真正看见
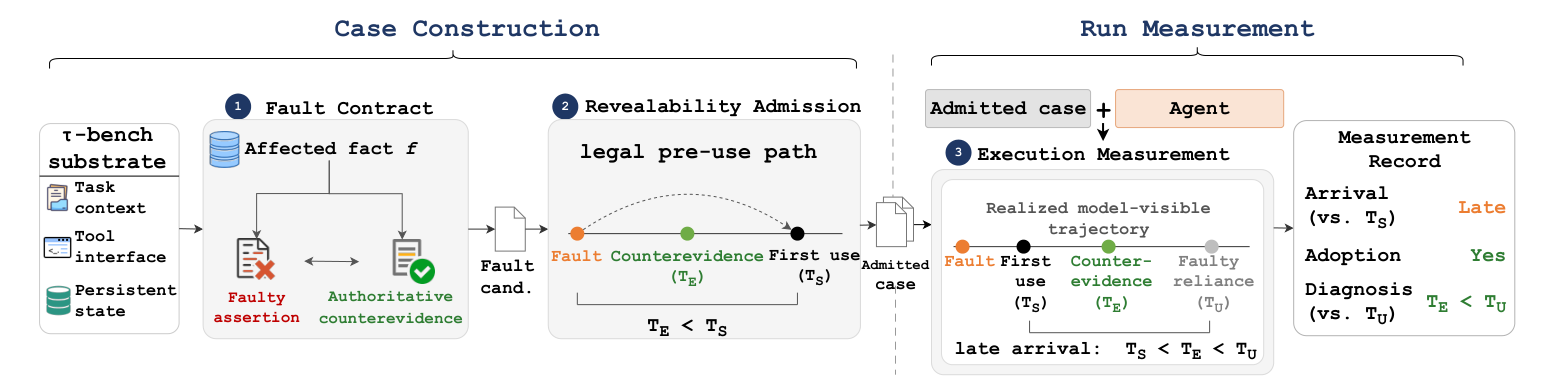
读图:左边定义错误与权威反证,中间确认存在合法的使用前核查路径,右边按实际轨迹记录反证到达、首次使用和首次错误依赖。
方法先为注入建立故障契约,再要求案例存在一条合法延续:沿正常接口和原权限,可以在首次使用受影响事实之前取得反证。这个准入条件只说明“有机会查明”,不能替代逐次运行的观察。测量阶段只从模型可见历史中恢复事件,评测者掌握的隐藏状态不能算 Agent 已知的信息。
随后,作者区分首次使用受影响事实、首次错误依赖,以及反证到达三个时点。首次使用也包括正确或带保留的使用,因此不依赖运行最终是否采信错误。执行被分为使用前到达、使用后到达和观察期内未到达;无法判定的轨迹单独保留,不能混入“没有反证”。输出既有错误采信标签,也有支持它的证据条件和可判定性。
改变的是结论的分母
实验覆盖 τ-bench 的零售和航空场景、四种故障算子、五种 Agent 配置,共 1,191 次故障运行;仅在对应配置先完成干净任务后执行注入。主分析使用每个配置与种子对的首轮运行。在 WriteEffect 的 141 次可评估执行中,101 次采信错误;其中 44 次最终收到反证,只有 17 次在首次使用前收到,27 次在使用后收到,57 次始终未见反证。把 101 次全部描述为“无视已有证据”,就会改变原本测得的现象。
这也解释了为什么不能把后来改口直接叫作修复。停止认可错误陈述、避免首次错误行动、撤销已经发生的外部修改,是不同结果。自动轨迹分析同样需要分别验证采信判断与错误发生位置,找到一个异常步骤未必找到了首次错误依赖。
阅读判断:优先阅读测量协议和按证据到达分层的结果。 这项工作提供了评测解释框架,而不是通用防错器。其结论受两个环境、四种注入语义和人工判读规则约束;按到达条件比较得到的是描述性关系,不能直接推断反证到达的因果效果。对 AgentOps 的价值在于,让“测试失败”与“在何种信息条件下失败”同时成为报告内容。
02 · SkillMorph:从可疑动作追到技能修改位置
Trajectory-Guided Fault Localization for Agent Skill Evolution
Yu Ge、Linna Xie、Zhong Li、Yu Pei、Tian Zhang · 首发:2026-10-08
先找该改哪里,再生成改法
技能文件能保存代码 Agent 的工作经验,也会把缺失条件或不合适的流程反复带进任务。直接把失败轨迹交给模型改写,容易修改表面相关的段落,却留下真正缺失的规则。SkillMorph 借鉴程序故障定位,先识别可疑动作,再追到技能中的编辑位置;基础模型和执行框架保持固定,演化的是指导文件与相关资源。
它没有假设自然语言指令能像代码一样被精确记录覆盖率。Agent 读过整份文件,不表示执行了其中每条要求。因此,方法用轨迹里可见的动作充当中介:既能比较成功与失败运行,又能结合读取记录缩小相关技能的范围。
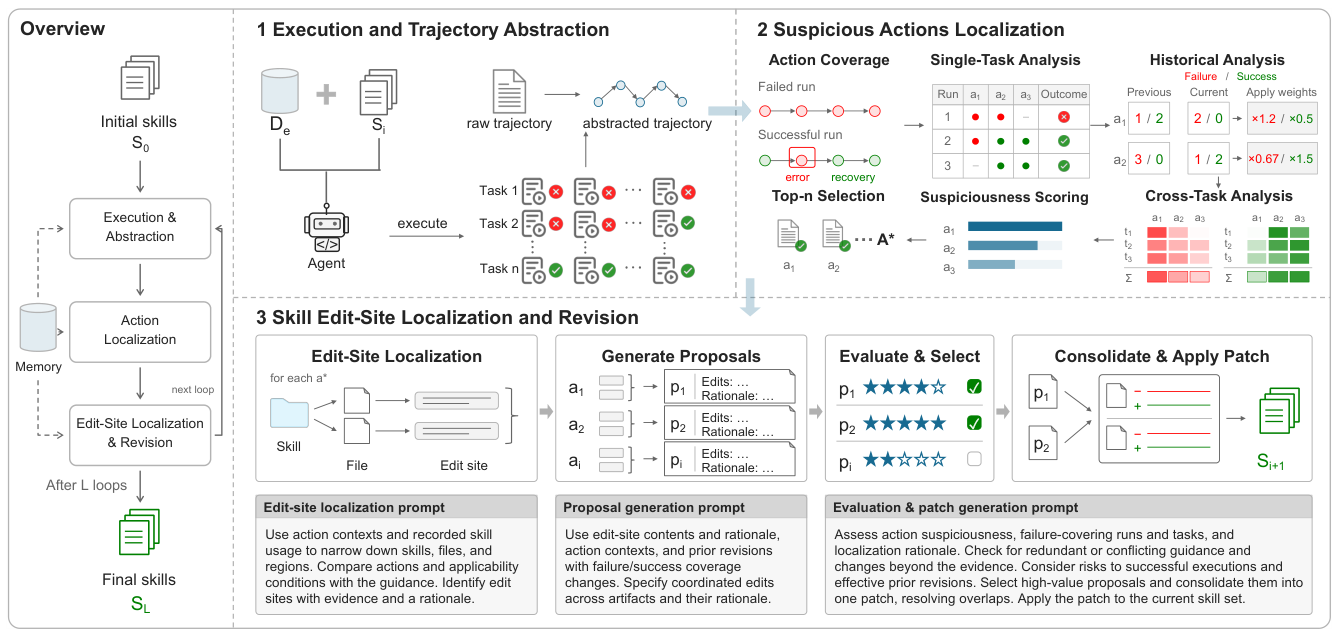
读图:上方把多次运行转成可比较的动作证据,并结合历史与跨任务统计排序;下方从技能、文件逐步定位到编辑位置,筛选提案后合并补丁。
每轮先对任务重复执行,把原始轨迹抽象成“前状态—动作—后状态”。成功轨迹也保留:如果某动作引入错误,只是后来恢复成功,它仍应贡献失败证据,否则最终成功会掩盖额外修复成本。接着比较同一任务不同运行中的成功与失败覆盖,根据前后轮变化调整权重,再跨任务汇总,选出更稳定地关联失败的动作。
定位 Agent 根据动作上下文和已读取的技能,从技能包缩小到文件与行区间,说明指导为什么缺失、冲突或不适用。修改提案可以协调多个文件,筛选时检查重复规则、对成功行为的风险及历史修订,最后合并成补丁。这里的关联仍由模型解释,评分并不构成技能导致失败的因果证明。
收益主要体现在重复执行的一致性
作者使用 Claude Code 搭配 DeepSeek-V4-Flash-0731,任务执行与演化采用同一模型。SWE-Skills-Bench 的 49 个技能各有十个任务,以两个五任务折互换演化与评估,汇总 490 个留出任务。每任务评估三次;pass@3 表示至少成功一次,pass³ 表示三次全成功。
| SWE-Skills-Bench 指标 | 原始技能 | CAP-Evolve | SkillMorph |
|---|---|---|---|
| pass@3 | 82.45% | 92.24% | 95.51% |
| 单次执行准确率 | 75.44% | 89.39% | 92.24% |
| pass³ | 67.96% | 84.90% | 88.37% |
CannBot 的留出集只有 15 个任务,SkillMorph 在其中 14 个上三次都成功;CAP-Evolve 同样至少一次解决 14 个,但三次全成功的是 11 个。不能把小样本上的 93.33% 解读为广泛的内核生成成功率。演化也有成本:每轮对一个 SWE 技能平均约 49 分钟,对 CannBot 约 127 分钟,默认分别执行三轮和五轮。
去掉编辑位置定位后,SWE 的 pass³ 从 88.37% 降至 82.24%,支持“先定位再改写”的设计;不过完整方法仍有任务退化。合作团队接受六个技能修订 PR 是实用性信号,不等于所有新内核都更快。值得精读定位流程、消融与退化统计:这是一种把改进证据变得可追查的方法,迁移到其他模型、任务分布和验证器后能否保持收益仍需检验。
系统研究动态
03 · IAPRepair:让迁移、重建与交换机聚合共同排程
IAPRepair: In-Network Aggregation Enhanced Proactive Repair for Erasure-Coded Storage System
Lei Liu、Yong Wang、Junqi Chen、Yangfan Liang、Qian He、Baokang Zhao · 首发:2026-10-08
纠删码存储预测到节点即将失败时,可以直接迁移,也可以从健康节点重建。两种操作并发,却可能挤满同一批接收端。IAPRepair 按可用带宽归一化负载,联合安排重建供给者、替换节点与迁移任务,再把有限交换机聚合资源分配给最需要减轻接收负担的重建块。
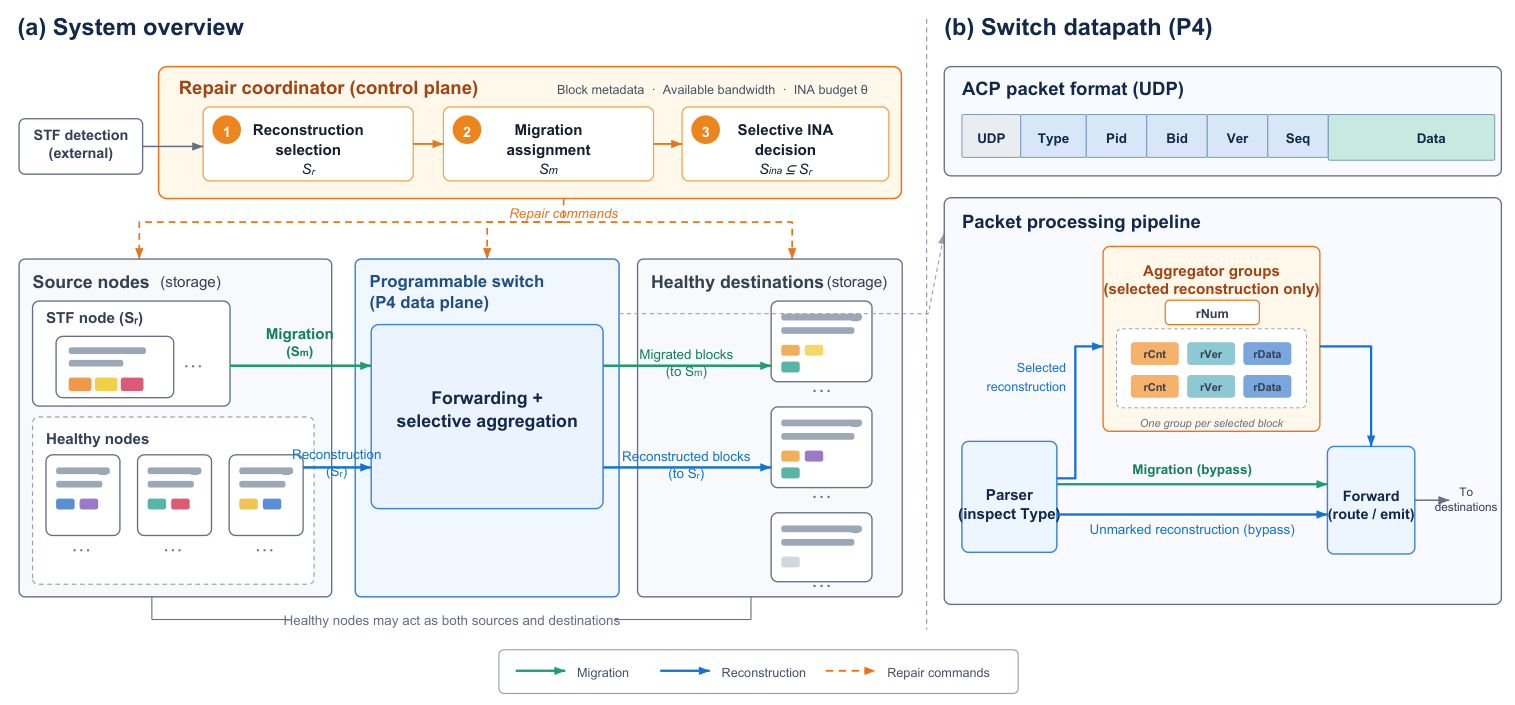
读图:上方先选重建、再排迁移和聚合;下方只有选中的重建流进入交换机聚合器,其余流量直接转发。
作者在 Tofino 与 16 个存储节点的原型上测试,默认 RS(9,6)、8 MB 块、512 条带、一个待失效节点,并模拟异构可用带宽。编码参数实验中,相对 SelectiveEC 的修复时间缩短 47.83%–68.04%。这是特定硬件与负载下的修复结果,较大规模调度另用模拟评估。值得关注联合排程,而非单看网内计算。 收益仍依赖故障预测提供足够提前量,以及交换机状态预算。
04 · Zepp:把均衡当约束,优先缩短通信瓶颈
Zepp: Accelerating Distributed MoE Serving under Relaxed Balance Constraints
Chang Chen、Andrew Yang、Tiancheng Chen、Jiangfei Duan、Xinwei Qiang、Zhongkai Yu、Xiang Fang、Yufei Ding · 首发:2026-10-08
MoE 把专家负载分得更均匀,可能反而增加通信。Zepp 将 GPU 与 NIC 均衡作为约束,优先减少瓶颈跨节点传输:专家副本尽量让 token 留在本地,split 分散网卡流量,merge 合并重复传输,再与专家计算和节点内权重交换重叠。
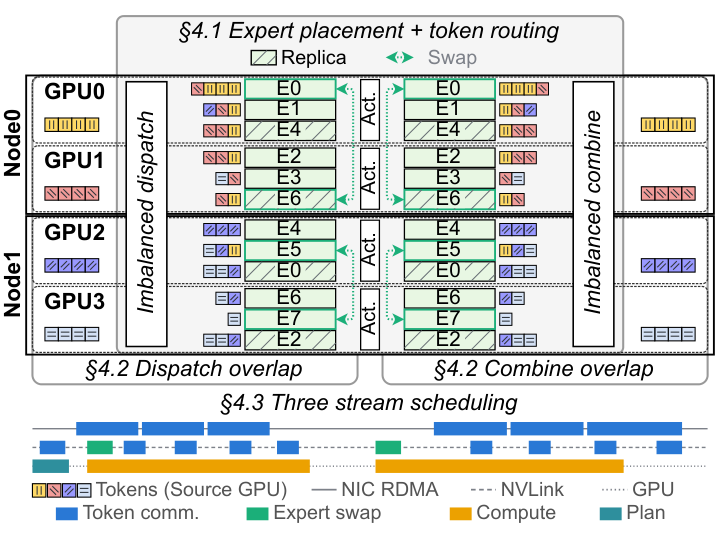
读图:上方协调副本、路由和专家交换,下方把 token 通信、专家权重移动与计算放到相互重叠的时间线上。
基于 Kimi-K2-Thinking 与 Qwen3-235B-A22B 路由轨迹、BF16、每 GPU 两个额外专家槽位,作者在主要多节点层级实验中测得:相对各配置最快竞争基线,几何平均加速 1.86 倍;最高 6.68 倍则是相对 A2AV+GEMM,不能混用分母或当成整机收益。优先看通信如何被削减,再看如何被隐藏。 历史放置与节点内交换也限制了对突发需求偏移的适应范围。
05 · ByteExpress:RDMA 的收益取决于软件协同
Deploying RDMA for Distributed Inference and Training At Scale
Yibo Huang、Yi Cui、Yukai Huang、Huaping Zhou、Jiancong Tong、Zhaoyu Wu、Gen Miao、Haoran Wei、Boyan Ding、Zhuo Jiang、Jianxi Ye、Yibo Zhu、Chuanxiong Guo、Yang Xu、Jie Wu · 首发:2026-10-08;修订:2026-10-12
ByteExpress 总结 ByteDance 参数服务器架构的部署经验:bemalloc 统一注册内存生命周期,逻辑连接复用 QP,接收信用保护接收队列,软件发送窗口限制在途字节;RPC 层继续负责超时、重试、选副本与 TCP 回退。
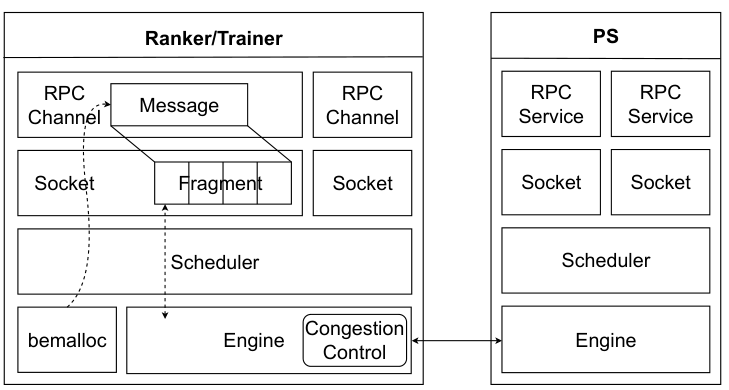
读图:请求从 RPC 经逻辑 socket、调度器进入 engine,bemalloc 提供注册缓冲区,传输控制与应用恢复分层协作。
在 300 个参数服务器、124 个 ranker、25 Gbps ConnectX-5 的推理部署中,作者测得参数拉取平均和 P99 延迟相对内核 TCP 分别下降 35.7% 和 43.7%,并非推荐请求端到端延迟。训练实验中,仅有硬件拥塞控制的 RDMA 反而更慢;加入软件窗口后,P99 push 为 268 ms,相对 TCP 的 1.03 s 下降 74.0%。最值得读的是资源控制与恢复职责的划分。 观察期未出现 PFC pause,不代表可以关闭 PFC,也不能直接外推到 LLM 集合通信。
缓存服务的安全边界
LMCache:多进程通信中的不安全反序列化
原帖:@DailyDarkWeb · 2026-10-08
JFrog 原始披露 · 2026-10-07;LMCache 项目公告 · 2026-10-13
CVE-2026-105192 涉及多进程模式的 ZeroMQ 传输:设备 IPC 描述符在消息解码时进入 pickle,网络可达且未认证的对端可触发代码执行。CVSS 9.8 对应可路由地址暴露条件;默认 localhost 及未打开该端口的进程内模式不能混为一谈。项目公告确认影响 0.3.9–0.5.5、0.5.6 候选版及修复前开发分支,并说明修复已于 10 月 12 日合入开发分支,改用带版本和类型校验的 MessagePack 描述符,计划随 0.5.6 发布。因此,“未修补”只适合作为原帖当时的状态。协议改变要求 worker 与 server 一起升级;去掉反序列化漏洞也不等于完成传输认证。两份一手说明没有适合的架构图,本节保留文字解读。