本期看点
共享资源能省掉多少工作,取决于系统能否处理好边界。本期两篇重点分别追问:CPU 与 GPU 共用物理内存后,怎样保证数据可见并真正减少搬运;长上下文命中 KV cache 后,为什么请求仍会卡在分词。前者把缓存策略、硬件一致性和同步竞争放在一起研究,后者把优化推进到推理引擎之前的服务入口。
优先读 UMA 内存共享研究与 GraphTok。 它们都展示了“省掉主要计算以后,原本次要的开销成为瓶颈”的具体机制。其余三篇关注状态管理:SnapShare 限定可共享快照的边界,ShoreKeeper 根据恢复成本管理集群缓存,BLIS 用服务流程模拟筛选配置。另附 Azure SRE Agent 漏洞与可观测性工具整理,帮助把性能与运行可靠性放在同一视野中。
01 · UMA:共享物理内存之后,仍要设计数据可见性
Characterizing CPU-GPU Memory Sharing over Unified Memory Architecture
Jinrong Yang、Zimeng Wang、Rong Chen、Haibo Chen · 首发:2026-10-09 · EuroSys 2027(原文标注录用)
“零拷贝”只解决了问题的一部分
统一内存架构让 CPU 与 GPU 访问同一份物理内存,但不保证双方私有缓存中的数据同步更新。如果仍沿用独立显存的编程方式,会留下冗余拷贝;若直接交换指针,又可能读到旧数据。论文的价值是把正确性与性能一起拆开分析,给应用一个有条件的选择依据。
作者覆盖 Raptor、Arrow、Lunar、Orin 四个平台,比较互连、内存侧缓存及单向一致性的差异,并扩展到双向一致性的 DGX Spark。方法把通信分成发送和接收两段,分别配置内存绑定、读写和释放操作,再组合页大小、缓存策略与一致性设置。测试逐字核对确定性负载;它提供所测配置下的可见性证据,不能视为所有并发内存交互的形式化保证。
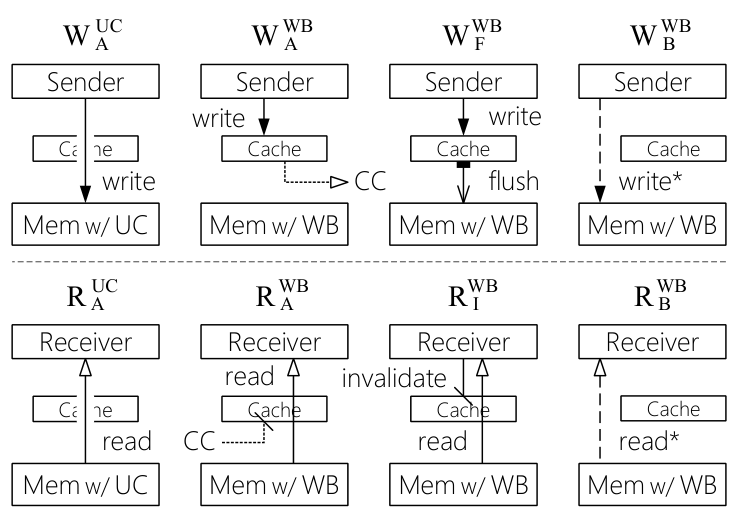
读图:上排决定写入怎样离开发送方缓存,下排决定接收方怎样取到新值;刷新、失效、旁路与硬件一致性是不同组合,必须配合内存属性选择。
大块数据与小同步标志需要不同策略
数据面既要算搬运,也要算建立映射的代价。大区域使用 4 KB 页可能让页表配置明显变慢,强制小区域使用 2 MB 页又会浪费空间;作者建议透明大页配合预触页。禁用缓存虽容易获得可见性,却可能大幅拖慢 CPU。硬件一致性也不是无成本选项:没有内存侧缓存的 Arrow 上,启用一致性的 GPU 写入时间达到关闭时的 2.07 倍。
控制面则常常只交换一个标志。此时几千个 GPU 线程同时轮询,竞争会压过单次读取成本。论文比较块内、全网格和独立内核协调,强调应减少接触共享标志的线程数;全网格同步还要承担避免死锁的复杂度。
libumsh 将这些选择收进统一接口。应用提供传输方向、数据是否来自 I/O、通信跨内核还是发生在内核内部,后端再选择读写、一致性与缓存维护策略。它不是把平台差异抹去:Arrow、Lunar 需要修改运行时才能暴露部分控制接口。
怎样理解结果
九个应用案例中,作者测得数据传输时间降低 16–75%,协调开销降低 7–90%;这些是对应阶段的收益,不是整项任务都快同样比例。Arrow 上的 PyTorch 模型加载通过去掉拷贝降低 75% 加载时间,透明大页再带来额外改善,说明映射开销也会影响收益。
Agent 场景的估算更接近用户等待时间:TaskBench 轨迹包含一个 GLM-4.7-Flash 编排器和依次运行的三个工具,运行时保持预热、模型按需重载。将分别测得的平均耗时相加后,请求延迟估计降低 9.0–15.9%。因此,模型重载频繁的工作负载更值得关注;不能直接套到模型常驻内存的服务上。
阅读判断:优先看读写组合与案例分解。 它给 UMA 应用优化提供了可操作的方法,但透明大页可能因碎片化回退,驱动暴露能力也不同。迁移到新平台时,应重新验证可见性和代价,而不是仅凭“支持统一内存”照搬配置。
02 · GraphTok:KV 命中之后,把分词从服务入口移开
Taking Tokenization off the Host for Agentic LLM Serving
Mohammad Siavashi、Pascal Schwinte、Ali Banaei、Gerald Q. Maguire Jr.、Marco Chiesa、Dejan Kostić · 首发:2026-10-09
重复上下文仍要先变成 token
多轮 Agent 会反复发送很长的历史。前缀缓存能省掉模型的重复 prefill,但服务端通常必须先完成分词,才能查询缓存。GPU 计算越少,CPU 分词在首 token 延迟中的占比越高;一个为整组 GPU 处理请求的前端,还可能先耗尽 CPU 容量。
GraphTok 的新意在于将预分词、BPE 合并和 token ID 组装组织成可重放 CUDA graph,同时要求输出与参考 tokenizer 的有序 ID 序列完全一致。只让合并变快、忽略特殊 token 或正则边界,会改变模型输入;只比较解码后的文字一致,也不足以证明等价。
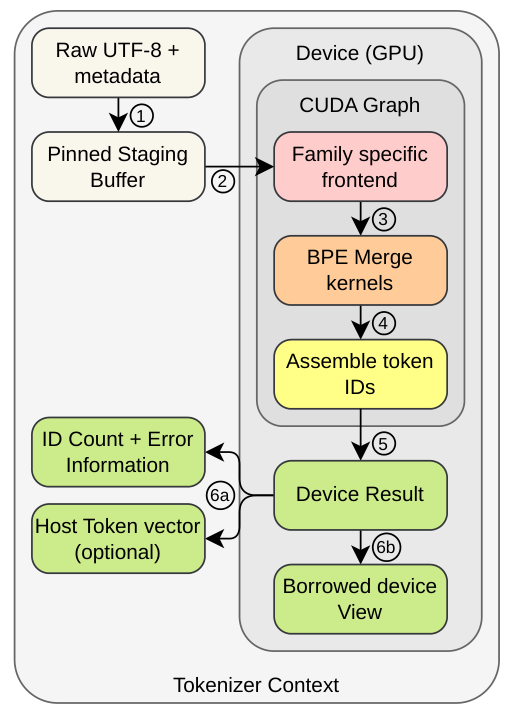
读图:原始字节经过锁页缓冲区进入 GPU;模型族专用前端产生符号和边界,共享 BPE 后端完成合并,最后按顺序组装 ID,并提供主机或设备返回路径。
怎样并行,又不改变语义
预分词把顺序正则匹配改写成各位置的边界判断,再用扫描运算补充上下文。例如 Llama 3 的数字切分要求从数字串左端每三个字符分组,不能任意把文本等分。不同模型族有不同前端,这也是支持新 tokenizer 的工程成本。
BPE 在不同预分词片段之间并行,片段内部则保留合并优先级及同优先级时的位置顺序。系统按片段长度分流,对较短片段用 warp 协作寻找下一次合并,对长片段另设路径。动态数量与输出压缩尽量在图内部处理,减少 CPU 往返;不过 Qwen 的 NFC Unicode 归一化仍有主机步骤,截断等请求策略也在图外。
短输入未必值得搬到 GPU。GraphTok 根据开销选择 CPU 路径,并通过调度器把并发请求批量送入图。其关键是覆盖长输入的完整编码链,而不是假定所有文本、所有负载都应该使用 GPU。
单请求延迟与前端容量是两类证据
实验使用一张 H100 NVL,主机配两颗 Xeon Gold 6336Y、共 96 个硬件线程。在 vLLM 0.27.0、32k–128k-token 输入、99% 前缀复用时,相对默认 tokenizer,作者报告平均 TTFT 改善 2.1–2.4 倍。每格仅五个请求,增益还包含默认前端首次解码整段提示的额外开销;gigatoken、TokTier 在这个实验中与 GraphTok 相差不超过 4%,不能把全部收益归因于 GPU 分词。完整分词调用计入数据传输。
更醒目的容量实验使用 Dynamo 前端与模拟推理后端。对 121k-token 请求,在 P99 不超过 2 秒的目标下,GraphTok 支撑 518 请求/秒,gigatoken 为 296,默认 tokenizer 为 18.5。“相当于 56 张 GPU 的流量”由每张模拟 GPU 9.25 请求/秒换算,实际 H100 执行的是分词;这衡量前端供给能力,不能当作真实多卡服务 TTFT。
这一比较还关闭了 Dynamo 的前缀分词缓存,并在每次请求前清空 gigatoken 的预分词缓存。已有历史能被缓存直接跳过时,收益可能缩小。方法只覆盖五种具体 tokenizer 配置,所有硬件实验也来自同一张 H100。
阅读判断:值得跟进长上下文服务入口。 优先看精确性约束、CPU/GPU 分流和前端实验条件。它揭示 KV cache 优化后的下一处瓶颈,同时留下真实饱和多卡服务、更多硬件和缓存组合的验证空间。
状态管理与容量规划
03 · SnapShare:只共享经批准的快照内容
SnapShare: Isolation-Preserving Deduplication for Serverless Snapshots
Leonid Kondrashov、Likun Zhang、André Filipe do Pilar de Jesus、Hans Pistor、Marco Cali、Riccardo Mancini、Rodrigo Bruno、Dmitrii Ustiugov · 首发:2026-10-09
Serverless 快照常包含重复基础设施,但跨租户任意去重会暴露内容存在与否。SnapShare 将页内容与提供方批准的参考页匹配,只有获准内容可共享,私有页即使相同也保留租户边界;另按访问剖析决定工作集批量预取或 4 KB 页按需读取。
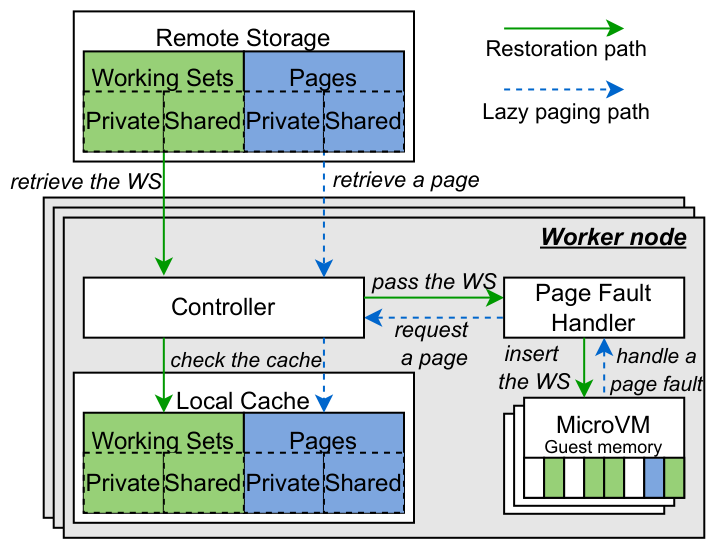
读图:远端与本地都区分共享/私有和工作集/单页;绿色路径恢复工作集,蓝色路径处理后来出现的缺页。
在 10 节点 CloudLab、每工作节点 4 GB 缓存、快照下载限为 10 Gbps、17 种函数映射到 700 个调用轮廓的实验中,作者报告相对块式和工作集基线,尾部请求 slowdown 降低 10–29%。价值在于把共享资格与读取粒度分别控制。边界也很具体:提供方必须可靠审批,获准组件的秘密依赖访问不在保护范围内;原型用 MD5 摘要相等判断匹配,不能据此宣称对恶意碰撞有完整防护。
04 · ShoreKeeper:让缓存位置服从恢复成本
ShoreKeeper: Accelerating Iterative Data Analytics in the Cloud via Distributed Recovery-Cost-Aware Caching
Jongseop Lee、Minsu Sun、Xinyue Ma、Atul Sandur、Myeongjae Jeon · 首发:2026-10-09
迭代分析的缓存淘汰会触发沿依赖图重算,节点本地最优不一定适合全局。ShoreKeeper 用离线与在线剖析估计恢复成本,以混合整数规划联合决定保留、位置和副本;图裁剪加快重规划,抢占通知到来时优先迁移最贵的数据。
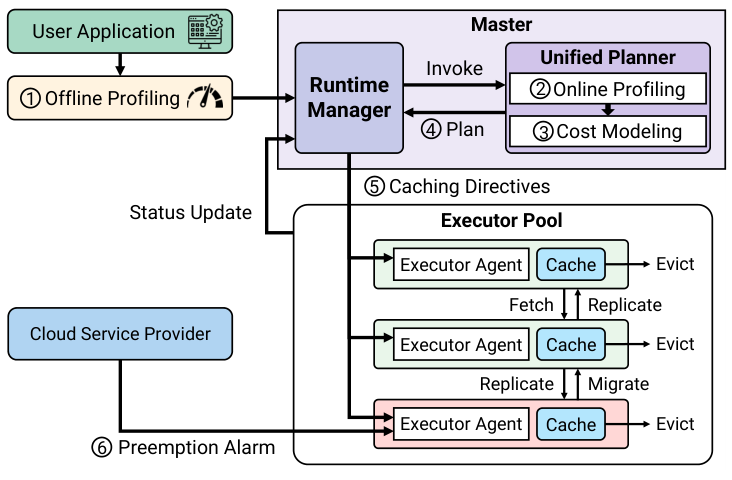
读图:执行器回报状态,主节点生成缓存计划;云平台抢占告警触发重规划,再下发迁移、复制或淘汰指令。
默认实验是 11 台 AWS r5n.2xlarge、其中十台工作节点承载 20 个执行器。回放两段 Spot 抢占轨迹时,相对加上退役迁移的 Blaze,作者测得 1.14–2.87 倍加速。它适合依赖清楚、可重算的迭代数据流;短任务可能难以摊销剖析成本,纯抢占集群全部消失时仍需从输入重算,内存副本并非持久检查点。
05 · BLIS:把排队与缓存纳入推理配置模拟
Simulate Before You Scale: High-Fidelity LLM Inference Planning Without GPUs
Dipanwita Guhathakurta、Mert Toslali、Srinivasan Parthasarathy、Jing Chen、Michael Kalantar、Nicholas A. Masluk、Vishakha Ramani、Asser Tantawi、Fabio Oliveira · 首发:2026-10-09 · ACM SIGMETRICS 2027(原文标注录用)
BLIS 用解析计算项和一次全局拟合的系数预测执行步耗时,再以离散事件模拟连接准入、路由、批处理、KV 管理和抢占。配置搜索在 CPU 上运行,但系数仍依赖真实系统测量,并非完全不需要 GPU 证据。
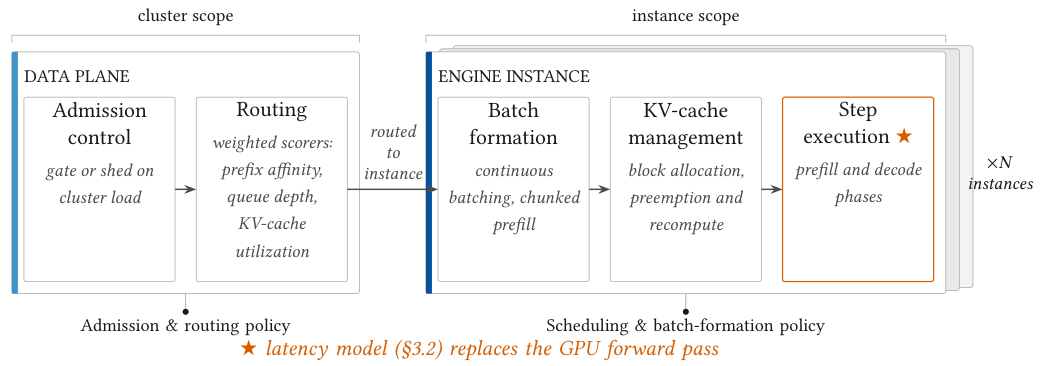
读图:左侧准入和路由改变实例负载,右侧保留批处理与 KV 管理,星号位置用延迟模型替代 GPU 前向计算。
六个模型、三类 NVIDIA GPU 的 36 个实验中,平均端到端延迟预测的中位误差为 6.7%,模拟约快 200 倍。平均 TTFT 的中位误差则为 17.6%,不能把前一数字推广到所有指标。跨节点拓扑、竞争和专家并行尚不完整,绝对误差验证主要针对单实例。适合先缩小配置候选,再验证真实部署的服务目标。
运行可靠性动态
Azure SRE Agent 的授权边界。 @UpwindMDR 原帖(2026-10-09)提醒关注 CVE-2026-69435。Microsoft 公告及其 CNA 记录将问题描述为缺失授权导致已认证攻击者经网络提升权限,分类为 SSRF,公开日期为 2026-10-08,涉及托管服务。它提示运维 Agent 的工具请求也需要明确权限边界;公开记录不足以推断完整利用链。
可观测性应覆盖整条执行路径。 Maryam Miradi 原帖(页面日期 2026-10-09)把工具整理为调用追踪、OpenTelemetry 接入、日志指标、成本性能和生产调试几类。其价值是帮助梳理需要观察哪些环节;标称 20 项中 Langtrace、OpenLIT 重复出现,并非 20 个不同项目。作者将后续比较写为计划,因此这是一份导航清单,不是性能排行或成熟度评测。