本期最值得先读的是 ReFlow 与 CQ2-CARE:前者把昂贵的生成轨迹重复用起来,同时控制策略过时与 GPU 分工;后者把编码上下文的目标从“压缩得更短”推进到“找对文件,并保留能精确编辑的代码”。两项工作都提醒我们,省下计算或 token 以后,还要检查学习进展和任务完成率是否保住。
推理服务方面,三篇 KV 存储研究分别追查逐对象开销、SSD 部分块放大和远端服务排队,说明命中率本身不足以判断收益。可靠性方面,ExecWeave 区分观察与推断,Diviner 将知识更新交给回放和人工审核,MCP-FSD 检查工具意图与实际权限的落差。它们提供的是不同层次的机制与证据,适合按自身关注的训练、服务或诊断环节继续阅读。
01 · ReFlow:让近期轨迹多次参与训练,同时控制过时程度
ReFlow: Replay-Driven Decoupling for Efficient RL Post-Training
Yukun Tian 等 · 2026-10-15 · Chuan Wu 参与
强化学习后训练的等待,常发生在生成和更新之间:模型需要逐 token 生成轨迹,工具调用又引入不同长度的停顿;训练器即使已经空闲,也可能凑不齐下一批数据。异步执行能把两阶段重叠,但进一步放宽策略版本差距,可能让数据与当前模型越来越不匹配。ReFlow 的选择是复用近期已经消费过的轨迹,减少每次更新所需的新生成量,并随之调整 GPU 分工。它改变的是训练数据的生命周期,以及生产数据和消费数据的速度关系。
复用多少,与旧数据影响多大,分开控制
输入提示先进入流式生成队列,完成的轨迹逐条写入缓冲区。训练器从未使用数据与回放数据中组批,不必等整批生成结束。回放比例可以随供需变化,但受上限约束;系统另外降低回放样本在损失中的相对权重,并限制允许使用的策略版本差距。于是,“一半样本来自回放”并不等于“一半更新影响来自旧数据”。
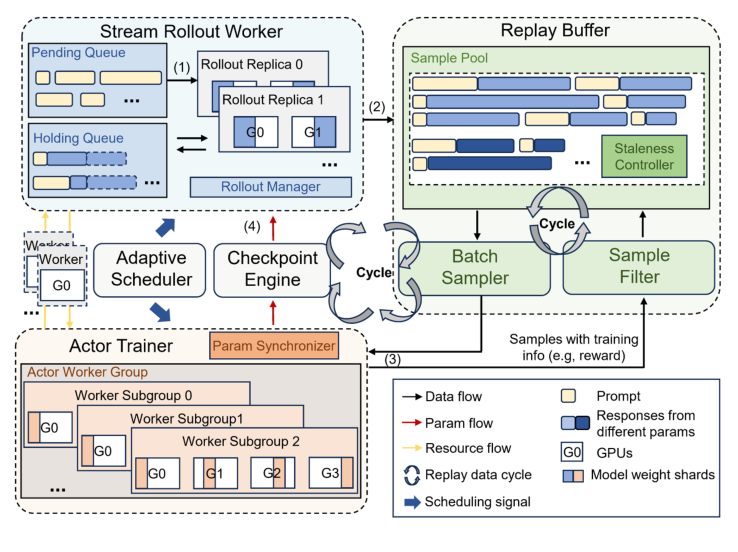
左上持续生成,右上缓冲区控制样本年龄与回放;下方训练器消费数据,中间调度器同时调节资源和参数同步。
论文实验把回放比例上限和相对损失权重都设为 0.5,允许最新及前一版本的数据。其简化分析在等权 token 量等假设下,说明此时回放的梯度混合权重最多为三分之一;这是局部误差分析,不是任意任务上的收敛保证。作者也展示了直接按固定比例回放会拖慢学习的例子,因此不能只取“重复用数据”而省掉稳定性控制。
数据节省以后,机器也要重新分工
回放降低了生成需求,原有固定 GPU 划分可能反而浪费资源。ReFlow 的统一 worker 预先准备训练与推理能力,将暂时不用的模块卸载到 CPU;重分配时按完整副本组切换角色,尽量保留已有分片,并给新训练副本传输对应分片。调度器根据实际生产、消费与空闲比例调整分工,同时参考 KV 占用和抢占压力调节生成并发。这样既避免每次扩缩都冷启动,也避免把更多请求简单塞进已拥堵的生成端。
吞吐收益需要和奖励进展一起看
作者在最多 128 张 H800 上测试 Qwen3-4B 至 32B,以 VeRL、one-step-off 和 VeRL-async 为基线。单轮 DAPO-Math-17K 的训练吞吐提升为 1.19–2.06×;APPS 多轮编码任务为 1.07–1.92×;ReTool 的 Qwen3-8B 配置在 16/32 张 GPU 上为 1.31–1.82×。吞吐按训练器每步处理的 token 数除以步时长计算,包含被复用的数据,不能解释为新生成样本增加同样倍数。
训练奖励曲线显示,在这些设置中,系统能更早达到相近奖励。32 张 GPU 的角色调整仍需 5.72 或 9.20 秒,并非无成本。优先读数据循环与资源重分配两部分:它们把算法允许的样本复用转化为系统调度空间。长期泛化、不同奖励机制和更长训练过程仍需更多证据;论文的奖励轨迹也不能替代独立下游测试。
02 · CQ2-CARE:先选对待修改文件,再保留可精确编辑的原文
Skip the Compressor: Coding Agents Fix More Issues When They Pick Whole Files
Xiaocong Yang、Rishit Chatterjee、Himanshu Udupi、Vikram Ramavarapu、ChengXiang Zhai · 2026-10-15
编码 Agent 面对大仓库时,通常需要检索代码片段或压缩上下文。问题在于,修复 issue 同时需要两种信息:应该修改哪个文件,以及该文件原来究竟怎样写。语义相似度可能把预算花在同名测试、文档或调用者上;逐 token 压缩则可能保住了文件名,却改坏补丁必须引用的源代码。CQ2-CARE 把预算优先用于少量完整文件,让“定位”和“可编辑性”共同成为评价目标。
从路径清单到完整文件
模型先看 issue 和筛选后的路径清单,独立给出待修改文件的排名;选择两次回答共同指出的非测试、非文档路径,交集为空时回退到另一份排名。随后,模型提出最多四项定向搜索,补充定义或调用者等证据,最多来自八个其他文件。最终上下文由选中文件和证据片段组成,仍有单块与总量上限,并非无限制装入仓库。
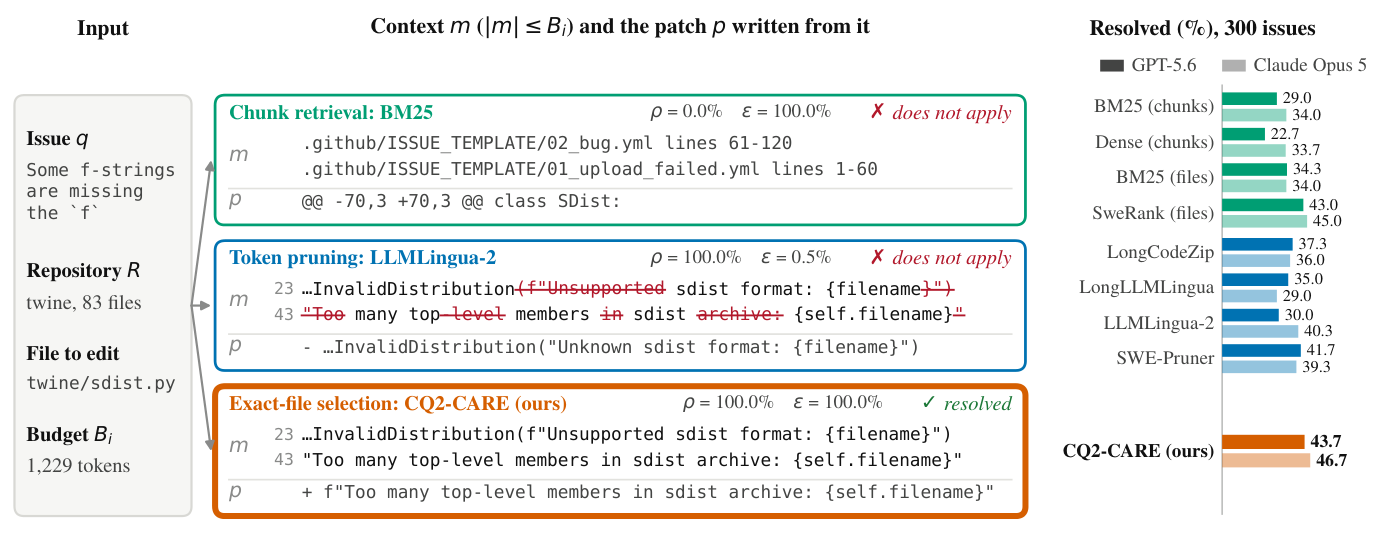
从上到下比较检索、token 裁剪和整文件选择:前者可能找错文件,中间可能破坏引用文本,下方保留可定位的源代码;右侧是总体解决率。
实验不是先规定统一的 16K 或 32K 窗口,而是先生成每个 issue 的 CQ2-CARE 上下文,再把其实际 token 数作为该题所有方法的目标预算。这个设计适合回答“在选择器使用的预算下怎样组织上下文”,对任意固定窗口的结论则要看额外预算扫描。模型只生成一次补丁,由测试判断是否修复;不能直接把结果当作可反复读文件、运行测试的多轮 Agent 排名。
两种失败如何分开观察
作者使用 SWE-rebench 中 300 个 Python issue,每个来自不同仓库,并先确认正确补丁能通过、空补丁不能通过。GPT-5.6 与 Claude Opus 5 的解决率分别为 43.7% 和 46.7%,相对各自最佳压缩基线均高约 6.3 个百分点,相对最佳普通检索基线高 9.3 和 12.7 个百分点。训练过的函数检索器 SweRank 则只落后 0.7 和 1.7 个百分点,显示“选取合适且保持原样的代码”可以有不同实现。
诊断实验更有解释力:固定所选文件、删去每行 20% token,GPT-5.6 的补丁可应用率从 98.0% 降至 78.7%,解决率降低 9.7 个百分点。但当 LongCodeZip 使用 CQ2-CARE 的同一候选文件集合时,解决率达到 44.7%,与 43.7% 接近。证据支持先把文件选对、保持代码行完整,而不是所有压缩必然无效。
对上下文工程的启发
两次定位回答的一致性提高了文件级 F1,但把单次回答截到相同文件数量也能取得接近结果;收益主要来自克制地选择少量文件,不能把一致性机制单独神化。GPT-5.6 下,作者估计完整流水线 API 成本为每题 0.151 美元,压缩方案仅 API 部分为 0.168–0.177 美元,后者还需压缩模型计算。
这篇值得优先读控制实验与讨论:它把“上下文更短”转成“补丁能否落到真实代码”的可检验问题。边界是单轮、Python、一个基准及大多数格子仅一次补丁采样;小幅差距尤其容易受采样和潜在训练数据重合影响。多轮系统能否通过重读弥补压缩损失,还需把额外轮次和 token 成本一起衡量。
03 · ExecWeave:把执行关联的证据强度也画进图里
ExecWeave: Cross-Layer Execution Provenance for Observable Agentic Software
Guo-Wei Wong、Meng Chang Chen · 2026-10-15
Agent 的工具记录与操作系统事件并不天然共享身份。ExecWeave 分别采集框架语义、模型网关和进程/文件/网络事件,构建带来源、推断与因果状态的执行图。命令到进程的启发式连接只在观察到唯一兼容候选时生成;候选不止一个就拒绝归因。
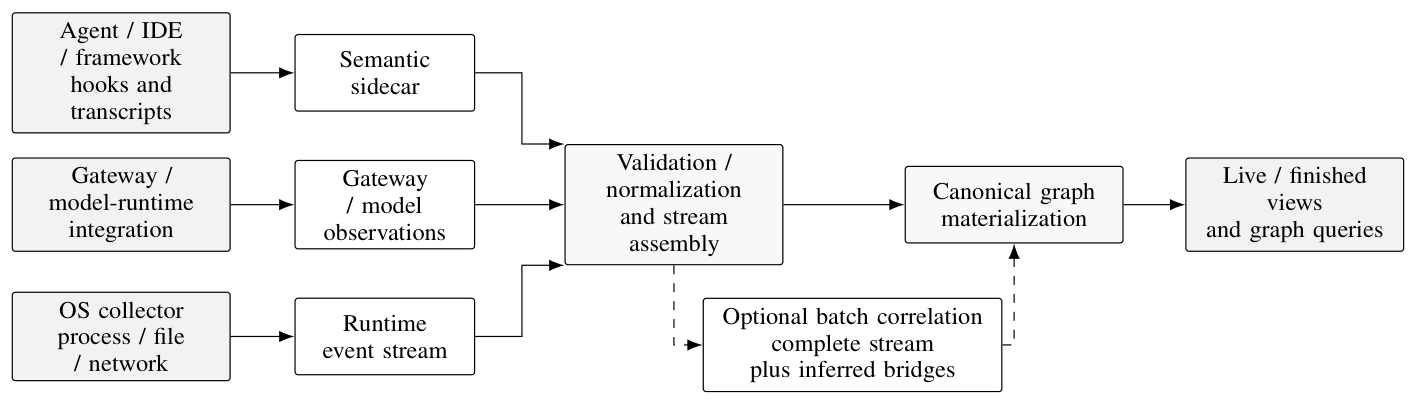
三路证据先各自保留,再标准化成图;虚线分支表示可选的推断连接,不能当成直接观察到的因果关系。
关键负对照表明,真实进程漏采而只剩一个冒名候选时,“唯一”仍会连错。Linux 可移植采集器在 20 ms 轮询下,对实际约 16 ms 的短进程仅检出 18/30 次;固定工作量实验的时间开销中位数为 62.3%–408.8%。因此它更值得作为显式表达不确定性的可观测性设计阅读,而非完整、低开销的因果追踪保证。AutoGen–Ollama 的单例验证也不代表跨框架覆盖。
04 · Range:缓存切得更细,不再逐对象付存储开销
Range: Decoupling KV-Cache Reuse Granularity from Storage Work
Dingsen Shi 等 · 2026-10-15
同样恢复 6 GiB KV,逻辑对象从 192 个增到 6,144 个,查询、分配与搬运次数也可能一起增长。Range 用范围票据表达可复用前缀,以固定字节条带组织物理 I/O,再由传输缓冲区跟踪异步完成;每层数据就绪后才放行该层注意力,使复用粒度与存储批次脱钩。
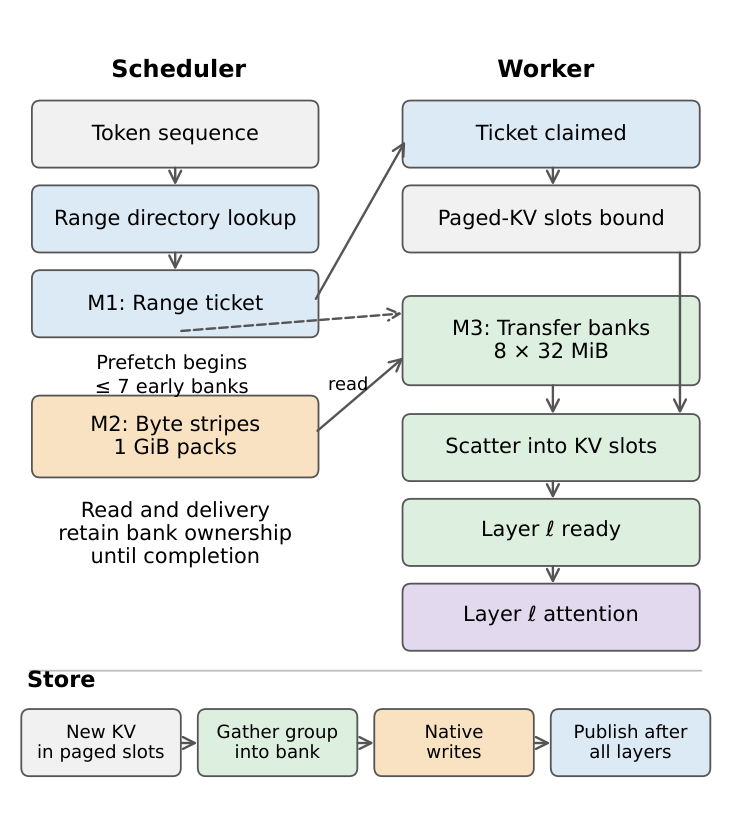
左侧票据确定复用范围,右侧缓冲区读入并散射到 KV 槽位;每层完成后才开始注意力,下方写回等全部层完成才发布。
在单张 H100 NVL、Llama-3.1-8B-Instruct、BF16 KV、65,280-token 请求且缓存 49,152 token 的设置中,作者测得 Range 的 TTFT 为 1.788–1.803 秒;调优后的进程内 cuFile 路径在普通粒度扫描中从 2.124 增至 3.012 秒。值得看整条路径如何维持批处理单位,而非只看 SSD 带宽。每格仅三次、逐请求运行,多 rank 已实现但未测;并发服务与碎片化前缀仍是外推边界。
05 · LMCache SSD 实证:命中更稳定,也可能更慢
Characterizing Predictability-Latency Trade-offs of KV-Cache SSD Offloading in LMCache for LLM Serving Systems
Ying He 等 · 2026-10-15
这项研究比较两套可运行部署:LMCache 0.3.0 的缓冲 I/O,与 0.3.16.dev11 的前缀去重加 O_DIRECT。四类短上下文各发 100 个无状态请求。完全重复输入的写入从 1.62 GB 降到 11.75 MB,但后续 99 次请求每次仍读约 12 MB,平均 warm TTFT 从归档记录的 27 ms 增至 93.1 ms。
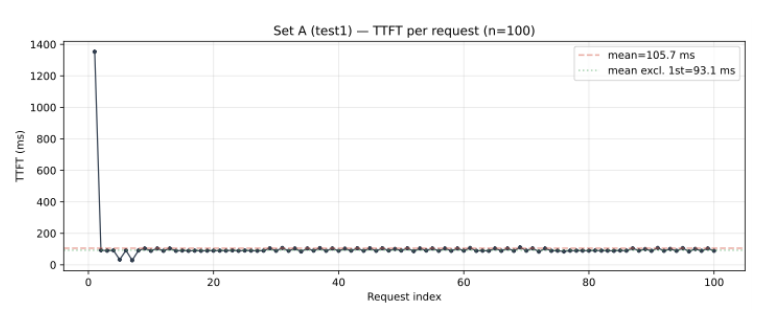
首个冷请求后,重复请求的延迟集中在较窄区间;稳定的 warm 路径仍有每次读 SSD 的成本。
原因是约 94-token 输入在 GPU 上已命中 80 token,剩余 14 token 却触发整个部分块读取;旧栈的低读取量则依赖操作系统页缓存。这为“命中后读回还是重算”提供了块设备证据。版本、SSD 与 I/O 模式同时变化,不能把差异全归因于单个开关;不足两个 256-token 块的输入也不能代表长前缀 RAG。原文没有整体架构图,这里用请求延迟图展示其研究对象。
06 · Diviner:诊断经验进入可回放、有人审核的改进循环
Diviner: Agentic RCA with Human-Governed Adaptation for Large-Scale Infrastructure
Pradipta Ghosh 等 · 2026-10-15
Meta 的 Diviner 把事故知识编码成技能、工作流和历史知识图,由 Lead–worker 协作查询实时证据;历史相似事故只产生假设,不能直接证明当前根因。保存的轨迹交给 DivinerEval 找出知识或工具缺口,修改须通过回放及负责人批准;系统提供建议,不自动执行缓解操作。
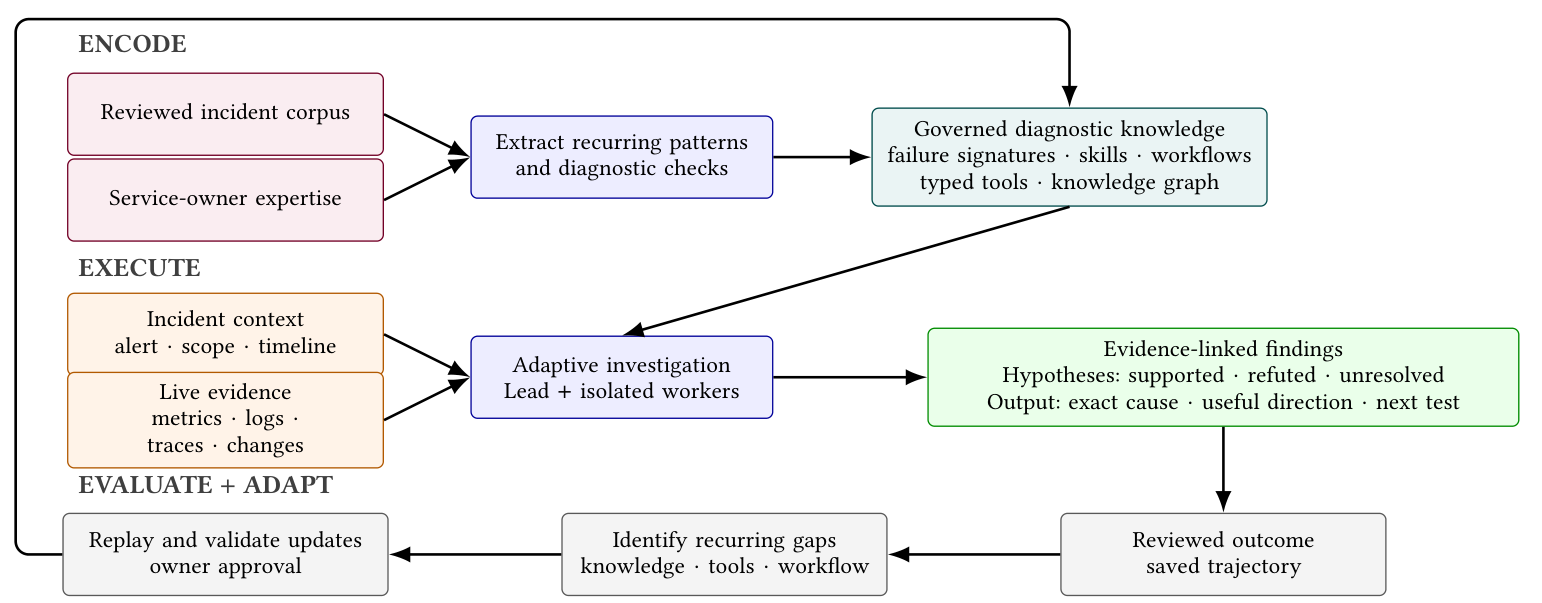
从上方经验编码进入中间实时调查,再沿下方评估与审批回到知识库;人工批准位于更新重新进入系统之前。
同模型对照中,Diviner + Claude 相对普通 Claude 的 Exact RCA 高 11 个百分点(95% CI:3–20),平均耗时低 52%(44–58)。运营观察队列中约 52% 的缓解时间下降是另一项关联结果,受事故构成、人员与采用方式影响。值得读的是知识治理和证据契约。整套 harness 的收益不能归给某一个模块,工具未返回数据也不能被当作“该原因不存在”。
07 · SpecAgent:小模型先探索,大模型在写操作前审核
Trajectory-Level Speculation with Semantic Verification for Tool-Using Agents
Zilin Wang、Yinhong Liu、Chao Chen、Qun Liu、Zhijiang Guo · 2026-10-15
SpecAgent 让小模型执行读取类工具并积累真实观察,遇到改变状态的动作先暂停。大模型一次读入整段轨迹,保留语义有效的前缀,并尽量在判定中直接给出修正动作,降低逐步生成的成本。
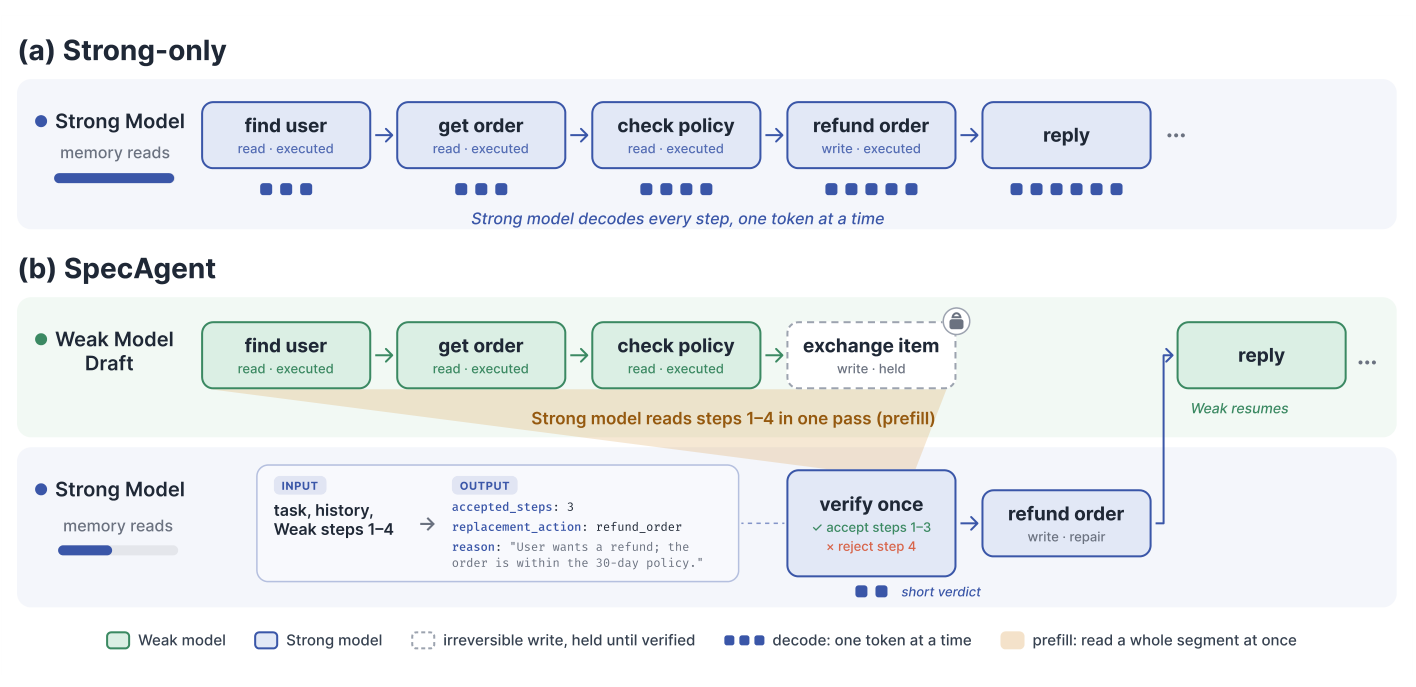
上方强模型逐步生成;下方小模型先执行读取,写动作暂存,由强模型接受有效前缀并修正后继续。
在 τ2-Bench Airline,4B/397B 组合的 Pass@1 与强模型单独执行同为 86.0%,平均耗时从 305.2 降至 126.2 秒;但 AutomationBench 只有 10.5%,低于强模型的 15.2%。HBM 流量来自 token 与架构估计,不能当硬件实测;更多 prefill 还可能增加 FLOPs。适合读作可逆执行边界上的成本设计:收益依赖工具读写分类准确、审核可靠,以及强模型 decode 仍受带宽限制;大批量下计算成本可能成为新瓶颈。
08 · 远端 KV:把存储并行度跟上上下文并行
When the KV Cache Is Slower Than the GPU: Scaling Remote KV Tiers for Context-Parallel Prefill
Muhammad Ibrahim · 2026-10-15
Muhammad Ibrahim 研究 GLM-5.3 在 8×B300 上的远端缓存:GPU prefill 已很快,单个 Valkey 实例反而成为瓶颈。方案按 chunk 序号将存取分给不同 rank,每个 rank 对应一个远端实例;加载前共同确认可用前缀,即使局部失败也保持 collective 顺序一致,再配合异步加载与客户端错误修复。
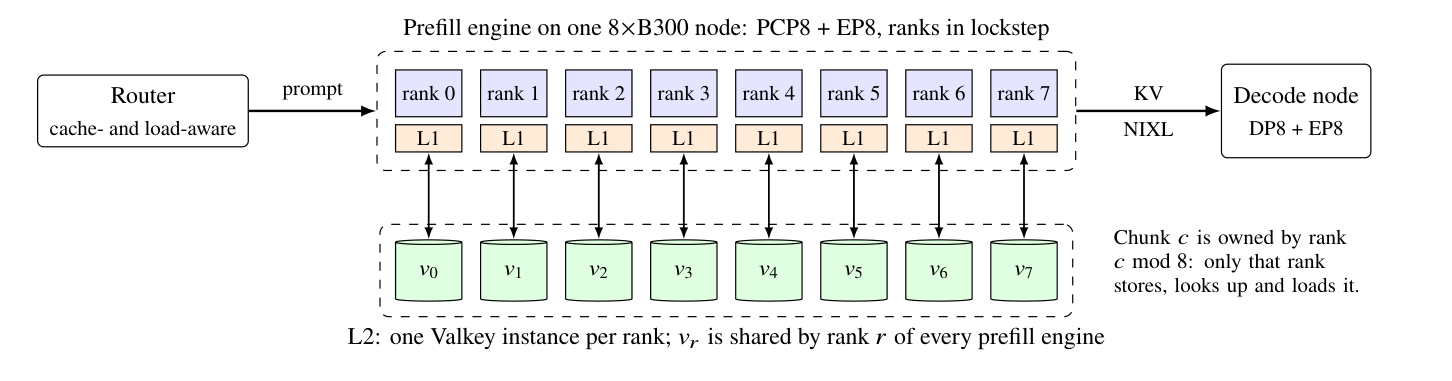
每个 prefill rank 管理自己的 chunk 和 Valkey 实例,摊开存取压力;右侧 decode 是完整设计的一部分,回放延迟不包含该交接。
在预热 L2、清空 L1 的 450 请求子集上,98.5% prompt token 命中 L2,作者报告 prefill p99 从 83.32 秒降至 0.67 秒。124× 来自拥塞路径到完整改进方案,不能当普通请求的通用缓存收益。每条件只运行一次,回放不含 decode 交接,选定子集能装进缓存。最值得跟踪的是加载/重算成本模型与失败时一致的跨 rank 协议。
09 · AMD 训练协同设计:容量、内核和模型一起调整
Architecting for Hardware Diversity: Meta’s End-to-End Co-Design for High-Performance AI Training on AMD GPUs
Haoyu Zhang 等 · 2026-10-15
Meta 用生产推荐模型说明异构训练迁移为什么不止于代码兼容:利用 MI350X 的 HBM 容量调整 batch、激活检查点与 embedding 放置;Origami 根据计算与缓存层次的成本选择 GEMM 配置,内核调优再适配多 chiplet 局部性与寄存器资源。
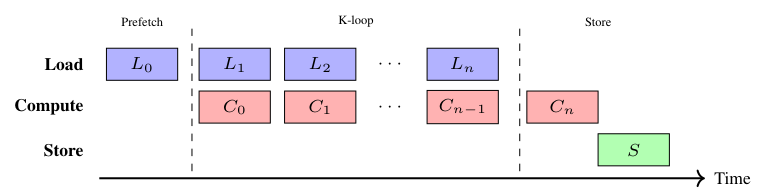
Origami 的时间模型把预取、重叠的加载/计算循环和最终写回分开估计;更好的 tile 选择需要兼顾并行度与缓存复用。
一个 feed ranking 模型的协同调整带来 1.26× 吞吐,结合内核优化相对初始移植基线达到 1.5×。十个生产模型在相同 GPU 数量和 batch 下,MI350X/B200 吞吐几何平均为 101.2%,单模型范围 82%–130%。这是特定软硬件部署与模型组合的结果。TF32 仿真和不规则 GEMM 仍拖慢部分模型,不能由总体接近推断每个算子或 LLM 训练都等效;优先读模型配置变化如何兑现容量优势。
10 · MCP-FSD:工具声明的用途,不等于进程真实权限
My Credentials, Please: Detecting Filesystem Capability Laundering in MCP Servers at Scale
Zeqian Huang、Mingyue Tang、Aonan Guan、Qiming Sun、Pengzhou He · 2026-10-15
MCP-FSD 研究工具参数如何诱导服务器访问声明用途之外的文件。流程先筛查工具契约与路径操作,推断最小权限范围,在范围外放置合成凭据,再比较无沙箱攻击、有沙箱正常调用、有沙箱攻击三个条件,分开确认可利用性与约束效果。
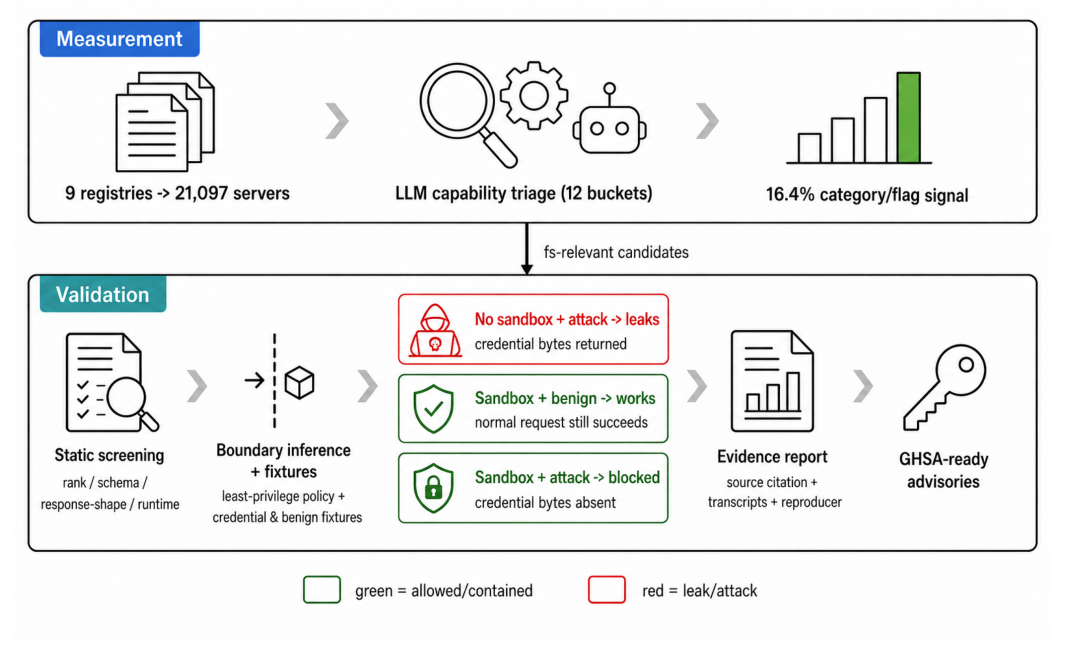
上方建立与筛选清单,下方推断权限并运行三组对照;只有响应和隔离结果支持结论时,候选才进入证据报告。
九个注册源共收集 21,097 条服务器记录,其中 4,806 个进入分类;787 个未归为文件系统类却出现文件能力标志,占 16.4%。这只是筛查信号,不能当漏洞率;动态验证确认的是 150 个实例。值得关注工具级权限与进程级授权的落差。结果受成功启动和测试策略限制,推断边界本身的准确率未测;一次正常调用成功也不足以证明策略覆盖所有合法用途。
11 · LLMEI:把输出异常追到参数位翻转
Understanding LLM Hallucinations Caused by Soft Errors
Jinghao Wen、Dongning Ma、Ruixuan Wang、Shaohuang Wang、Xun Jiao · 2026-10-15
LLMEI 用整数视图和位操作向模型注入错误,再观察输出如何变化。论文在 AIME 2024 与 LiveCodeBench 上测试多种模型,参数位错误率从 10⁻¹² 扫描到 10⁻⁴,每种注入配置重复十次,将异常分为 token 损坏、语言漂移、逻辑损坏和提前终止。
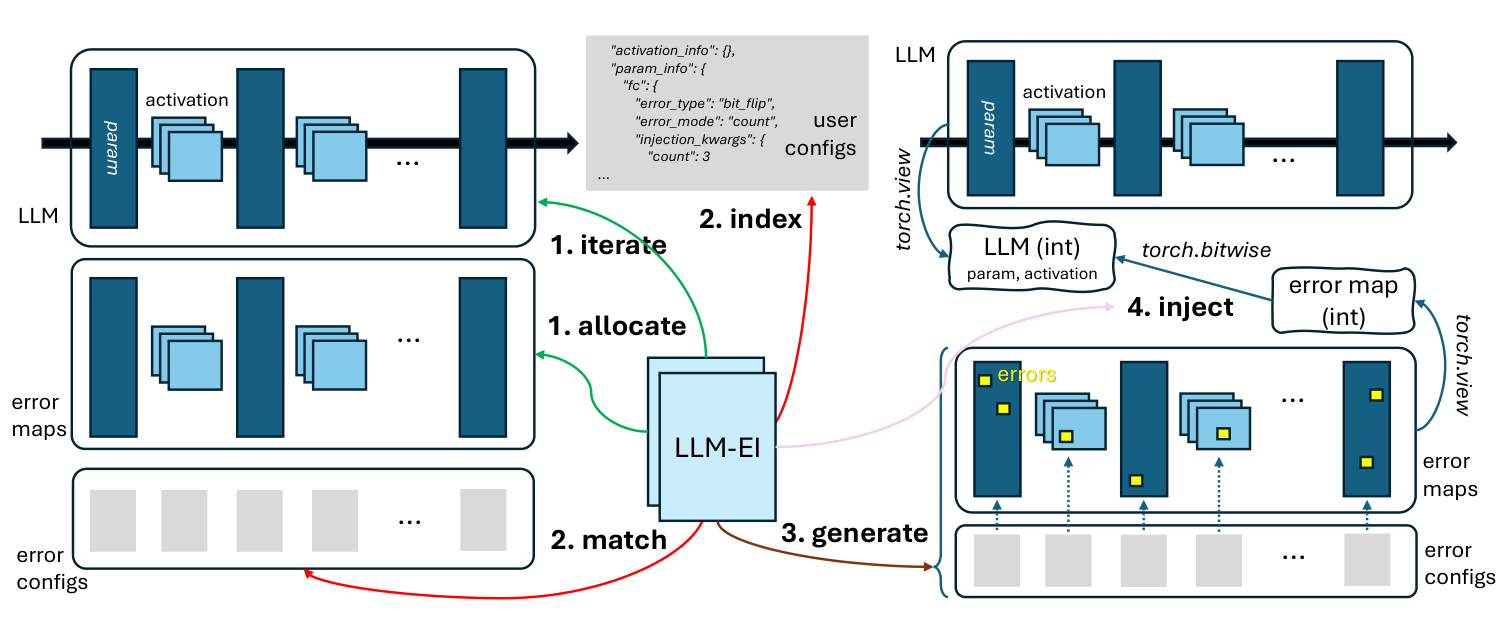
左侧匹配模型与注入配置,中间生成错误映射,右侧通过位操作改变对应张量;输出行为用于分析扰动如何传播。
作者观察到,较轻扰动下输出仍可能语法流畅却推理错误,严重扰动才更常出现无意义 token;注意力和 MLP 参数对扰动通常更敏感。价值在于把硬件可靠性与语义失败一起诊断。这是软件注入的参数扰动研究,BER 不是线上事故发生率,异常类别比例也不是全部请求的失败率;不能只凭模型更大就断言更耐故障。
延伸阅读:事故调查训练与跨模型 KV
Scout:用可验证事故模拟训练调查模型
Scout 1.0: Post-Training a Model for SRE Investigations
Datadog AI Research · 报告:2026-10-15 · Jonathan Parisot 原帖:2026-10-15
Datadog 将 GLM-5.3 Flash 后训练为 Scout。GenSim 从事故机制构造已知根因的场景:CausalGen 运行生成的应用并注入故障,SynthTel 直接合成遥测,以保真度换取不同生成成本。奖励同时考虑正确性、探索与证据支持,训练时还随机移除可选工具、改变轮次预算。
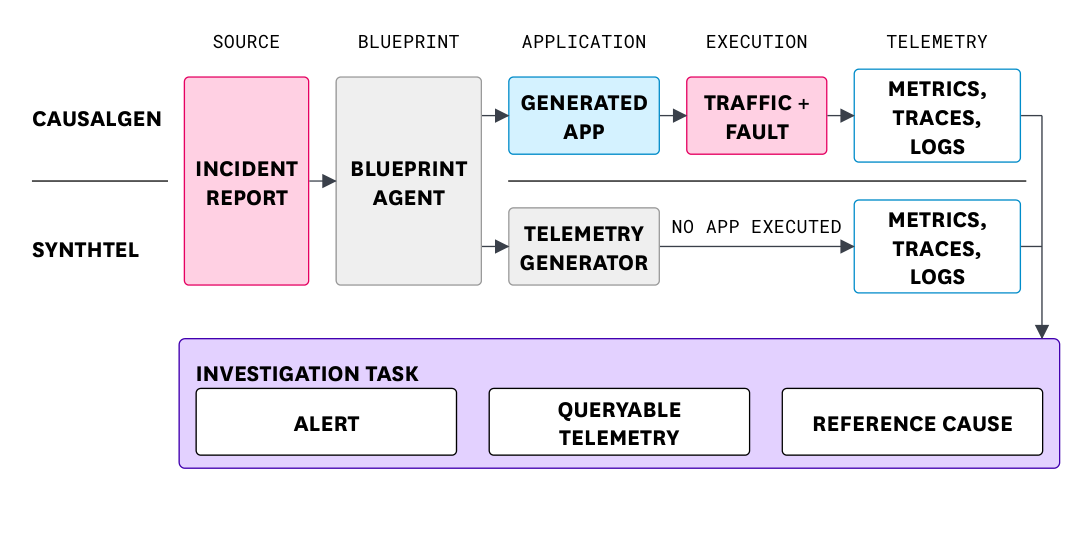
同一事故蓝图分成实际运行应用与直接生成遥测两条路径,最后都形成告警、可查询证据和参考根因。
AlertEval 使用真实告警、归档遥测和专家标签,但分数来自 LLM 裁判的分项评价,不等于事故解决率。报告称 medium 档调查质量接近 GPT-6.1 Sol high 与 Claude Opus 5.5 high,估计推理成本低 3–8 倍;该结论限于自有评价设置。公开 SREGym 的 90 个无噪声任务中,Scout xhigh 完成 80 个,每任务一次尝试。重点是模拟训练到真实调查的迁移,以及评分如何避免奖励保守而浅薄的调查。
RaReCache:跨模型复用 KV,按秩分歧选择重算位置
RaReCache: Bridging the Gap in Cross-Model KV Cache Reuse via Rank disagreement-based Selective Recomputation
Sreetama Sarkar、Saptarshi Mitra、Sitao Huang、Souvik Kundu、Peter A. Beerel · 论文:2026-10-08 · Sasha Malysheva 原帖:2026-10-15
RaReCache 先用离线拟合的线性映射转换小模型 KV,再比较完整映射与降秩映射,挑选落在校准数据支持较弱方向上的 token,让目标模型只重算这些位置。Qwen3-0.6B→14B 在完整 GSM8K 测试集上,重算 30% 位置将准确率从纯映射的 71.6% 提高到 90.2%,目标模型独立运行是 95.1%。
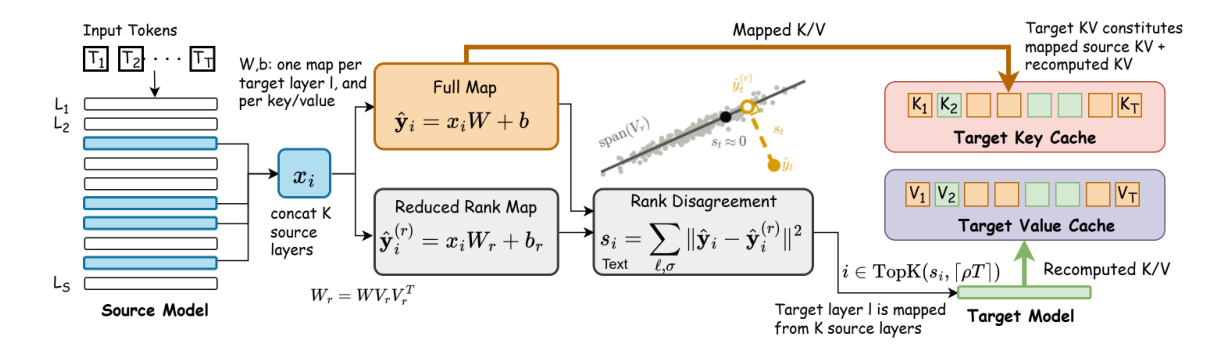
源 KV 同时经过完整映射与降秩映射,差异决定重算位置;右侧目标缓存混合映射状态和重算状态。
最高 3.04× prefill 加速来自 A100 80GB、平均 149-token 输入、批处理、20% 重算,且假定源 KV 已存在;不是上述 30% 精度配置,也不包含首次小模型 prefill。低负载时,框架调度开销还可能使它更慢。优先看选择指标为何优于注意力权重,以及精度与服务负载怎样共同决定收益。已验证配对使用同家族共享 tokenizer 的模型,不能理解为任意模型间无损转换。