本期看点
本期优先读 OAT 与 RIFT:前者把成功轨迹变成失败定位的训练信号,后者追问长输出过程中,起初选好的 KV 是否仍然有用。两项工作的共同价值,是把状态与证据随执行变化的问题变成可测量的机制;它们的指标分别是错误步骤识别与草稿接受长度,不能直接换算成任务成功率或服务加速。
另一篇 SnakeCharmer 把视角下沉到 GPU:预测到正确地址之后,还要决定是否预取、何时发出、放在哪里。三篇都值得关注,但证据层次不同:OAT 有跨数据集诊断实验,RIFT 主要刻画缓存预算与草稿质量的关系,SnakeCharmer 则是硬件模拟。阅读时,最值得保留的是这些条件如何限制结论的外推。
01 · OAT:从成功轨迹学习错误步骤的偏离
Tracing Agentic Failure from the Flow of Success
Samuel Yeh, Yiwen Zhu, Shaleen Deep, Sharon Li · 首发 2026-07-14;v2 2026-10-10 · NeurIPS 2026
失败标签难得,正常执行可否成为参照
一段 Agent 轨迹里,最终答错并不说明最后一步就是起因;早期误用工具、错误假设和后续补救可能交织在一起。让大模型逐步裁判成本较高,用失败数据训练又需要昂贵的步骤标注。OAT 采用单类学习:训练只看成功执行,推理时找出失败轨迹中偏离正常动态的步骤。它输出候选错误集合,适合缩小排查范围。
每一步先由 Qwen3.5-27B 提取末层 token 表示并求平均,再用 PCA 压到 64 维。模型把查询与步骤表示连成连续路径,以 Neural CDE 学习重建成功轨迹;控制路径持续注入实际观察,避免只由初始查询决定整条路径。门控模块压制分布外异常控制信号,减少陌生轨迹把动态模型带偏的风险。
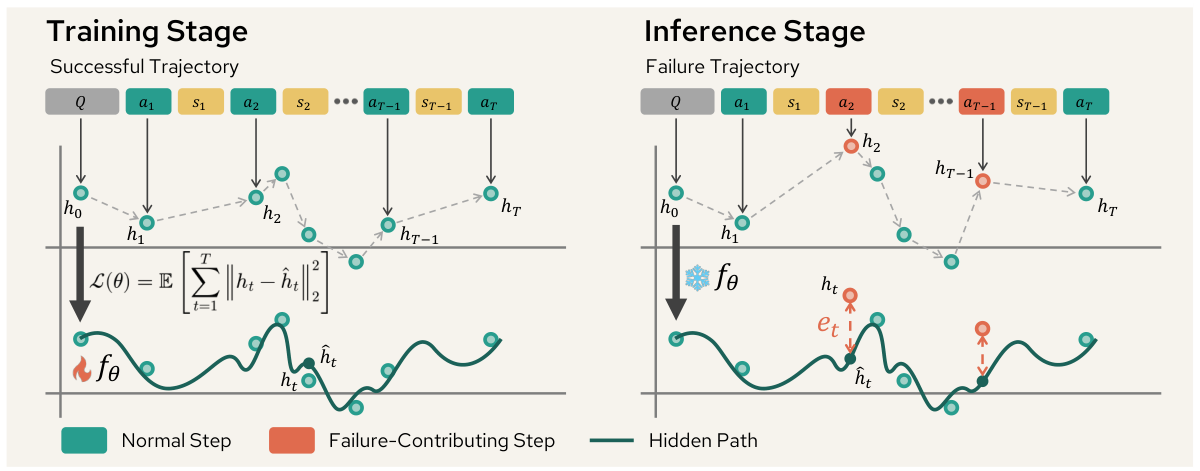
左侧从成功轨迹学习连续动态,右侧用实际步骤与重建路径的偏离标出候选错误。
推理时,实际表示与重建表示的平方距离就是异常分数。作者比较固定选前三步,以及用留出的成功轨迹校准阈值的两种策略。前者召回较高,后者更能控制候选数量;阈值校准所依赖的分布条件也意味着,换任务后不能把误报控制直接当作承诺。
优势明确,但不是自动找出唯一根因
MCP-Atlas 数据包含 103 条成功、88 条失败轨迹;成功数据按 80%/20% 用于训练与验证或校准。五个随机种子下,OAT 的阈值策略 F1 为 0.435±0.013,GPT-4o 为 0.212,GPT-5 为 0.181;传统 OC-SVM 和 Isolation Forest 都为 0.411。相对提示裁判的优势很大,相对传统异常检测的增量则小得多,值得一起看。
在 184 条 Who&When 失败轨迹上,Top-k 的 F1 为 0.225,GPT-5 为 0.152。这里轨迹由 GPT-4o 生成,作者用 Qwen 代理提取表示,并使用无标签 CORAL 对齐。两套数据的标注语义也不同:前者允许多个贡献步骤,后者标最早决定性错误;跨域结果因此支持迁移潜力,不能理解为所有故障定义都已统一。
速度最容易被误读。表中 OAT 的 7/16 ms 排除了隐藏状态提取;补上该过程,在两张 H200 上约为每条轨迹 1 秒,对提示基线约快 4–35 倍。200–5000 倍只对应已取得表示后的路径。另一个边界是,偏离正常轨迹并不证明修复该步就能挽救任务,失败贡献定义也不要求这一反事实成立。
优先阅读方法与成本脚注。 这项工作让廉价步骤筛查成为有吸引力的诊断前端,尤其适合能获得隐藏状态的系统;封闭模型、任务迁移和最终因果核验仍需要额外设计。
02 · RIFT:让草稿缓存跟上长输出
RIFT: KV Cache Compression for Draft Models with Complementary Compressibility Training
Dor Tsur et al. · NVIDIA · 首发 2026-10-22
输入时重要,不代表生成后仍然重要
投机解码让小草稿模型先提议,再由目标模型验证。压缩草稿 KV 可以降低其活跃状态开销,但如果只在 prefill 时按注意力选一次,随着推理文本增长,缓存会越来越偏离当前需求。论文称其为 decode staleness。尤其在混合注意力模型中,保留最近生成内容的简单滑动窗口,有时反而优于以输入重要性为主的 SnapKV。
RIFT 把这个问题拆成三个复杂度层次。RIFT-stat 将预算分给重要历史与最近窗口,实验通常各占一半;RIFT-dyn 定期用近期查询重新给完整历史 KV 打分;RIFT-ada 再用接受长度、草稿熵和查询漂移决定何时刷新,并设置最短、最长间隔。它优化的是“哪些状态继续值得放在活跃缓存”,而非一味减少 token。
另一个改动发生在训练。冻结草稿先做稠密打分,构造结合近期位置与重要历史的稀疏注意力掩码;可训练的草稿再在该掩码下,用教师标签与 logits 做交叉熵和 KL 蒸馏。这样,推理时只能看到有限 KV 的条件提前进入训练,降低训练与使用时的落差。
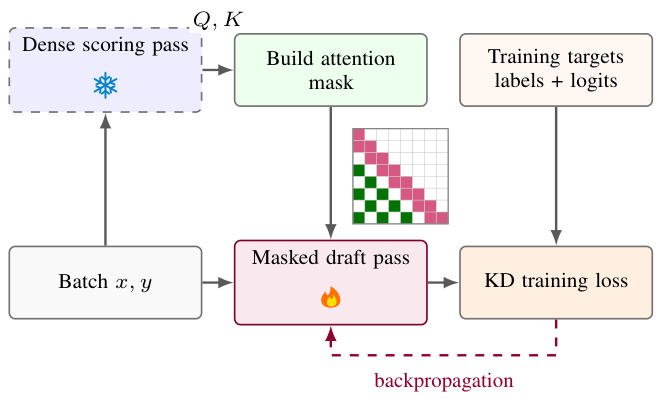
冻结打分生成近期与重要历史的掩码,再让可训练草稿在稀疏可见范围内学习教师输出。
接受长度保住了多少
在 SPEED-Bench 32K 输入、最多 4K 输出、8K 活跃缓存、草稿长度 11、温度 0 的低熵设置中,Qwen3.5-4B 为 Qwen3.5-122B 起草:SnapKV 平均接受长度为 4.07,滑动窗口 5.23,RIFT-stat 5.62,RIFT-dyn 6.12,RIFT-ada 6.19。这里接受长度包含额外的目标模型 token,并非最终答案准确率。
加入压缩训练后,作者报告在 32K 输入、4K 输出、8K 预算下保留超过 98% 的完整缓存接受长度。自适应刷新在另一组温度 1 的比较中,以接近的接受长度减少约 51.1% 刷新,或在相同刷新次数下增加 0.122 接受长度。这些结果说明,缓存选择与草稿训练可以互补;它们没有直接给出线上服务的同等加速比例。
最关键的工程约束是:动态刷新仍假设完整草稿历史留在 HBM 或卸载内存里。因此 8K 是活跃工作集预算,不能读成整个系统只存 8K。重打分、数据搬运、目标验证和草稿执行都要计入总延迟;论文的刷新开销部分采用投影分析,并报告朴素 GPU 测量中最高约 6% 的相对草稿解码开销。
值得精读缓存失效分析与局限。 论文更贴近受内存约束的外部草稿或自投机方案;对 MTP、EAGLE、DFlash 等尾部增强草稿,作者未把它们纳入主要研究范围。当前 GPU 部署中这些方案往往已有更好的端到端收益,RIFT 的异构部署动机仍待完整系统测量。
03 · SnakeCharmer:把预测地址变成有效预取
SnakeCharmer: Orchestrating Utility, Timeliness, and Placement in GPU Prefetching
Yuhan Tang et al. · 首发 2026-10-22 · MICRO 2026
预测地址正确,数据仍可能来得太早、太晚,或挤掉更有用的缓存。SnakeCharmer 为地址预测器加入统一后端:用零值置信度过滤低效请求,按过早/准时/过晚反馈调整预取距离,再通过映射表把数据缓存在空闲寄存器中,减少 L1 竞争。没有空闲寄存器时该部分可关闭,并非假定总能借到容量。
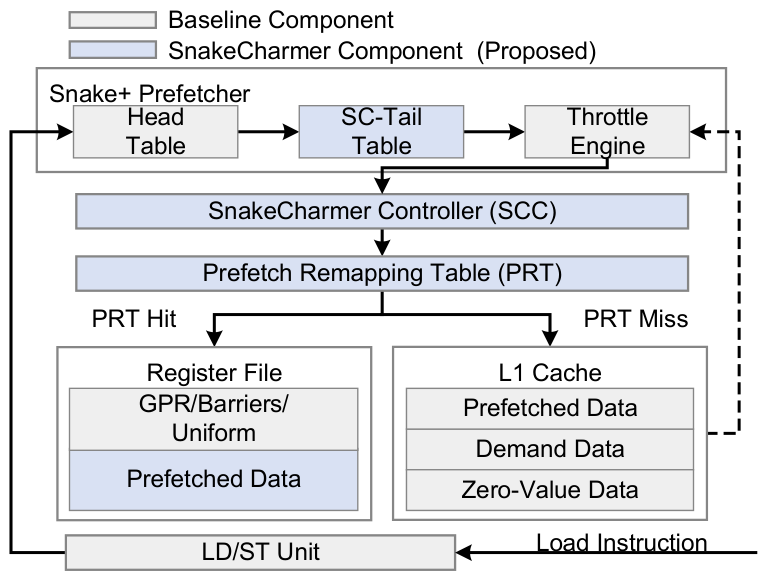
预测器提出候选,控制器决定发出,映射表决定数据进入空闲寄存器还是 L1。
作者以 AccelSim 和 AccelWattch 模拟 A100,在筛选出的 14 个应用上,相对 Snake 平均 IPC 提高 12.8%,性能每瓦提高 20.8%;接到 APOGEE 后分别提高 1.7% 和 3.2%。应用需满足理想预测准确率超过 50%、覆盖率超过 30%,结果因此体现后端兑现已有预测机会的价值。它是硬件架构研究,收益限于模拟内核执行,不等于现有 GPU 或 LLM 服务可直接获得同幅提升。