本期看点
两篇工作分别检查自动改进链路中的判断依据。Agent 平台可能持续收到正常格式的评分,却不知道裁判已经忽略了关键条件;训练程序可能返回接近零的损失,却因为浮点舍入丢失了本应存在的梯度。它们值得一起读的原因,是把“看起来正常”拆成了可以测试的机制。
优先关注自改进的准入条件。 这项研究将验证器是否可信、坏改动是否能恢复分开测量,直接关联 AgentOps 的发布控制;但它没有给出可通用于所有系统的安全阈值。Softmax 工作则提供具体的算式改写,在小型学习任务中追踪舍入错误如何变成训练尖峰和蒸馏漂移。前者适合设计自动修复流程,后者适合排查高置信度预测与近似教师蒸馏中的异常。
01 · 自改进准入:验证器要测量,旧版本要保留
Recoverability and Verifier Strength: Two Measured Preconditions for Unattended Agent Self-Improvement
De Wang、Peng Qi · 首发:2026-10-20 · NeurIPS 2026 Workshop: AgenticOS
自动修复还需要谁来把关
Agent 从失败轨迹生成提示词补丁、调用裁判并自动上线,已经构成一条自改进流水线。本文关注补丁生成之后的准入:裁判能否分辨好坏,判断错误后能否回到旧行为?相比只优化提示词得分,它把发布控制本身变成研究对象。
验证器强度用它与可信参考检查之间的 Matthews 相关系数衡量,记为 σ。总是通过的裁判可能因类别不平衡获得不错的准确率,这里的强度却为零。可恢复性则拆成三项:回退是否还需审批、恢复后任务结果与原来是否一致,以及上线期间改变了多少任务结果。最后一项提醒我们,恢复配置无法收回已经发出的回答或退款。
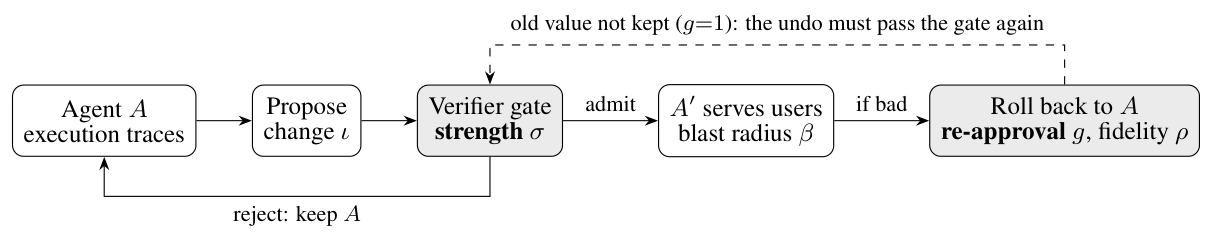
读图:从左向右看修改如何上线;下方是拒绝后保留旧版的路径,上方虚线表示旧版本丢失时,回退也会重新依赖裁判。
平台保存变更前的值,并登记验证器及其测得的强度。只有回退不需要重新审批、强度达到领域阈值时,才允许无人值守上线;缺少测量或旧版本时,明确记录无法自动决策。这里关键是实际保留了什么,而非简单按“提示词安全、权重危险”分类:保留旧适配器的权重更新同样可回退,作者平台仍因验证器不足而要求人工批准。
返回分数不代表理解了标准
作者测试生产平台的训练集多样性裁判,发现 37 种配置中有 9 种对不同失衡程度返回同一分数。它看似稳定,却可能没有执行“惩罚少数任务占比过高”的要求。删除待判断信号、检查接口设置是否实际生效,是论文提出的两类验收测试;模型、提示或请求格式变化后需要重测。
受控实验使用 τ²-bench 航空任务,50 题按 30/20 划分训练与测试,每题分别运行 2/4 次。参考检查结合数据库状态与沟通要求。LLM 裁判的 σ 为 0.70,但错误集中在少数任务,不能把重复运行当成独立样本。保存提示词再恢复,行为一致率为 0.95,与不做修改时的随机波动基线相同。
隐藏旧提示后生成的三份撤销补丁,则平均比其基线低 0.16;这组使用训练任务,而且三份均被准入检查拒绝,因此不能与前一组视为完全对称的线上对照。另有三项已接受修改,在 50 题上改变结果的比例比随机波动基线高 17 个百分点,95% 区间为 8–27 个百分点。成功变失败与失败变成功都存在,这不是“17% 的任务遭受损害”。
证据支持到哪里
值得精读的是测量框架与失败案例。 降低验证器强度后选中更差补丁的趋势未达到统计显著性,20 道测试题不足以确定通用阈值。端到端证据也只覆盖提示词修改,规则是在单个平台上事后应用,未证明工具、技能或权重更新在生产中都安全。继续阅读可重点看恢复实验与误放行率:即使总体相关性相近,误放行坏改动的风险也可能不同。
02 · Softmax 修复:保住本应存在的微小梯度
A Fix for Softmax and Cross-Entropy · 作者项目页
Jonathan T. Barron、Dan Gnanapragasam、Michael Tschannen · Google DeepMind · 首发:2026-10-22
减去最大值以后,错误仍可能发生
常见 softmax 先减去最大 logit,避免指数溢出。但当目标类别概率极接近 1,分母中的微小增量可能被舍去,目标梯度随之变成零,其他类别梯度却仍为正。论文称之为 Softmax Collapse:数学上应当和为零的一组梯度,在实现里失去了平衡。
第二个问题出现在软标签蒸馏。学生与教师 logits 已经很接近时,先各自求概率再相减,会丢掉细小差异;前向与反向采用的运算序列不同,甚至可能在两者 logits 完全相同时留下非零梯度。这是 Softmax Cancellation。单纯提高精度只能推迟部分问题,不能代替稳定的计算路径。
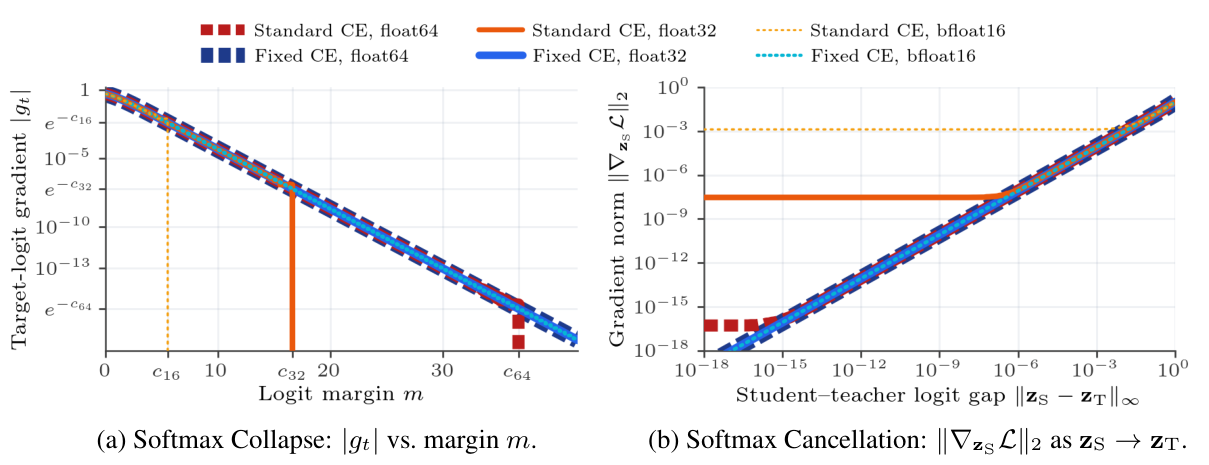
读图:左侧标准实现的梯度在不同精度阈值突然归零;右侧学生趋近教师时,标准实现留下噪声底。修复后的曲线继续跟随应有的小梯度。
改写计算路径,保留原来的目标
对硬标签交叉熵,作者把目标 logit 与其余类别的 log-sum-exp 之差定义为 margin,排除目标项后用稳定的 softplus 求损失。目标梯度由其他类别梯度的负和得到,避免先算出接近 1 的概率再减 1:
通用 log-softmax 则排除最大项,再以 softplus 合并。蒸馏修复直接接收教师 logits,用学生教师差值构造对数概率比,借助 expm1 与 log1p 保留接近零的信息,并校正梯度和。它改变的是数值实现,未另造一个替代学习目标;但只保存教师概率的蒸馏流水线,需要考虑 logits 输入这一接口条件。
小误差如何变成训练尖峰
作者将 Collapse 与 Adam 的状态联系起来:目标梯度消失后,二阶矩衰减;样本重新跨回精度阈值时,恢复的梯度被很小的分母放大,形成 Slingshot 尖峰。修复让梯度连续衰减,避免这次突然开关。
在模 31 加法任务上,作者用单层、宽度 64 的 ReLU Transformer,50% 训练划分,训练 10,000 个 epoch,采用全批量 AdamW、学习率 0.001、权重衰减 1。五个种子下,ε=10⁻⁸ 时 fp32 标准交叉熵测试准确率为 94.3±5.4%,修复后为 100.0±0.0%。实验比较了 bf16、fp32、fp64;ε 降至 10⁻¹⁶ 时,连标准 fp64 也会碰到自己的精度阈值。这支持修正公式,而不是只把计算升级到双精度。
蒸馏实验从完全相同的教师权重初始化学生,在模 53 加法上以温度 4、Adam 学习率 0.002、ε=10⁻⁸、无权重衰减运行 2,000 步。理论上学生不应移动;标准 bf16 出现漂移,fp32 出现短暂 KL 尖峰,修复后各精度均保持 KL 为零及 100% 准确率。这检验的是等价点的稳定性,不是新学生学习教师的效率。
阅读价值在算子机制与可诊断的边界。 原文没有适合的架构图,这里用完整的误差机制图说明问题。证据主要来自小型模运算任务;作者也指出极端 margin 与近零学生教师差距在常规大规模训练中并不常见。论文未提供可直接外推的生产吞吐基准,收益应结合实际损失实现、精度与优化器条件判断。