本期看点
Agent 失败后,指出一处可疑步骤是否意味着找到有效修复?ReplayRCA 用受控重放与安慰剂对照测量一次动作替换能否改变最终结果,并把事后诊断与实时监督分开。AIFaultBench 则整理真实 AI 软件故障、触发脚本与复现记录,为调试研究提供另一类证据:不是模型如何解释轨迹,而是原始故障能否在记录的环境中出现。
01 · ReplayRCA:用反事实重放衡量诊断和监督
ReplayRCA: Measuring Post-hoc Diagnosis and Live Oversight of Agent Failures by Counterfactual Replay
Jeremy Canale、Fabien Soulis · 2026-10-29
从标签一致性转向干预结果
长任务失败可能有多个有效修复点。若基准只比较诊断者选中的步骤与标注答案,另一处同样能修好任务的干预也会被判错。ReplayRCA 不把反事实重放本身作为新发明,而是把它放进评价协议:诊断者选一个步骤和替代工具动作,系统恢复到动作之前,让原执行 Agent 继续完成任务,再由终态检查器判断是否成功。
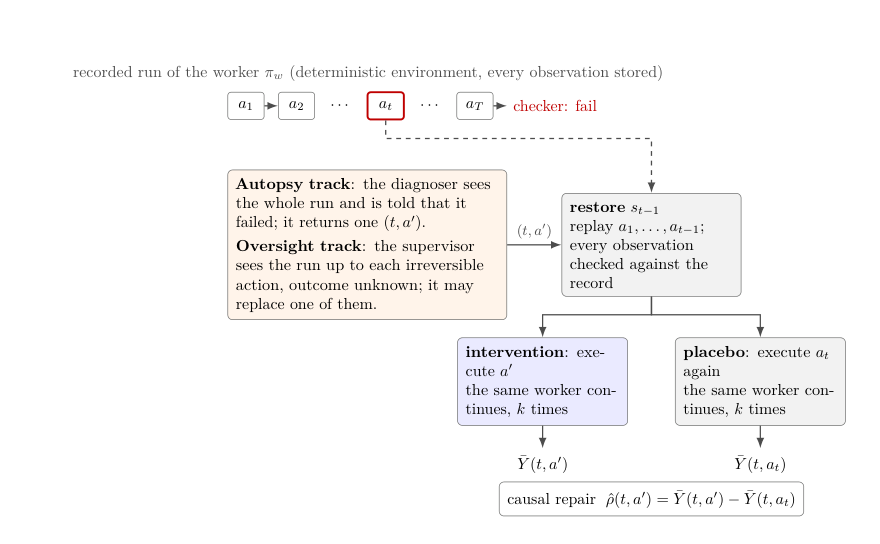
读图:两条支路从同一动作前状态恢复;左边执行替代动作,右边重放原动作,随后都由原 Agent 继续。两者成功率之差才计入干预收益。
对照很重要:随机续跑可能自己恢复,重启过程也可能影响结果。作者在两个分支各采样五次,用替代动作的成功率减去同一步重放原动作的成功率,称为 causal repair。环境是确定性的 OpsWorld:系统从初始状态重新执行历史动作,并逐字节核对观察结果,再实施干预;它不是直接对不可回滚的线上系统进行实验。
解释失败与防止失败是两项能力
事后诊断者看到完整失败轨迹,并被告知最终失败,可以选择任意一步替换。实时监督者只看到当前轨迹,在退款、取消等不可逆动作前决定放行还是替换;它不知道任务最终是否会失败,最多干预一次,且每次干预在评分中扣除五个百分点。成功任务也混入测试,因此无谓干预会产生代价。
在 62 个经过校准的系统性失败上,13 个模型中最高的事后因果修复得分为 +51.3 个百分点;但 78 组模型两两比较经多重检验校正后均不显著,不能据此建立可靠排名。强制一个模型只在最后一步干预,得分下降 17.1 个百分点,说明选择干预位置有实际影响。实时监督涉及 87 次运行;作者观察到一个事后表现较好的监督者在实时任务中表现最弱,同一批运行上两者相差 14.5 个百分点。
阅读判断:值得精读的评测协议。 它关注的是“一次替换动作能否改变结果”,并不保证找到最早的根因,也无法证明多步修复无效。任务来自可验证恢复的合成后台环境,外部副作用、复杂真实服务和更长时间跨度仍需另行检验;有限样本与不同模型推理配置也限制了模型间比较。
02 · AIFaultBench:把真实 AI 软件故障和复现证据打包
AIFaultBench: A Reproducible Benchmark of Real-World Faults in AI Software Systems
Mehil B Shah、Mohammad Masudur Rahman、Foutse Khomh · 2026-10-30
数据集包含 105 个仓库的 770 个故障,覆盖深度学习、LLM、Agent 等六类系统;每条连接原始报告、代码版本、环境准备、触发脚本和执行记录。作者对每个故障最多用三小时尝试复现,要求三次执行均满足匹配标准,最终记录 652 个复现成功、118 个未成功;后者包括硬件或数据不可用、版本漂移和非确定性等情况。
它与 ReplayRCA 互补:前者提供真实软件缺陷及复现材料,后者评价可恢复环境中的 Agent 干预效果。样本偏向活跃、受关注的公开 Python 仓库,复现比例不是所有 AI 系统的真实故障率;具体案例也可能依赖外部数据、硬件或凭据。原文没有适合说明该数据集机制的架构图。