Agent 遥测的成本经常来自重复内容和高基数维度,而不是缺少采样器。CNCF 这篇教程从六个实际运维问题反推保留字段,在同一份输入上比较原始与优化管线。它最有价值的部分,是把日志体积、指标序列数和 trace 结构分别处理,再用查询验证仍能回答原来的问题。
原文:Filtering and reducing AI agent telemetry with the OpenTelemetry Collector
Adnan Rahic, Bindplane by Dynatrace · CNCF · 2026-10-22
先问需要什么答案
作者用 Claude Code 修复两个失败测试并补边界测试,全部内容开关打开后,一次运行产生 181 条遥测记录、289 KB JSON。真正要回答的问题却集中在按模型计费、会话 token 与缓存占比、工具失败、用户拒绝修改、延迟和 API 错误。这些问题主要依赖计数器和简短属性,不必每次保存整份文件或 diff。
体积与基数是不同问题。Read 的输出可能把整个文件放进 span event;Write 参数又在日志中重复保存文件。指标则带 session.id、用户和账号属性,每次会话生成新序列。教程中 25 个会话、八类指标已产生 300 条时间序列。对单次调试有用的身份细节,放到舰队级指标里会变成持续增长的索引成本。
这种按问题裁剪的前提也很具体:如果目标是检查提示注入或复核 Agent 为什么修改了某行,正文和工具参数可能就是必要证据。因此本教程解决的是所列运维查询的成本,不能把“没有仪表盘读取”普遍等同于“没有审计价值”。
一份输入,双路比较
教程用一个 OTLP receiver,把 logs、metrics、traces 各分成原始和优化两路,总计六个 exporter,送入同一个 Grafana LGTM。对照路只补 service.name 并 batch,优化路加入处理器;同源分流减少了不同运行输入造成的比较偏差。
环境固定为 Collector contrib 0.161.0 与 LGTM 0.33.1。这里复制输入的目的是验证差异,正式部署若继续向同一后端保存双份,当然不会实现完整的存储节省。原始路可以按实际调查需求另行保留或停止,关键是让成本比较对应最终的数据生命周期。
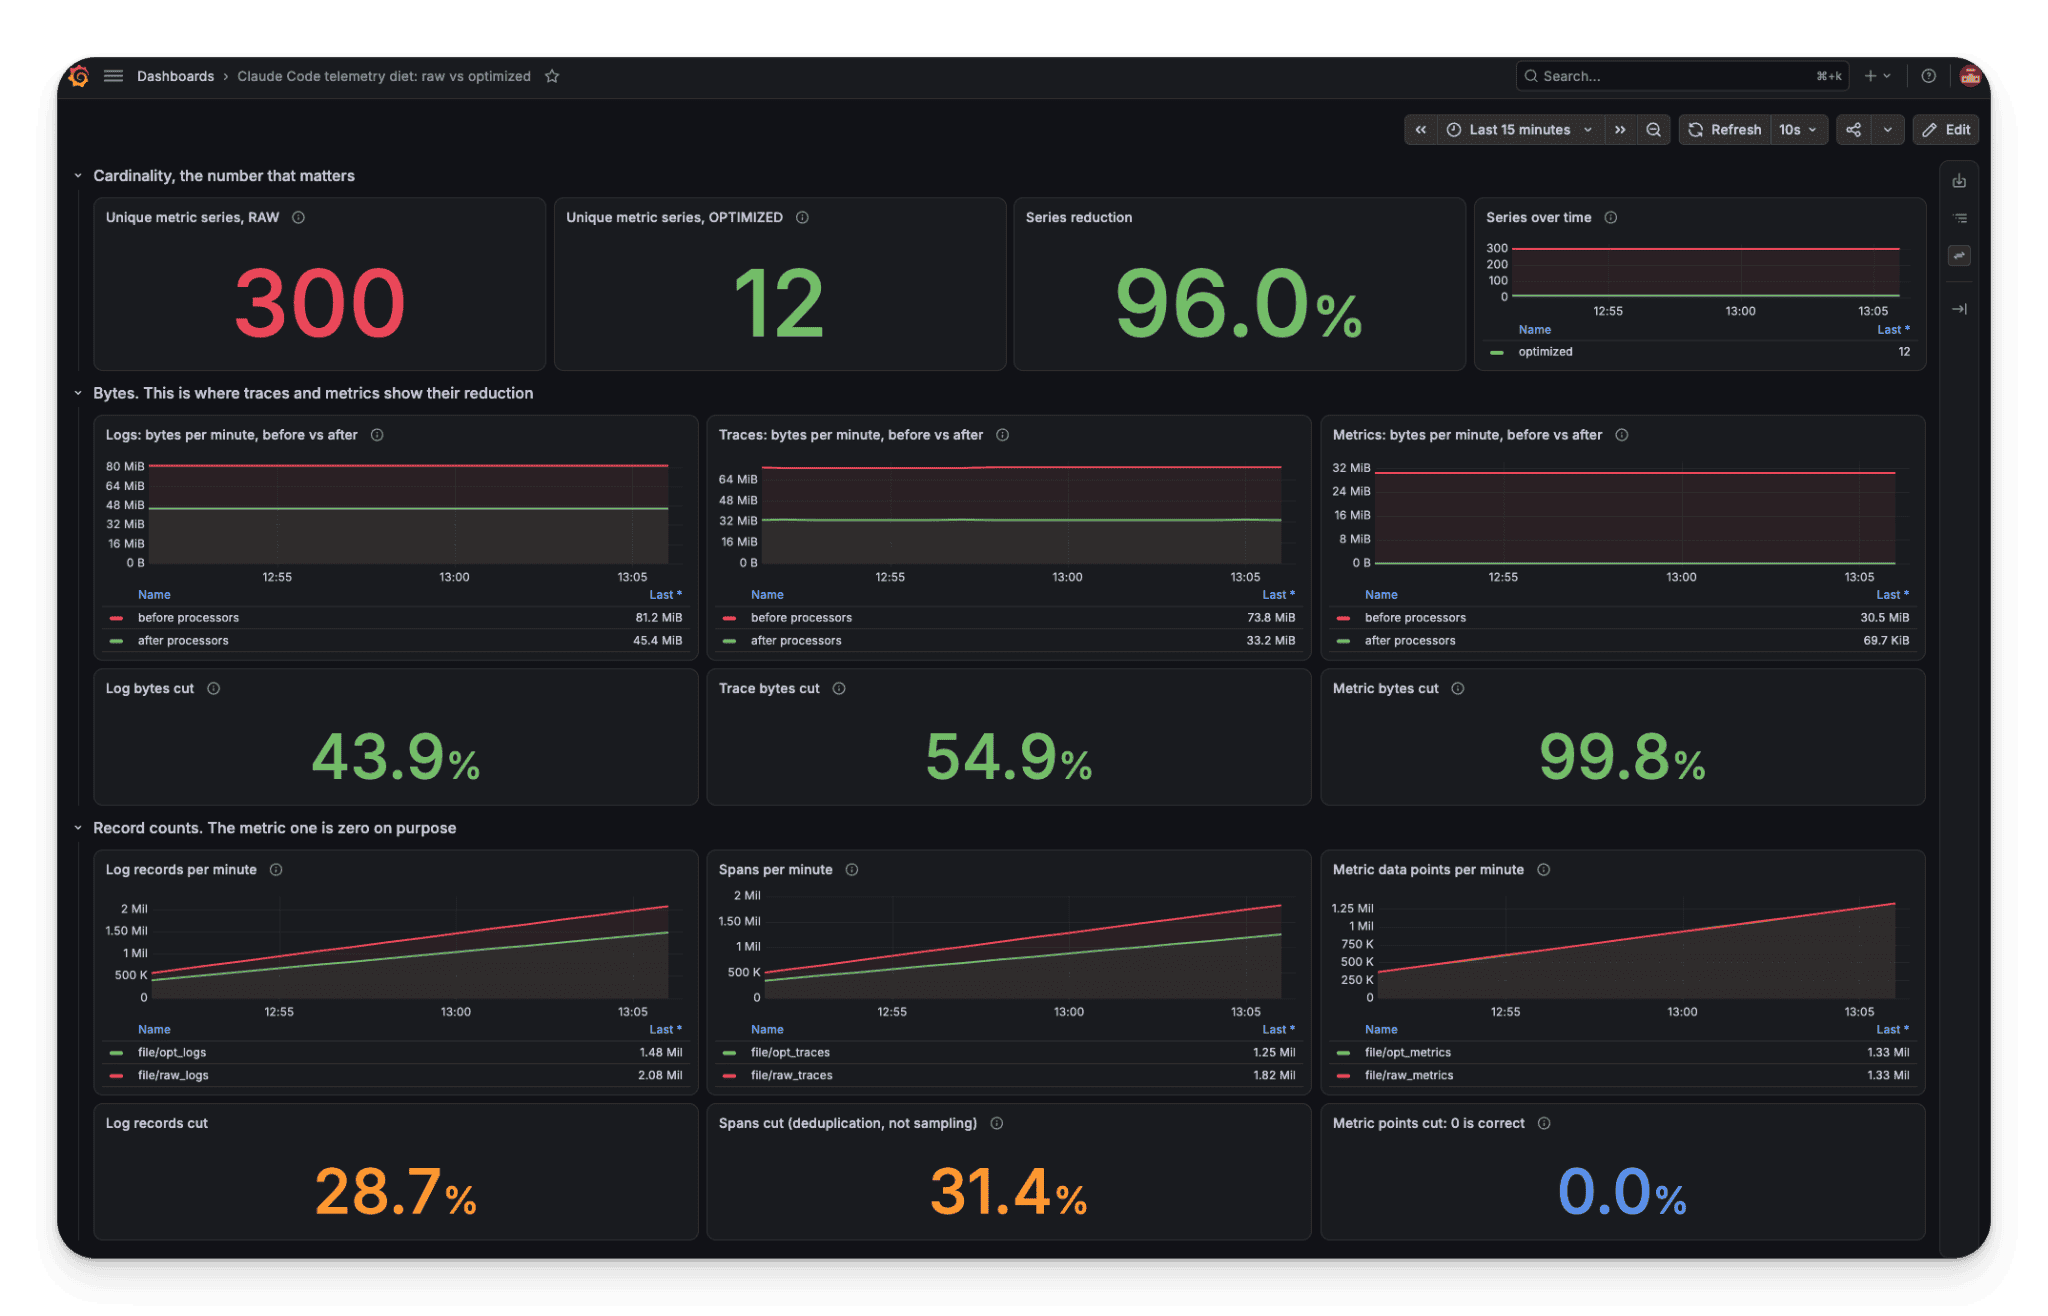
从上到下分别比较时间序列、各信号字节和记录数;这些指标对应不同类型的削减。
日志删除内容,指标删除维度
日志先丢弃主要信息已在其他信号存在的 api_request 事件,再移除 prompt、response、tool_parameters、主机路径等字段,保留长度趋势。session.id 与 user.id 做 SHA-256 后截到 16 个十六进制字符,错误文本上限 256 字符。作者发现完整 64 字符摘要替换 36 字符 UUID 反而增大字节量,这解释了为何格式选择也影响成本。
工程上还需区分缩短标识与匿名化:确定性摘要仍可关联同一个身份,截断也引入碰撞可能。它改变的是显示和存储形式,不自动提供隐私保证。对需要跨信号关联的场景,各条路径还必须采用一致转换,否则节省几个字节可能换来无法追踪会话。
指标侧删除六个会话/身份维度后,300 条序列降为 12 条。但不能止于删标签:多个会话的 delta 数据现在落到相同序列,而 Prometheus 需要 cumulative,转换器又依赖时间顺序。教程先以两秒窗口收集,归并资源,统一窗口内时间戳,按剩余属性求和,最后做 delta_to_cumulative。
作者测得优化与原始总量相差不超过约 0.5%。这是该窗口方案下的验证结果,不代表任何分布式管线都自动保持精确。原文明确要求一个 Collector 看见所有会话;若请求被负载均衡到多个实例,聚合应放在合适的单一 gateway,或者另行设计可靠的分区与合并机制。
Trace 保留结构,也会失去内容
Trace 管线删除成功且无 error_class 的 tool.execution 子 span,因为父 span 已有工具名、时长和结果 token;其余变换去掉重复属性,保留通用 gen_ai.* 名称,并尝试清理可能带密钥的命令字段。大段 content、output、diff 设 512 字符上限并标记被裁剪。
这些操作没有按概率抽样整条请求,但确实删除了 span 和字段。因此“没有采样”不等于“没有信息损失”。原文示例中,spanevent 的赋值条件只覆盖超过 512 字符的内容,后续却无条件删除原字段;照搬片段可能连短内容也丢失。这是代码审读发现的边界,部署时应明确短内容保留分支,并用真实事件核对。
尾采样被放在后续选择中:例子保留错误、慢 trace 及其余的 10%,decision_wait 为 120 秒。多分钟 Agent 任务可能在决定之后才发生失败,晚到 span 如何处理就直接影响可追查性。单纯增加等待也会增加状态保存压力,不能只按节省比例选参数。
验证的是查询能力,不只是曲线变绿
官方仪表盘显示序列从 300 到 12,示例字节削减为日志 43.9%、trace 54.9%、指标 99.8%。这些是教程展示的流量结果,不是所有 Agent 的固定节省率;记录数、序列数和字节量也不能混为同一个指标。
教程启用 detailed 自遥测与发送队列,以 exporter 标签比较字节,再检查六类业务查询是否仍有答案。更完整的工程检查还应覆盖总量守恒、事件关联、裁剪标记、错误样本与长会话。文章推进的是“按信号语义减量”的思路:去掉重复和无用维度,往往可以先于抽样;但每一次删除,都要由仍然需要完成的诊断任务来约束。
处理器顺序也是数据语义
原文强调先合并会话,再把 delta 转 cumulative,这个顺序不仅是实现细节。若先转换,每个原始会话各自累积,再在下游删掉身份,可能让本来独立的累计序列碰到同一个标签集合;若先删标签却不合并,转换器又可能把重叠时间点当作冲突。去掉维度改变了“一个计数器代表谁”,所以必须同时重新定义聚合单位。
统一时间戳会把细粒度发生时间压进窗口。这对费用总量或 token 趋势可能足够,对短暂尖峰和精确时间关联则可能不够。教程验证了总量接近,后续还需按实际告警窗口检查峰值是否被平滑。把总量、时间分辨率和事件可追查性分别列出来,才能说明优化保留了哪些答案、放弃了哪些答案,而不把所有减少都称为无损压缩。
因此,优化验收应保留一组真实问题及预期答案。配置更新后再次执行相同查询,能更早发现字段名变化或处理顺序改变造成的语义回归,而不必等到事故中才发现证据缺失。