服务全部返回成功,用户得到的结果仍可能越来越差。Mallika Rao 的架构文章把这一现象放到分布式系统的语境中:当系统在运行时选择工具、证据和后续步骤,可靠性就需要观察决策是否合适,而不仅是请求是否完成。它提供的是设计分析与模式讨论,没有给出新算法的性能实验。
原文:From Microservices to Agents: the Next Evolution of Distributed Systems
Mallika Rao · 审阅:Rafał Gancarz · 首发:2026-10-19
新增的不确定性在哪里
文章以微服务的功能拆分,对照 Agent 的决策拆分,并从控制流、上下文状态和失败语义讨论变化。这个对照适合指出设计重心,却不宜理解为传统分布式系统没有动态路径、语义错误或质量退化。更准确的工程判断是:模型参与选择执行路径后,原来隐藏在业务逻辑中的决策质量,需要更明确的运行时记录。
例如,一个假设的检索系统可能快速、无错误地读完三个数据源,但第一步选错了数据源,后续排序再准确也找不到被排除的证据。网络成功率解释不了这种失败。诊断需要同时知道当时有哪些候选、选择依据是什么、实际读取了什么,以及最终任务是否满足用户意图。
这个例子也说明,记录更多文本并不自动等于更可观测。若只保存最后答案,无法定位信息在哪一步丢失;若保存所有中间输出却没有关联关系,也难以还原路径。可操作的目标是保留足以连接“输入、选择、动作、结果”的结构化事件,而不依赖无法验证的内部思维描述。
规划与执行之间要有可检查的边界
原文讨论规划与执行分离、专门化 Agent、运行时评估和工具抽象层。它们分别试图控制推理变化、职责范围、输出质量与接口差异,同时增加了协调成本。
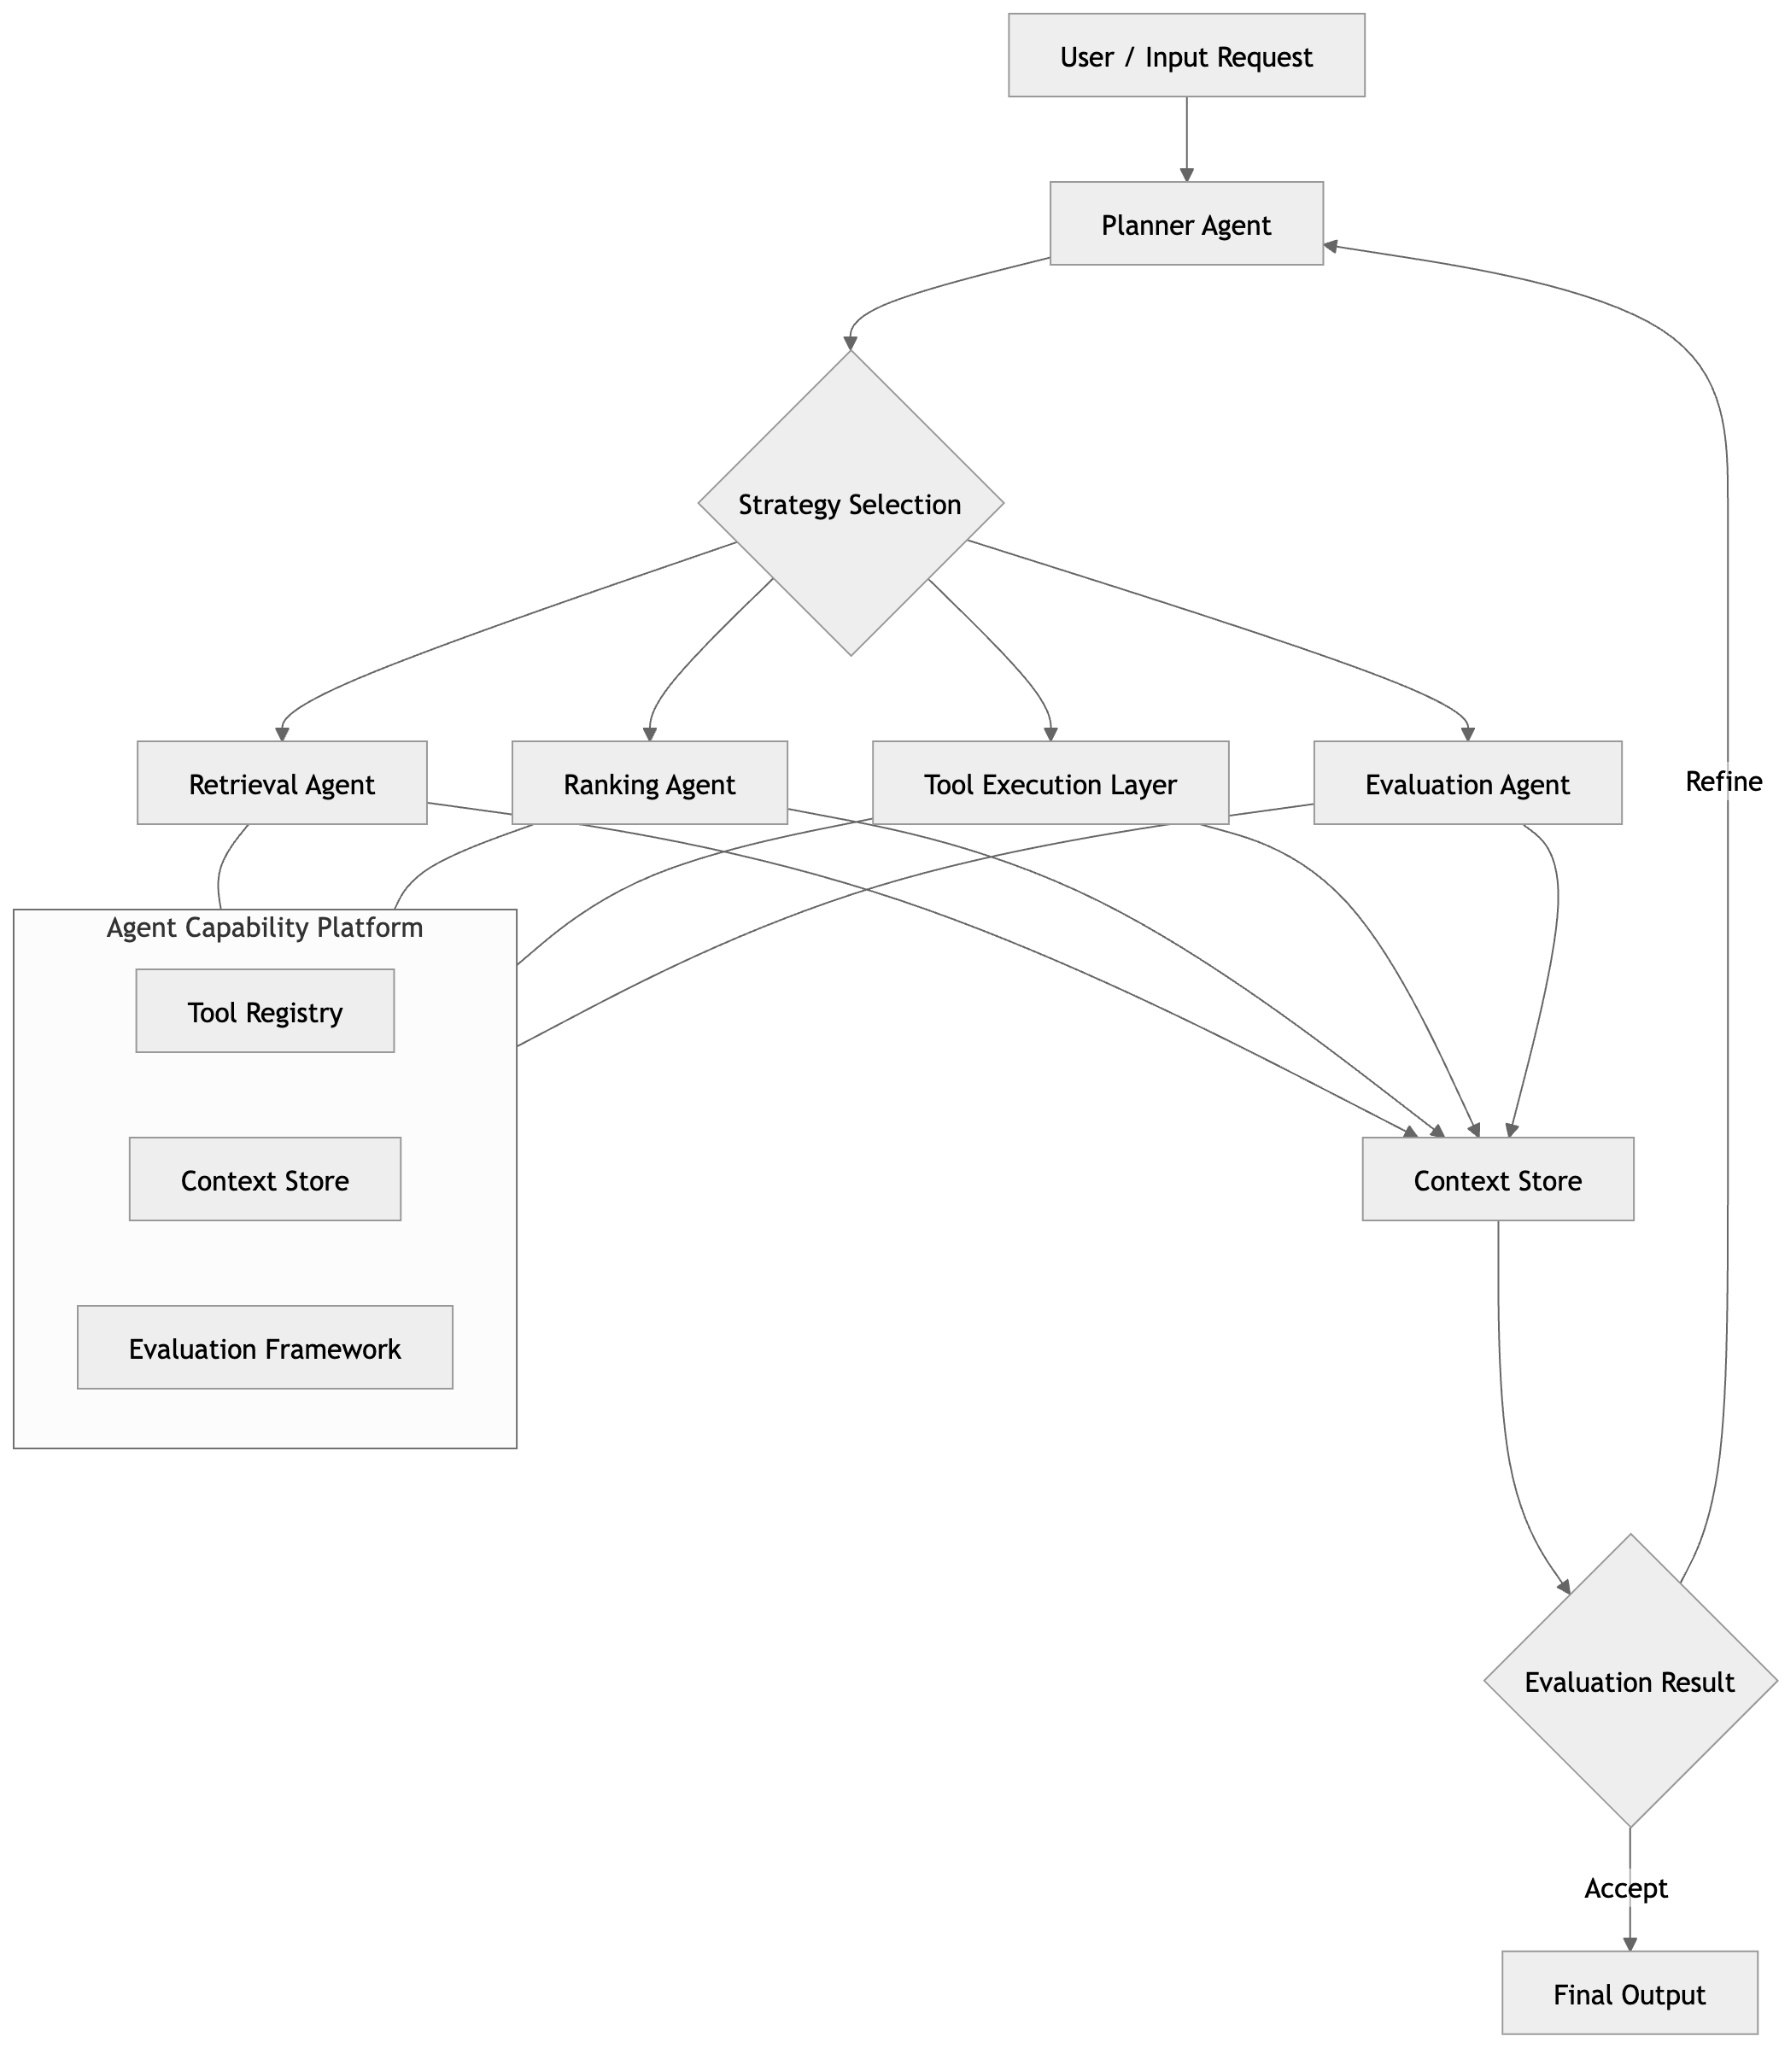
读图:从上方请求进入规划器,沿中间能力分支执行,右下评估结果决定接受还是回到规划。图为原作者借助 ChatGPT 制作的概念示意,不能当作已验证的部署拓扑。
从这些模式可以推导出一个实现原则:计划应被当作待验证的执行输入。工具参数是否合法、操作权限是否匹配、结果格式是否满足下游要求,都可以有独立于模型的检查。这样即使计划有问题,也有机会在扩大影响前发现。反过来,形式检查通过仍不保证计划实现了用户目标,语义评价不能完全交给接口校验。
职责拆分也有成本。增加一个评估 Agent,会增加等待、上下文传递和新的误判来源;增加一个专业 Agent,则需要说明谁对共同状态负责。模块更多并不天然更可靠。只有当责任边界能帮助定位错误,且协调开销可接受时,拆分才有清晰收益。
质量反馈也可能形成负载放大
文章特别关注质量驱动的重试:一次输出被判为不足,系统继续补查、改写或重新规划。每轮动作都可能合理,但整个循环未必收敛。评价器若长期不满意,就会不断消耗推理和后端服务资源。
由此得到的工程问题是,重试预算应该跟随任务整体,而不能仅由每个节点各自计算。若上游允许多轮规划,下游工具又各自重试,组合后的请求数可能超过设计者对任一模块的预期。观察单次调用耗时无法反映任务实际花费;需要把累计时间、调用量和退出原因联系起来。
退出条件还应区分“已经满足目标”“预算耗尽”和“证据不足”。三种状态都可能结束执行,却有不同的用户含义和后续处理方式。把它们全部包装成成功,会使质量退化继续隐藏在健康的基础设施指标下面。这是对有界自主性的具体解释,并非文中已经验证过的一套协议。
上下文是会改变决策的状态
Agent 的状态可能包含检索文档、工具结果、当前计划与用户最新约束。多个组件共享它时,问题不仅是有没有收到数据,还包括收到的是哪个版本、适用于哪一步,以及旧结论是否仍有效。
可以设想用户改变需求后,一个工作分支继续使用旧目标,而另一个已按新目标评估。两边各自都可能输出合理结果,组合起来却相互矛盾。共享存储本身不会解决这种语义冲突;仍需要定义任务版本、可见性和哪些结果允许继续向下游传播。
这也是传统状态管理经验仍然重要的地方。Agent 没有消除所有权、一致性与过期数据的问题,只是让它们更容易通过答案质量表现出来。架构设计应说明状态寿命与更新规则,而不是仅在图中放一个 context store 就认为记忆问题已经解决。
从健康指标走向任务证据
原文建议跟踪工具选择、评估结果、回退与重试行为,并采用有边界的自主性、确定性回退和渐进发布。作为工程延伸,可以把这些信号与任务成功样本关联:某工具使用率突然变化可能是问题,也可能是流量类型变化,单个行为指标不足以确定原因。
回退也需要明确能力边界。固定路径通常更容易预测,却可能只能回答较窄的问题;评估质量时应区分完整完成、降级完成与无法完成。影子执行能比较两条路径,但如果只比较输出是否相同,可能把共同错误当成稳定性。
落实这些原则时,可以先选择一条高价值任务路径,定义它的输入契约、状态更新和成功判据,再逐步增加自主决策。这样比较前后行为时,有一个可解释的参考路径。若一开始同时改变工具、记忆、规划和评估,质量发生变化后往往很难找到责任边界,观测数据也未必足以支持归因。
这篇文章适合作为架构评审的提问框架。 它没有提供定量基线、故障注入实验或某套架构的可靠性保证,因此不能据此声称多 Agent 必然优于既有服务。最值得带走的变化,是把决策路径、状态版本和任务退出条件纳入系统设计,并为每个质量判断保留可检查的证据。