David Morrison(drmorr) · Applied Computing Research Labs · 2026-10-05 · 原文
扩容已经成功,用户却还在等:新节点加入了集群,Pod 也绑定了节点,但应用仍在启动,积压请求还没有处理完。这篇文章提出 MTSS(Mean Time to Stop Sucking),把关注点从基础设施动作完成,移到用户体验何时恢复。它最有价值的提醒是:缩短某个控制器的耗时,不一定缩短用户遭遇性能退化的时间。
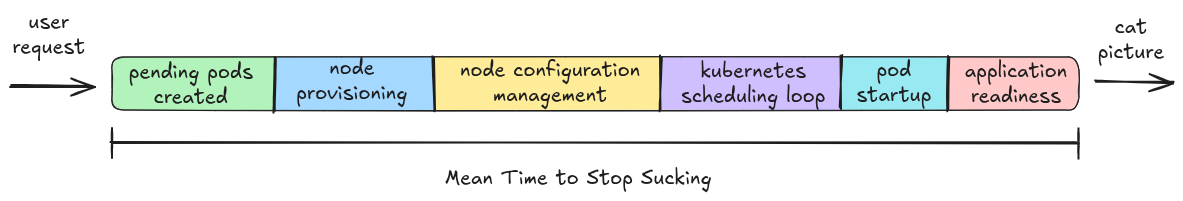
原文的扩容阶段示意。色块宽度不应当作某个生产系统的实测耗时。
先给“恢复”一个明确的判定
下面是一种基于这一观点的工程化测量方案。它以一次负载事件为统计单位,不把每个新 Pod 都算成一次独立恢复。
设 $t_0$ 为入口首次出现持续容量压力、且用户侧指标开始违反预先约定目标的时刻。设 $t_r$ 为服务指标首次重新满足目标、并且随后在观察窗口 $W$ 内持续满足目标的时刻。单次恢复时间定义为:
若一次负载事件始终没有违反目标,应记为“无退化”,并报告这类事件的占比,不把正常扩容耗时填入恢复时间。对真正发生退化的事件再汇总均值和分位数。
这里的目标应同时包含延迟、错误率和最低服务量。只看成功请求的延迟,可能把大量拒绝请求的系统误判为恢复;只看 HTTP 成功率,也可能漏掉排队越来越久的异步任务。队列消费者更适合同时观察最老消息等待时间、完成吞吐和积压量。
窗口 $W$ 用来避免一次短暂回落就结束事件。离线分析可以把恢复起点记为 $t_r$,在线确认则至少要等到 $t_r+W$。需要把这两个时间分开,否则修改观察窗口本身就会改变所谓的恢复速度。
把一条时间线拆成可归因的阶段
| 边界 | 记录什么 | 能回答的问题 |
|---|---|---|
| 用户侧压力出现 | 入口流量、延迟、错误与队列等待 | 何时开始产生业务影响? |
| 伸缩决策产生 | 目标副本变化及触发指标 | 控制器是否及时看到了压力? |
| Pod 创建与绑定 | Pod UID、创建时间、节点绑定时间 | 等待调度或容量供给多久? |
| 实例可以接流量 | 启动与 Ready 状态转换 | 新副本何时开始贡献服务能力? |
| 服务重新稳定 | 业务目标及持续观察窗口 | 用户体验是否真正恢复? |
Karpenter 的 karpenter_pods_unbound_time_seconds 衡量 Pod 创建到绑定;它不能覆盖创建之前的负载感知,也不能表示绑定之后的业务恢复。该指标在当前文档中标为 alpha,实际采集前应核对集群版本。Karpenter 指标说明
Ready 则是另一种边界。Kubernetes 用 readiness probe 判断容器是否可以接收流量,startup probe 用于保护较慢的启动过程。它们反映配置好的健康检查条件,并不是端到端延迟目标的自动证明。Kubernetes 探针说明
为什么 Ready 之后还可能继续慢
一个容易遗漏的阶段是清空积压。考虑一个简化队列模型:新容量可用时还有 $B$ 个任务待处理,之后到达速率为 $\lambda$,处理速率为 $\mu$,且二者近似恒定。当 $\mu>\lambda$ 时,清空积压的时间近似为:
这不是原文的实验结果,而是解释恢复尾部的简化推导。若扩容后处理能力仅略高于新请求的到达速率,积压仍会消退得很慢;若 $\mu\leq\lambda$,仅等待不会让队列清空。实际系统还会受任务长度差异、重试及共享下游限制影响,不能把这个公式直接当作精确预测器。
队列清空并不是所有服务的恢复条件;这里用它解释积压为何延长恢复尾部,实际终点仍以约定的业务指标为准。
因此,排查时要区分两个问题:新容量来得是否及时,以及来了以后是否足够有效。只优化节点启动,而不观察服务吞吐与积压,可能把等待从一个阶段挪到另一个阶段。
关联事件,而不是硬拼一个超长 Trace
用户请求、HPA 决策和节点创建通常不是天然的一条同步调用链。一批请求可能共同触发一次扩容,一次扩容也可能创建多个 Pod。把所有事件强行做成单一父子关系,会掩盖这种多对多结构。
一种实现方式是为负载事件建立独立记录,关联工作负载、命名空间、伸缩对象、Pod UID、节点标识及时间窗口;请求追踪用于定位用户路径,控制面事件用于解释容量变化。OpenTelemetry 支持 span links,可表达不适合普通父子关系的关联;但部署追踪系统本身不会自动补齐伸缩控制面的事件。OpenTelemetry Traces
还要记录时间戳来自哪个组件,以及采集延迟。并行创建的多个节点不是串行等待,不能把各节点耗时相加;各阶段分别统计的 P95,也不能相加后当作端到端 P95。先保留单次事件的时间线,再做跨事件聚合,才能同时看到总时间和瓶颈。
调控制周期前,先确认是哪一个循环
HPA 是周期性控制循环,扩容反应还受指标采集与传递影响。更快执行循环,只能减少其中一部分等待;如果读到的指标已经滞后,循环更频繁也未必及时。HPA 工作方式
KEDA 文档进一步区分了从零激活与已有副本继续扩容:从 0 到 1 的触发检查由 KEDA 处理,从 1 到 N 仍涉及 HPA 的指标查询与控制过程。不能把调小 pollingInterval 理解成整个扩容链路统一加速,也不能把用于缩到零的 cooldownPeriod 当作扩容等待时间。KEDA ScaledObject
指标选择同样需要验证。一个可测试的假设是:对排队型工作负载,队列年龄或到达量可能比平均 CPU 更早暴露压力。但这取决于任务成本与瓶颈位置,应该用相同流量回放比较触发时机、恢复时间及额外资源消耗,而不是预设某一种指标永远更好。
用什么实验判断优化是否有效
可以从阶跃负载、短突发、缓慢爬升三种流量形态开始,并分别保留热容量与需要新建节点的场景。每次仅改变一个因素,例如控制周期、节点初始化或应用预热,记录恢复时间分布、受影响请求数和资源成本。
超时仍未恢复的事件不能从平均值里删掉:应单独报告未恢复比例,并标明这些观测在截止时刻仍未结束。否则,一个经常失败的策略,可能因为只留下少数成功事件而显得特别快。
这也给混沌实验一个明确目标:对镜像拉取、节点注册或应用预热分别引入受控延迟,观察业务影响怎样沿扩容链路传播。需要隔离“容量不足”和“应用本身故障”;增加副本并不能自动修复逻辑错误或下游故障。
最终值得比较的是:在相同负载与资源约束下,用户遭遇退化的时间是否缩短、损失是否减少。原文提供了这个观察视角;事件定义、稳定窗口和上述实验流程,是将它转成可检验工程问题的进一步推导。