Agent 的一次任务可能跨过模型、服务端工具、客户端工具和多个会话轮次。只看到最终回答或一次 API 的总延迟,很难判断时间花在哪里,也难以从失败中挑出可重复评测的案例。Claude Platform 的这次更新让 Managed Agents、Messages API 与 SDK 的执行轨迹以 OpenTelemetry(OTel)形式进入已有观测工具,减少连接这些视角所需的专用接线。
官方公告:Agent observability on the Claude Platform
Anthropic · 发布:2026-10-14 · 配套:OpenTelemetry for the Claude API
标准接口带来的变化
公告宣布公开 beta,使用 GenAI semantic conventions,并可向接受标准 OTLP 的观测后端导出。已有日志、指标与请求 trace 的团队,可以把模型调用、工具使用、延迟、token 和标识符放到同一套分析环境。这里新增的是执行证据的连接能力;自动识别原因或改进 Agent,仍取决于后端分析和评测设计。
一个 trace 表示请求贯穿系统的记录,span 表示其中一步。为了判断一次任务为何慢,通常需要看到模型前后还有哪些等待、工具和应用逻辑。只增加更多孤立日志,未必能恢复这些父子关系;有共同上下文的 span 才能将局部事件放回具体请求。
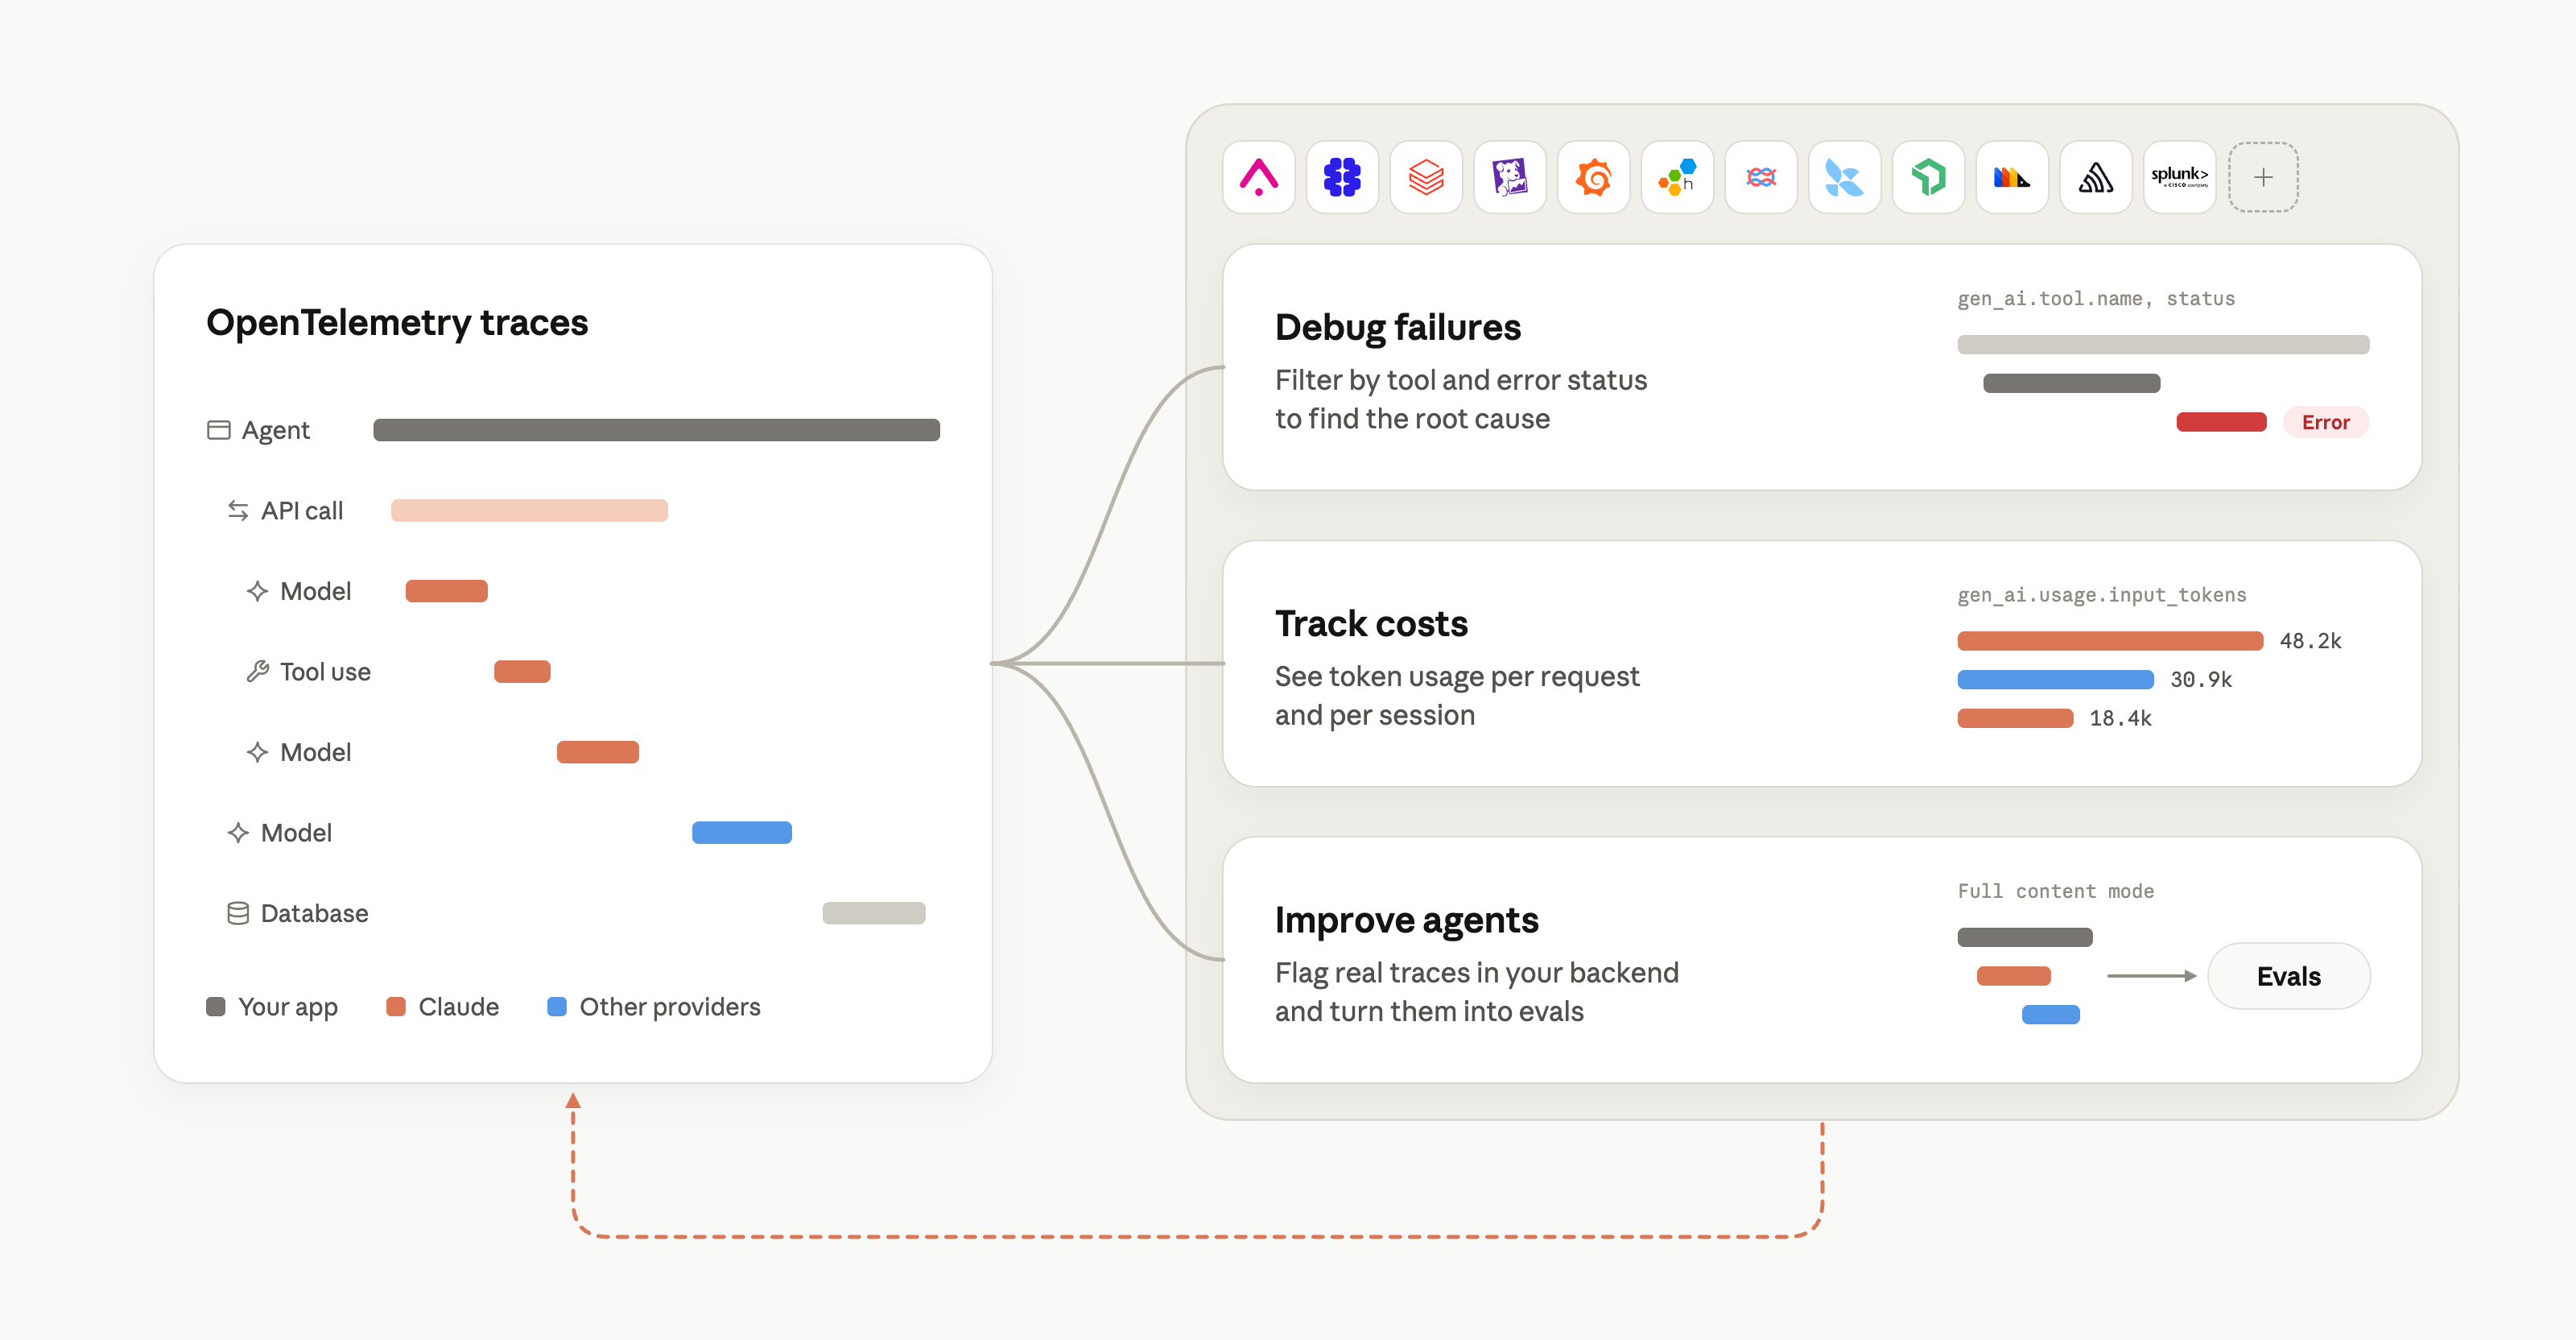
左侧把应用、Claude 和其他提供方的步骤放进时间线;右侧分别利用工具状态、token 用量和内容构造诊断与评测视图。
SDK 与 API 各自能看到什么
官方文档将采集分为两条路径。SDK tracing 需要注册 tracer provider,观察客户端请求、tool runner 执行的本地工具等;API tracing 则由管理员在 Console 配置目的地,提供服务端模型运行、服务端工具和 Managed Agents turn 等信息。两者同时开启,才能将一次客户端调用与服务内部步骤连起来。
例如模型先使用服务端搜索,再要求一个应用侧天气工具,客户端 tool runner 执行后把结果送回。一次用户任务包含两次 Messages 请求和中间的本地工具;只看 API 会缺少本地执行,只看 SDK 则缺少服务内部模型运行。这是采集覆盖的差异,不是通过给每条记录增加字段就能弥补的。
因此,公告所说的 SDK 自动导出应结合文档里的初始化条件理解。接入时应先决定哪里产生应用根 span、谁负责客户端和服务端采集,再检查一条真实任务链是否连接完整,而不只确认后端出现了新数据。
内容可见性与存储负担需要一起决定
默认 metadata-only 模式包含标识、时间、状态、token 数,以及应用主动提供的 Agent/工具名称与描述等文本。Full content 才加入模型输入输出。前者适合延迟、调用结构和用量分析,后者更有利于理解语义失败、建立评测;它也把对话内容带入观测平台的访问控制和保留策略中。
文档给出的默认每 span 内容上限为 0.75 MB。超限会截短并设置 anthropic.content.truncated;请求 span 优先去掉系统提示和最早消息,工具 span 从结果尾部删块。图像和文档只表现为类型。因而即便打开完整内容,也不能假设一条 trace 总能重建完整多模态输入或长对话。
对诊断而言,这不是旁枝:如果缺失的早期指令决定了任务约束,仅凭保留下来的尾部内容可能得出错误解释。工程上应把截断标记带入案例筛选,并按后端可接受大小设置限制。扩大上限能保留更多上下文,也会增加传输和存储负担;需要以具体诊断问题决定是否值得。
会话不总等于一条 trace
Managed Agents 的后续请求可能从新的根 trace 开始,多 Agent 还可能有多个线程。文档用 gen_ai.conversation.id 关联一个线程,用 anthropic.session.id 跨 trace 聚合整个 session。按时间排序有助于读执行顺序,但不能把仅按时间接近的事件自动当作因果关系。
这意味着观测界面的默认“请求树”未必就是任务全貌。评测一个多轮失败时,需要先找到会话与线程边界,再区分某次模型决策、工具结果和之后的继续执行。否则,缺少前一轮上下文的案例可能被误标为模型无缘由地偏离目标。
Token 统计最容易在层级间重复
同一次 Messages 请求可以同时有 SDK client span 与 API server span,API 下又有模型 span。用量可能在多个层级重复出现。官方建议每次请求只选择一个来源;同时存在 SDK 与 API 时采用 API,再在请求层或模型层二选一,不能全部相加。Managed Agents 则使用模型运行与 outcome evaluation 的 span。
导出重试还可能产生重复 span,需要按 trace ID 与 span ID 去重。输入 token 已包含缓存读写相关 token,不应再次加上缓存字段;上下文压缩也有专门用量规则。这里的工程教训是:一个可视化上看起来更完整的树,若直接求和,反而可能得到更错误的成本数字。
更根本的是投递为 best effort,span 可能丢失,调用者也能通过采样标记使请求不导出。因此 traces 不构成完整用量账本;需要按 API key 完整跟踪使用情况时,应使用 Usage API。监控缺少事件与服务没有发生事件,必须分开理解。
从轨迹走向评测,还差一次明确的标注
官方图把真实轨迹送入评测,这条箭头需要具体工作才能成立。一个工具返回成功状态,并不说明返回内容足以完成任务;一个模型调用没有报错,也不说明最终答案符合用户约束。以下是基于采集能力的工程推导:可以先用状态与时延筛选值得检查的案例,再结合必要内容和任务目标给出结果标签,最后把输入与预期行为保存成可重复的评测。
这样做也能避免把观测覆盖率当成可靠性分数。新增 span 可能让过去看不见的失败首次显现,短期内记录的错误更多,却不表示系统退化。对改动前后进行比较时,应固定案例定义、内容保留条件和关联方式,并区分采集变化与实际行为变化。OTel 统一传输和字段语义,减少接入负担,但不会替团队决定什么叫一次成功的任务。
结果与阅读价值
公告中的 Ramp 客户案例称,其 Reflect 系统在部分 Agent 上已减少 10–20% token 使用、让 session 快 30%。这属于客户现有改进循环的经验,不能归因为此次原生 OTel 导出的独立效果;公告没有提供受控性能评测。
值得关注的是标准化证据入口。 它让运行诊断、成本分析和失败案例评测更容易共享同一段执行历史。真正应用时,先选一个具体问题,例如哪类工具错误拖慢任务,再确认对应 span、内容和会话关联足以回答。可观测性提供分析材料,任务是否正确、权限是否合适以及一次改动是否有效,仍需独立的判断标准。