Meta Team: Daohang Shi, Oleksandr Stashuk, Rupert Wu, Liangbei Xu, Rich Zhu
原文:Modernizing Table Batched Embeddings with FBTriton · 代码
稀疏算子为什么值得重新设计
推荐模型的 embedding 表把离散 ID 映射成向量。一次请求可能访问多张表,每张表又含多个 ID;Table Batched Embedding(TBE)把跨表查找和池化合并,减少逐表启动内核的开销。难点在于访问不均匀:有的行只用一次,有的热门行被成千上万次引用。矩阵规模相同,执行瓶颈也可能完全不同。
FBTriton 的价值在于重新划分工作单位,而非把 CUDA 逐行改写成 Python。前向关注如何读取并累加稀疏行,反向关注如何收集同一行的所有梯度并恰好更新一次。原文展示的是推荐系统 TBE 工程优化,不能外推为普通 LLM 的通用加速。
前向:通用路径旁边保留窄范围特化
通用前向路径让一个 program 遍历多张表,按索引抓取向量并池化。FP16/BF16 权重用 FP32 累加,FP32 权重则用 FP64,以降低大维度累积误差。索引范围小于 2^31 时可配置 int32,减少索引与排序成本,默认仍为 int64。
小表可以先统计每行出现次数,再计算“计数×表”,把不规则读取转成 tensor-core 运算。但快路径条件很窄:单个特征 E≤64、64≤D≤128、池化长度 L≥64、FP16 权重、FP32 输出、无逐样本权重且无可变批处理 VBE。每个 program 处理 16 个 bag,先统计前 256 个索引,剩余部分走标量路径;其他形状回到通用核。
边界检查也不能省略。融合检查仅适用于部分配置,offset 验证和修复仍有独立小核,开关默认关闭。这种安排让优化有明确入口及回退,而不是让所有输入都承担一种激进假设。
反向:把“样本访问了谁”转成“谁访问了这一行”
同一 embedding 行可能被多个 bag 引用,反向必须将相关输出梯度相加,再执行一次优化器更新。输入转置、排序和游程编码把索引重组成 run:每个 run 对应唯一的表与行,记录所有引用它的样本。run 长度 SL 决定工作量,可能从 1 延伸到数百万。
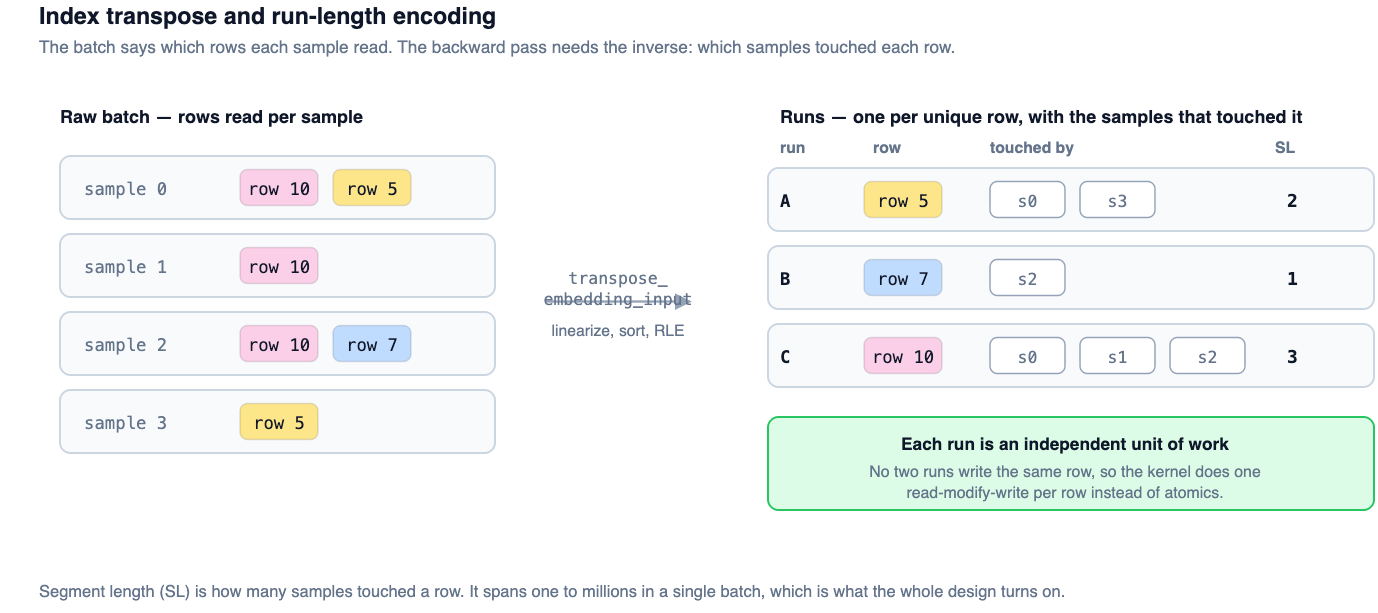
读图:左侧每个样本列出访问行,右侧按行汇集样本;row 10 对应三个样本,形成长度为 3 的独立更新任务。
SL<256 时,一个 program 完成读取、寄存器累加和更新,独占该行可直接写回。SL≥256 则拆成每块 256 次查找的子任务,默认先存部分和,再由另一个内核更新。这样热门行不再把整台 GPU 拖在单个长任务上,也避免短 run 过早支付跨线程块协作的代价。
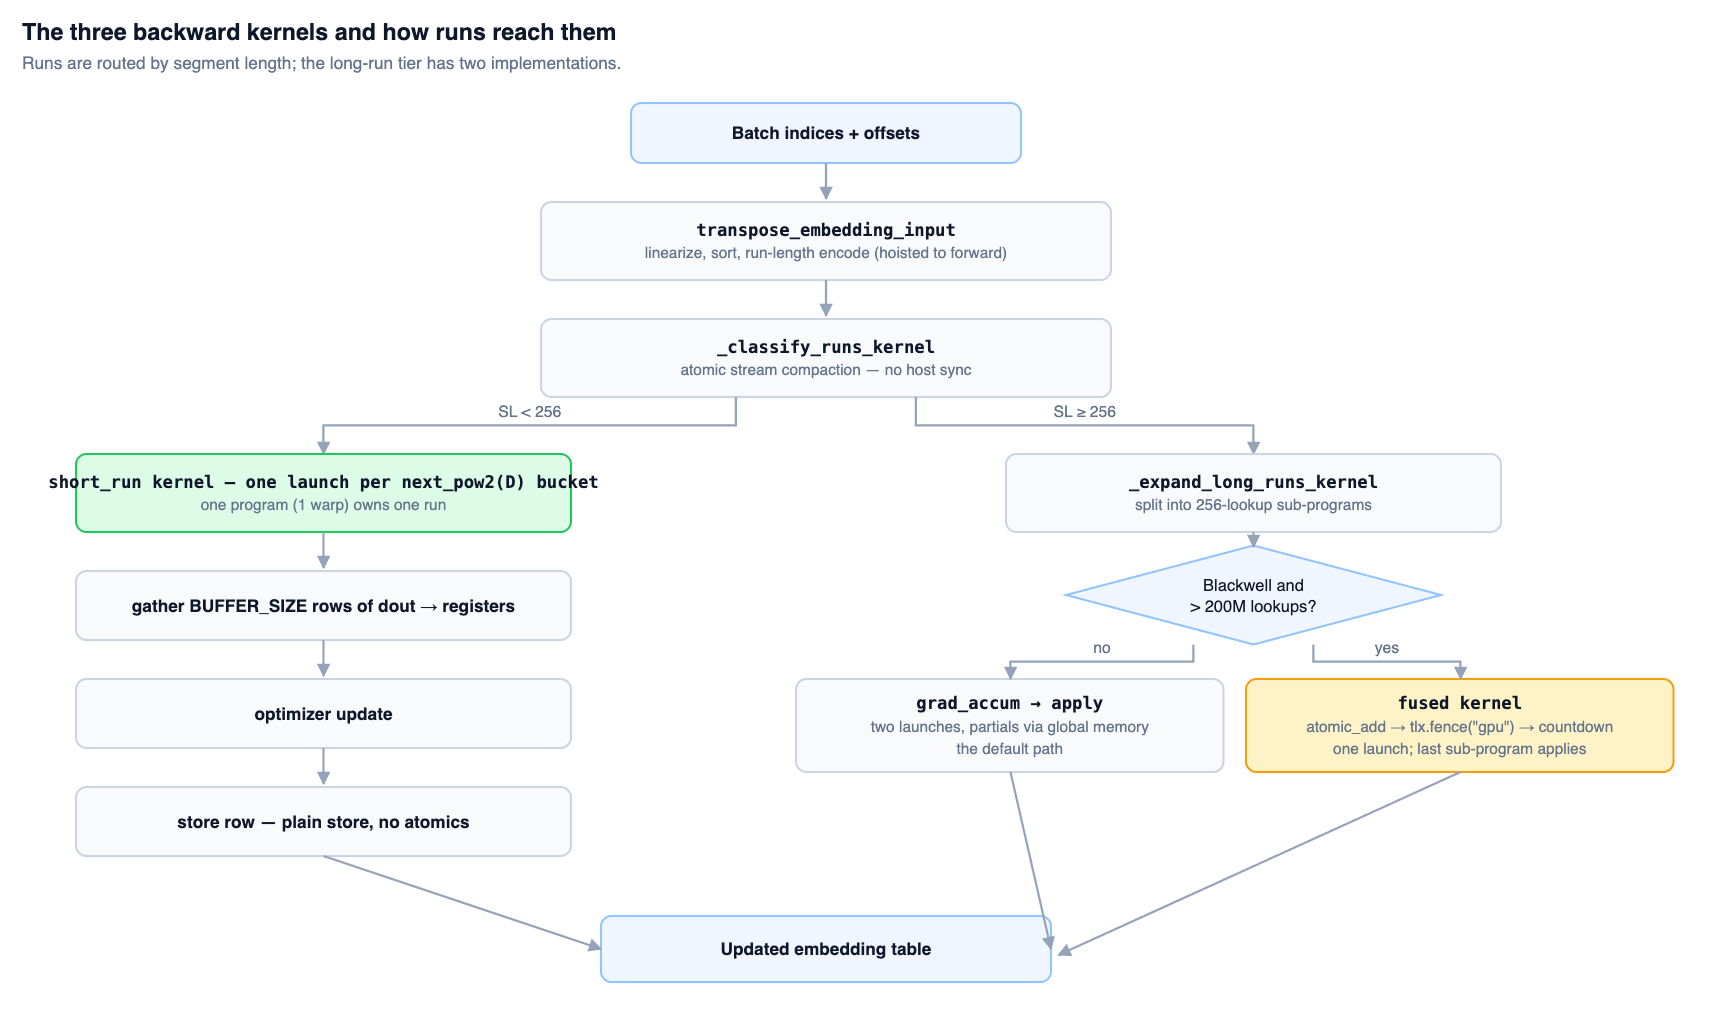
读图:分类后短 run 走左侧独占更新;长 run 走右侧分块,默认分两次启动,在图示 Blackwell 且超过 2 亿次查找的条件下可走融合路径。图中的预处理前移是可选优化。
融合路径的正确性依赖顺序:每块先写部分梯度,执行设备级 fence,再减少剩余计数,最后完成的块才能更新权重。若计数先到零、数据尚未可见,程序可能不崩溃却得到错误数值。原文还讨论 CLC 工作获取与 TMA 归约,但这些是硬件特定能力,不能把 Blackwell 路径等同于其他设备的实现。
少读一些、少同步一些,往往比多并行更有效
一次缓冲更多行会增加存活指针和寄存器,反而压低占用率。作者在 B200 的无权重短 run 上,将 gather 宽度从 8 调成 2,寄存器从 184 降至 64,占用率从 12.5% 升至 49.9%。按 next_pow2(D) 分桶则减少窄表被最大维度拖累的无效通道,两者解决不同浪费。
分类得到多少长 run 是运行时数据。把计数取回 CPU 会造成同步,因此实现预分配工作区,在 GPU 内压缩任务列表并由后续内核读取计数。这也说明动态形状优化需要把元数据路径一起设计,不能只看数值计算核。
预处理还可提前到前向。B200 的一个大配置中,前向从 22.844 ms 增至 33.252 ms,反向从 56.693 ms 降至 32.931 ms,合计从 79.537 ms 降至 66.183 ms,减少 16.8%。它牺牲前向换取总和改善;这个核心模块选项默认关闭,当前 TorchRec wrapper 未暴露。保存直方图供反向复用也不意味着前后向已经合成一次启动。
融合的边界也是工程接口
这里的“更新一次”尤其重要:带逐样本权重时,应先缩放每份梯度,再按行聚合;把优化器当作反向尾部处理,减少的是额外读写,并不允许改变更新语义。小表直方图复用还有补偿式 FP16 高低部分计算,再汇入 FP32 的路径,不能把它简化成降低累加精度来换速度。
原文把更大范围的稀疏核融合列为后续空间。判断是否值得采用时,应把输入检查、转置排序、工作区和优化器一起纳入测量:只展示反向主体可能隐藏前向新增成本,单个形状的高倍率也可能掩盖低于基线的长尾。以上是从实现机制推出的评估建议,不是本篇另做的基准结果。
结果要按硬件、路径和指标阅读
官方结果覆盖 GB200 上 307 个 shard 配置、283 种不同形状,采用 FP16 权重和 exact row-wise Adagrad。反向图报告的是达到的带宽之比,而非完整训练吞吐:
| 反向配置 | shard 数 | Triton/CUDA 带宽中位比 | 不低于 CUDA 的比例 |
|---|---|---|---|
| 无逐样本权重 | 256 | 1.13 | 94% |
| 有逐样本权重 | 51 | 1.22 | 69% |
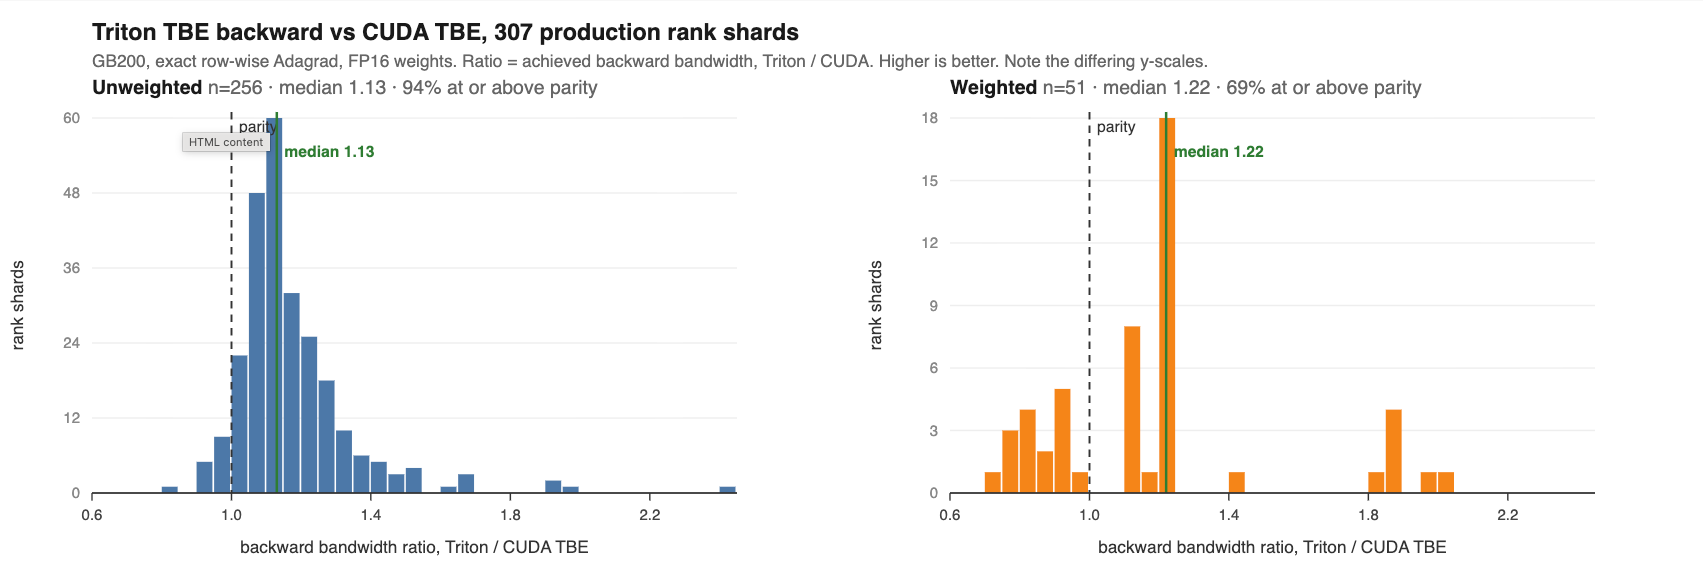
读图:虚线 1 表示持平;右图中位数更高,但更多配置落在 1 左侧。两图纵轴刻度不同,中位收益与稳定覆盖率需要同时看。
前向配图单独标为 B200:Model 1、Model 2 各 31 次测量,中位延迟加速比分别为 1.28 和 1.18。正文另有前向中位 1.28× 的概述,不能据此把两组图或全部 307 个配置混为同一个统计总体。主要反向收益来自 CUDA 在 SL=32 即转入协作路径,而 Triton 延迟到 256;较短 run 不必负担不划算的同步。
边界也明确:全部工作都在 SL<4 的 11/307 个 shard 上仍低于 CUDA,单个耗时约低于 1 ms;SL>256 的形状约为持平。这是一篇值得读的算子工程实践。 迁移时应先看实际 run 长度、维度和权重分布,再核对优化器语义、后端支持与完整前后向延迟。更易修改的实现扩大了调优空间,但“更易维护”和“所有负载都更快”仍是两个不同结论。