同一前缀可能留在某张 GPU,也可能已经下沉到主机内存、磁盘或共享池。把这些状态都叫“命中”,无法判断哪个副本能更快服务请求。sference 的文章解释了一个生产调度问题:如何让异构引擎的缓存状态成为可以比较的路由输入。
原文:Tracking the KV Cache Across a Heterogeneous GPU Fleet · Peter Us / sference · 2026-10-27。
索引从引擎事实出发
每个引擎旁的 relay 订阅 KV 块存储、移除和清空事件,归一化后传给调度层。全舰队按模型维护前缀块树,节点记录副本、存储层,以及 data-parallel attention 的 rank。请求沿树匹配,调度器据此估计各副本已有多少前缀,以及复用需要付出什么搬运成本。
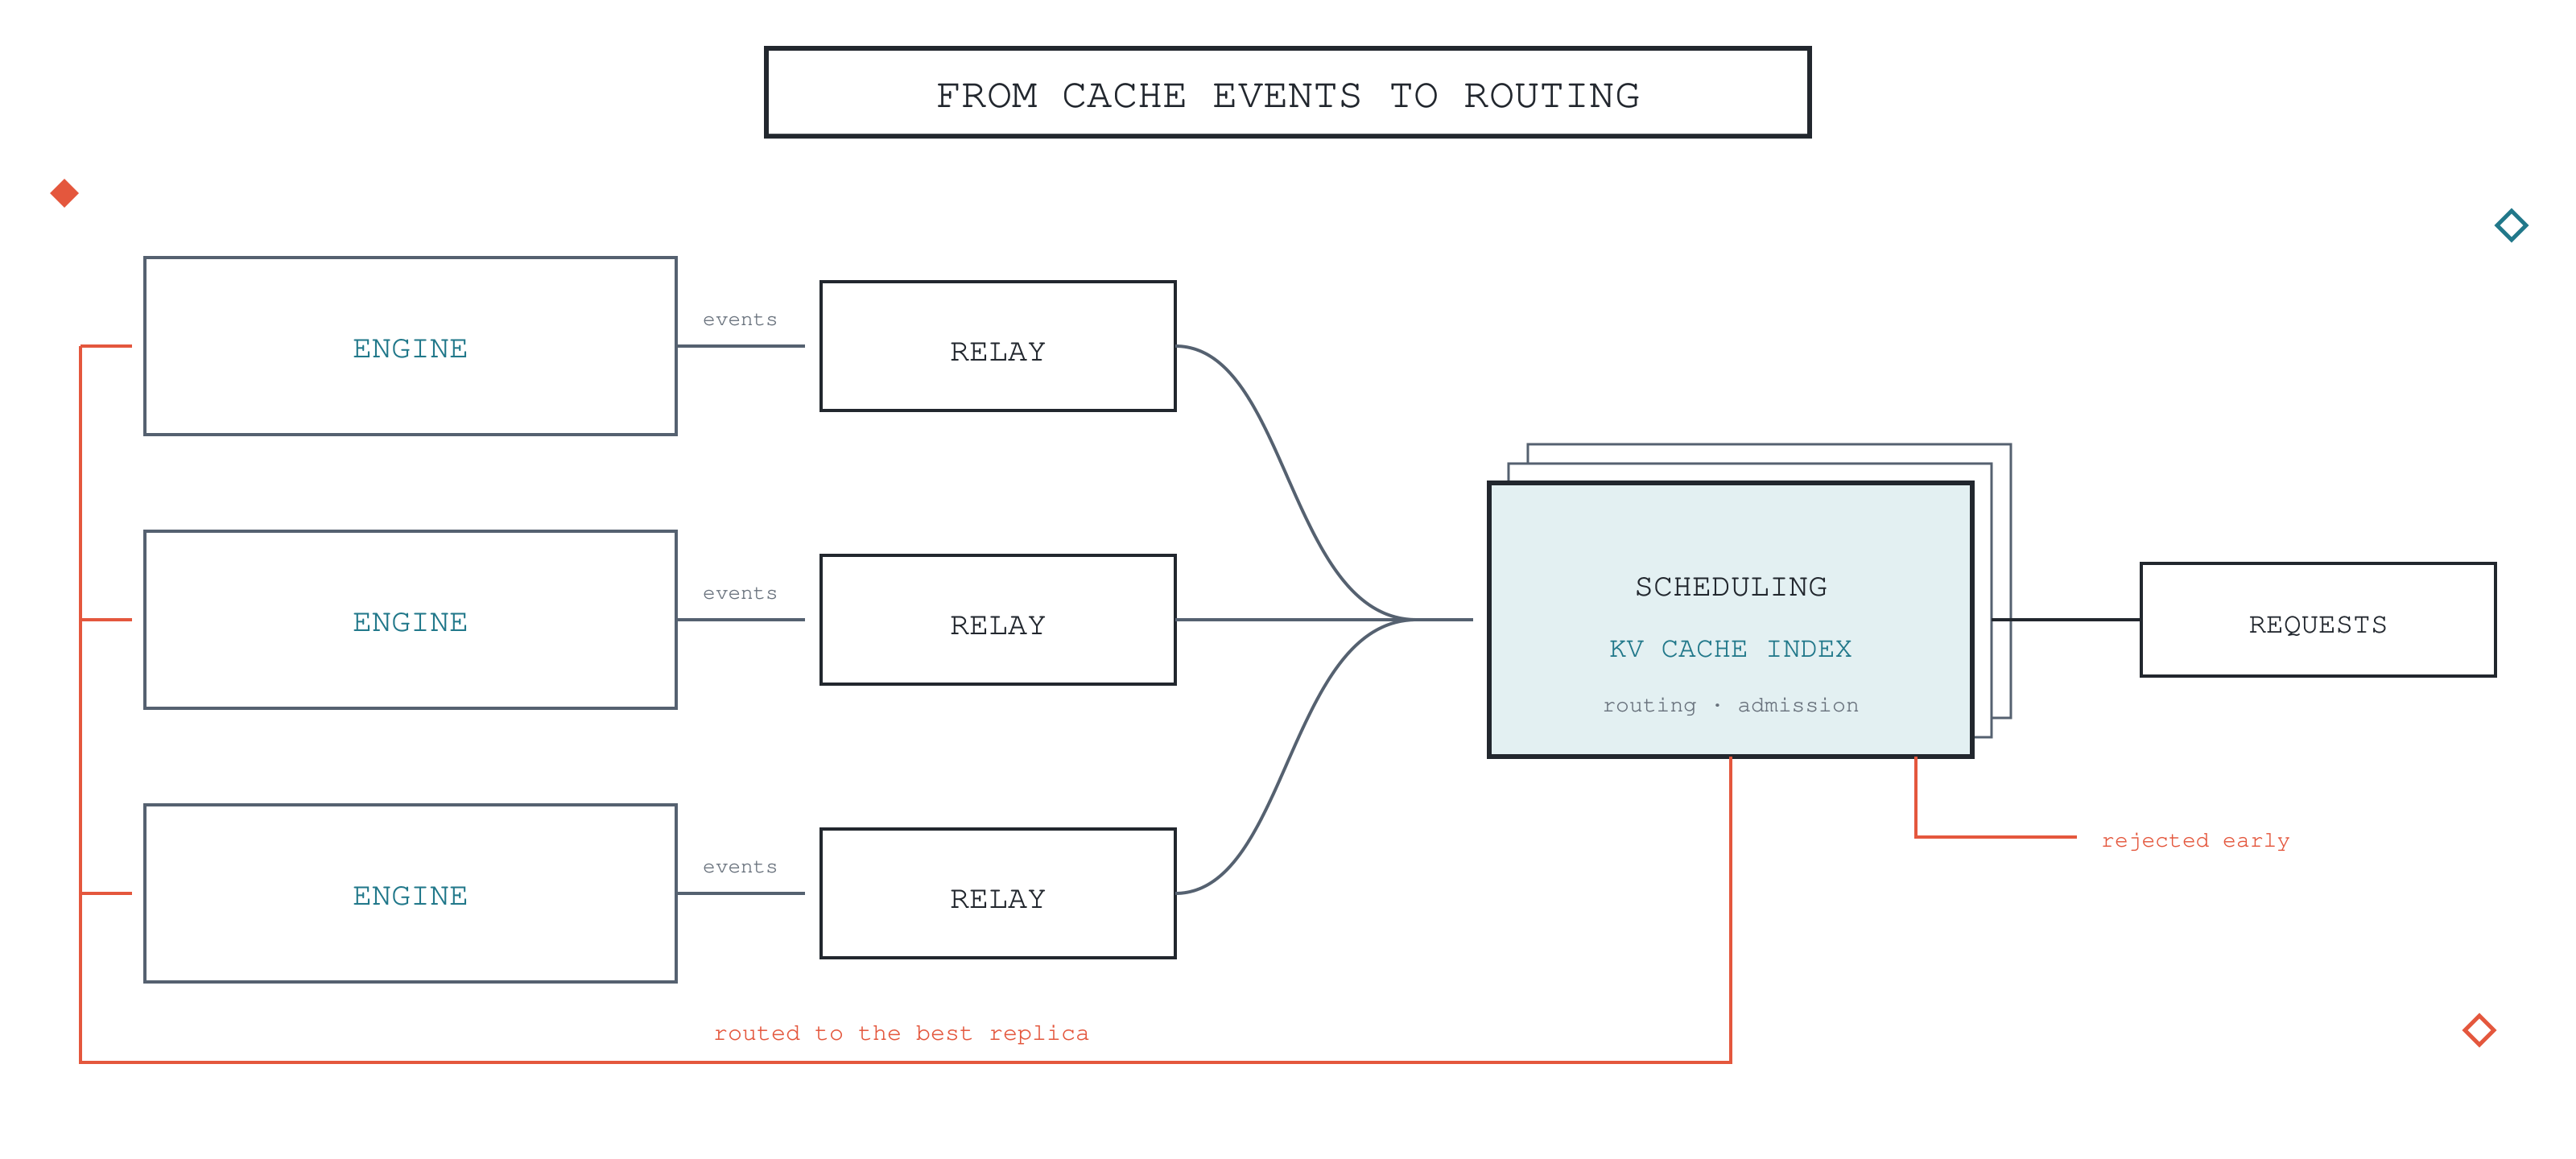
从左到右,缓存事件建立全局视图;调度层再将请求送往合适副本,或在无法满足约束时提前拒绝。
跨引擎的难点不是字段名不同,而是语义不同:移除一个块是否意味着后续前缀都失效?同样的前缀使用什么哈希?EAGLE 类推测解码的事件为何按 token 对编码?relay 和索引需要按引擎规则解释这些差异,并在升级时重新核对事件流。文章没有把当前事件协议描述成稳定标准。
陈旧状态是设计的一部分
缓存移动表现为某一层删除、另一层写入。relay 跟踪一个块在全部层的位置,最后一个副本消失时才撤销它,避免把下沉误认为完全丢失。事件中断或索引重建时,relay 从自己的镜像回放快照,先浅层公共前缀,再补深层,并错开发送以免瞬间冲击调度器。
这些机制仍不能消除竞态:路由完成后、引擎开始执行前,缓存可能被逐出。系统也会对刚送往副本的请求乐观计入缓存,以缩短事件滞后造成的冷视图。对无法判断是否仍可复用的状态则保守撤销。两种处理对应不同不确定性,不能概括为索引永远保守或永远精确。
混合模型进一步要求 KV 与相应状态空间/线性注意力检查点同时存在。若只保留 KV,却丢了对应状态,复用位置必须退回;部分引擎没有为这种单独逐出发送事件,索引所记长度就只是上界。
如何判断索引是否可信
调度时记录预计可复用 token,完成后对照引擎实际复用。作者报告某个典型日中,实际缓存复用覆盖全部提示 token 的 93.1%;索引提前识别了实际复用 token 的 99.6%,另记有 0.3% 的错误计入。这几个指标分母不同,不能互相替换成一个“99.6% 命中率”。文章没有给出独立对照路由实验,因而也不能由索引一致性推出确定的延迟或成本改善。
这份实践的价值是让缓存观测服务于决策,同时保留不确定性。预加载、主动复制、全局逐出策略是文末后续方向;已经实现的是缓存位置索引,不应把计划中的优化也算作已验证收益。