Dhvani Chheda、Kai Wombacher · NVIDIA · 2026-09-23 · 原文
NVIDIA Cluster Readiness Engine(NVCRE)关注一个常被忽略的间隙:单机健康状态正常,不代表一组GPU能稳定执行分布式任务。它在Kubernetes上组织真实负载,结合拓扑分组和分层故障隔离,把“集群可用”转化为有测试范围、有测量结果的判断。
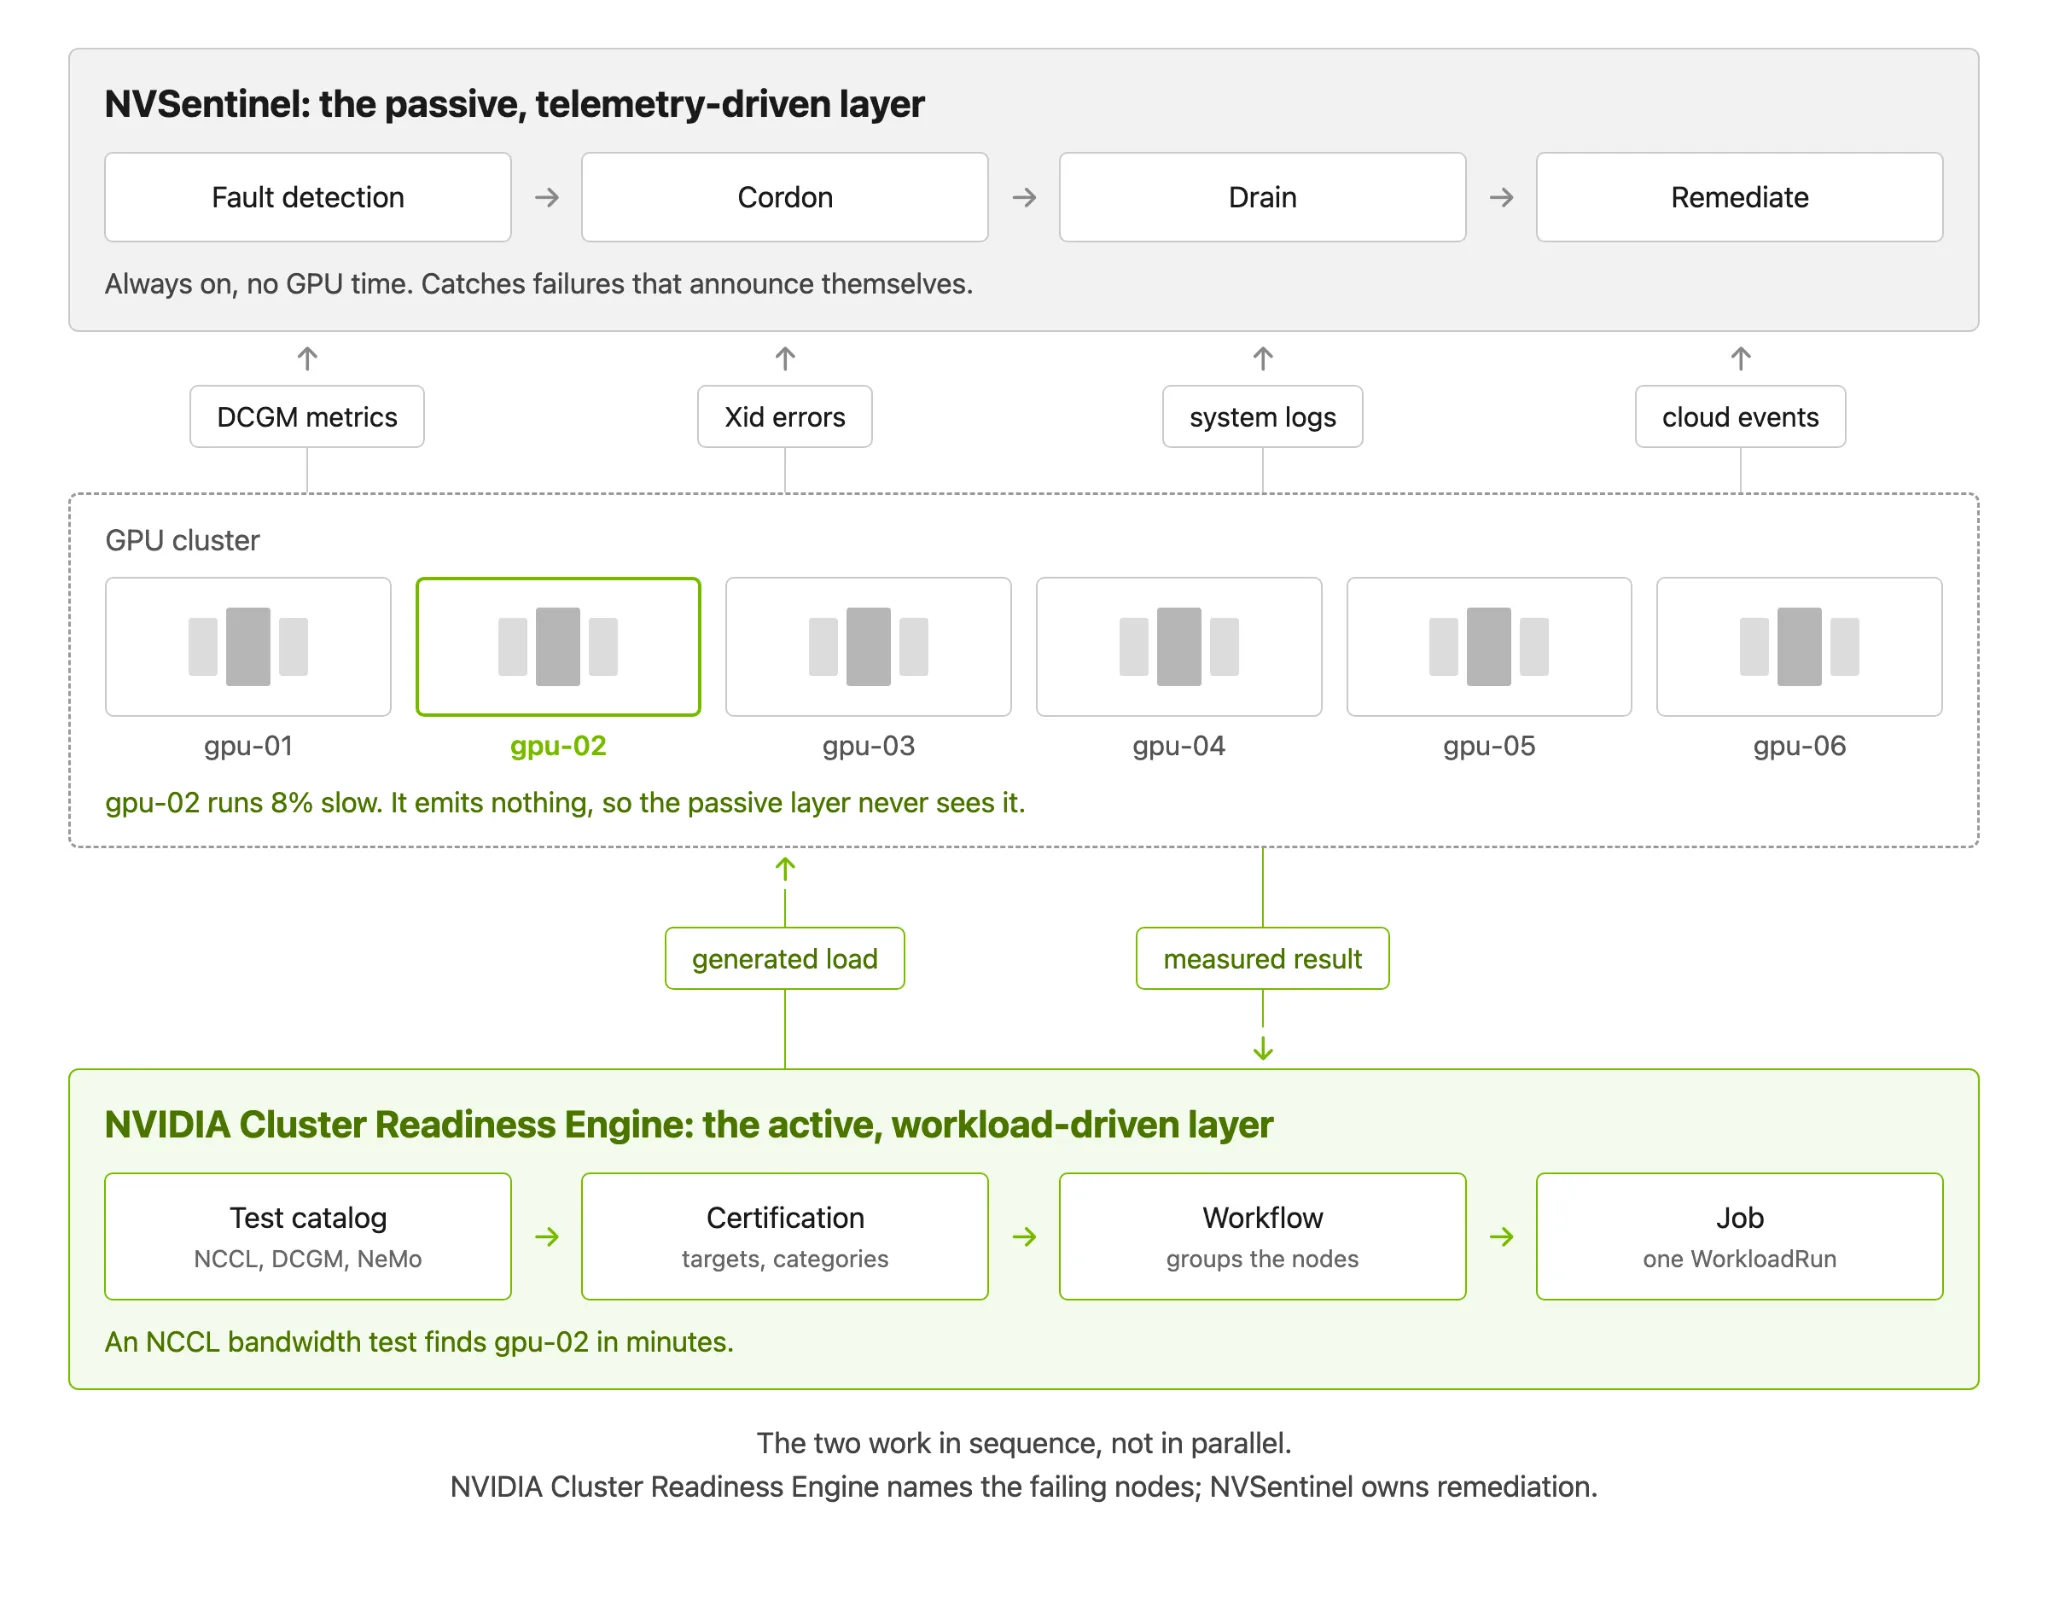
原文展示主动负载验证与被动遥测的分工;图中慢节点用于说明机制。
API把测试执行和结果归因连接起来
官方文档将流程分为 Certification、Workflow 和 Job:分别描述认证目标、组织测试类别、执行负载并记录结果。WorkloadRun 则提供较轻量的临时工作负载入口。输出可区分硬件健康异常、阈值不满足和工作负载失败等原因,供后续运维流程使用。
这种组织方式的价值在于可追溯性。一个“失败”需要能追到测试类别、节点集合、硬件与软件配置,以及测量条件;否则,下一轮复测很难区分修复有效、环境变化或测试本身变化。
测试范围决定结论能覆盖多远
单节点测试、机架内测试和跨机架测试暴露的是不同路径。工程上可以为每项结果附上一个范围描述:哪些节点、哪些互联、什么消息大小、什么并发,以及持续了多久。通过一项测试,只说明这个范围内满足所设条件,不能自然扩大成所有训练任务的保证。
同步训练还会把局部性能下降放大为整体等待。因此,应同时查看任务总吞吐和各参与者的差异,而不是仅检查是否有进程退出。一个没有报错但持续落后的参与者,同样可能降低有效产出。
这也说明阈值应带版本:硬件代际、通信库、拓扑和测试规模变化后,旧阈值不一定仍适用。过宽会漏掉退化,过严则可能把正常差异变成反复误报。
分组隔离需要警惕交互型故障
原文的诊断模式会拆分失败组并重测,逐步缩小疑似范围。一个值得进一步验证的边界是:故障是否在拆分后仍然存在。如果问题只出现在跨交换机链路、特定节点对或高并发下,把组切小可能让症状消失。
因此,可以把“两个子组都通过、原组失败”保存为有价值的结果,而不是宣布问题已经解决。它提示调查组间连接、共享资源或规模效应。复测计划应保留原来的失败组合,并尝试交换分组方式,检查结论是否对划分策略敏感。
测试本身也会消耗GPU与网络。限制同时运行的测试数量,是为了让隔离结果反映原有问题,而不是测试流量制造的新拥塞。
从认证结果走向安全的运维闭环
主动验证与持续遥测互补。前者能施加负载以暴露潜在问题,后者适合在生产任务运行时跟踪异常。认证结果可以成为调度准入或维修复测的证据,但不能直接等同于永久健康标记。
一个可实施的扩展是为认证建立失效条件:驱动升级、网卡固件变化、拓扑调整或维修后,要求相关测试重新执行。自动隔离节点前,还应检查诊断置信度、任务影响和可回退性。
对混沌工程而言,这提供了一个明确实验目标:注入已知的局部慢速、链路异常或配置偏差,评估检测覆盖、疑似集合大小和隔离开销。重点不是多跑多少测试,而是能否用有限成本得到足够准确、可行动的结论。