原文:Building a High-Performance and Portable vLLM Linear Backend with Helion
Sean Chen (Red Hat), Shangdi Yu (PyTorch, Meta Platforms) · 首发 2026-10-02
一个实现,为什么仍需要多种执行方式
LLM 的线性层大量执行矩阵乘法,通用高性能库已做了多年优化。但推理过程中的输入形状会变:prefill 处理较多 token,decode 的小批量矩阵可能难以占满 GPU。同一个数学运算,最合适的分块、并行度和执行变体并不固定。这篇文章的价值,是把这种形状相关的选择变成可搜索参数,再嵌入 vLLM 的真实服务路径。
Helion 提供接近 PyTorch 的分块编程接口。开发者维护一份计算逻辑,自动调优器搜索配置,不必为每个形状手工写一套内核及分发规则。本次实现使用 Helion 的 Triton 后端,实测集中于 NVIDIA Hopper 和稠密模型;“可移植”的设计意图并不等于其他硬件已获得同等端到端收益。
把算法选择也放进搜索空间
标准 GEMM 沿输出矩阵划分工作。当 M 或 N 太小,可用并行块不足,Split-K 就把归约维度拆给更多线程块,再合并部分结果。这样增加并行度,却也增加清零与聚合成本。另一种 Swap-AB 利用转置恒等关系改变操作数方向,让小 M 形状获得更合适的分块。它们都可能获益,也都不是所有形状下的赢家。
原文用一份示意实现表达标准、Split-K 与 Swap-AB:split_k 搜索 1 到 256 的二次幂,swap_ab 为布尔参数,再与底层配置联合测量。示例在拆分 K 时清零输出并用原子加合并,量化版本还要加入缩放逻辑。优化的核心是寻找特定形状的执行方案,不能把同一公式误解为完全相同的数值累加路径。
本次覆盖三种格式:FP8_Dynamic 使用逐 token 激活和逐通道权重缩放;W8A8_INT8 采用相同粒度的 INT8 缩放;Block_FP8 使用 1×128 激活缩放和 128×128 权重缩放。格式及缩放粒度属于比较条件,不能把某种格式的收益泛化到所有量化推理。
混合分发解决运行时开销
更快的 GPU 内核仍可能被 CPU 分发、启动开销抵消。作者因此只在 CUDA Graph 回放覆盖的小形状范围使用 Helion,超过阈值回到默认后端。这也缩小了调优形状集合,让配置维护更可控。
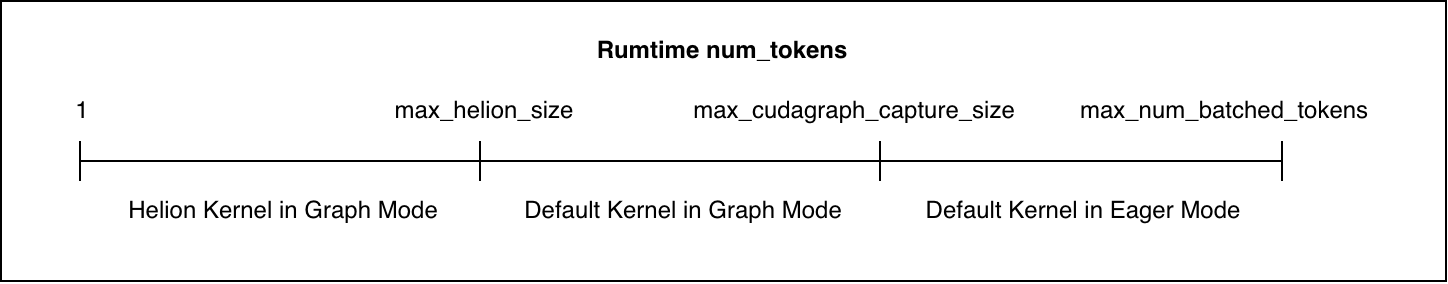
读图:从左到右,先用图回放中的 Helion 内核,再用图回放中的默认内核,最后是超出捕获范围的默认 eager 路径;阈值不是硬件通用常数。
本次 max_helion_size=32,逐一调优的 token 数为 1、2、4、8、16、24、32,并按模型对应的 GEMM 形状生成配置。调优测量也开启 CUDA Graph,使搜索时看到的执行条件接近部署。大形状回退并不说明它们不能优化,而是当前方案把预算集中于更可能受益的 decode 区间。
自动搜索采用 LLMSeededLFBOTreeSearch:LLM 提供候选种子,后续搜索仍通过基准测量选择配置。原文报告种子模型为 Claude Opus 4.8。模型给出建议不等于性能已经成立;这里真正决定选择的是目标形状下的测量,也没有提供跨种子模型的普遍优势结论。
从微基准到服务收益,需要保留哪些条件
全部性能实验使用一张 H100 80GB HBM3。模型包括 Qwen3 的 1.7B、4B、8B、14B、32B,以及 Qwen3.8-27B。作者报告的内核几何平均加速分别是:FP8_Dynamic 相对 CUTLASS 为 1.110×,W8A8_INT8 相对 CUTLASS 为 1.178×,Block_FP8 相对 FlashInfer 和 DeepGEMM 为 1.149×、1.177×。这些是多个输入形状的统计,单个形状表现仍有差异。
端到端实验用 ShareGPT,张量并行度为 1,最大序列数为 32,关闭前缀缓存,并比较默认与 Helion 线性后端。作者报告部分工作负载吞吐提升超过 10%。它既不是所有模型都至少快 10%,也不是前述内核倍率直接变成整机倍率;注意力、调度和其他算子的时间仍存在。
关闭前缀缓存有助于隔离这次后端比较,但多轮 Agent 的真实服务往往依赖复用。因此,本文的工程判断是:把该结果作为小并发、相应量化格式下的候选优化,再在自己的上下文分布、缓存设置和并发下比较。不能直接外推到高并发、MoE 或另一张 GPU。
调优成本由谁承担
细粒度搜索可能耗费数小时。vLLM 启动时的 CUDA Graph 捕获还会触发 JIT 编译,增加冷启动延迟;缓存编译产物能缓解后续热启动,但不会抹掉首次准备成本。预置大量模型配置方便使用,却让上游维护和验证变重。
截至该文发布,实现和预调配置在作者的 vLLM fork 中,上游接入仍通过 RFC讨论。作者提出让上游维护内核与基本功能配置,把特定工作负载的调优交给部署方。这里的取舍是用离线投入换运行收益;是否划算,取决于部署持续时间、模型变化频率和配置能否复用。
把服务分布带回调优决策
实际采用时,首先要确认哪些调用会进入被优化的区间。最大序列数限制的是同时参与服务的序列规模,运行时 token 数还与当前调度阶段有关。文章按图捕获支持的形状调优,并用小并发实验观察收益,因此不能只看到部署参数里同样写着三十二,就断定线上所有矩阵乘法都会走相同路径。这里需要核对的是实际形状分布与分发覆盖率。
其次,应把准备阶段与稳定运行阶段分开记账。模型固定、服务持续时间长时,离线搜索和首次编译可能被许多次请求摊薄;模型频繁更换或实例经常重建时,准备成本更突出。编译缓存解决的是已有产物能否复用,而自动调优解决的是配置是否适合目标形状,两者不能互相替代。这是根据文中成本项作出的工程推导,并非作者给出的盈亏平衡测量。
最后,要保留默认后端作为比较对象,观察整条服务路径。若调优后只有内核计时改善,用户可见延迟与吞吐没有变化,下一步应检查优化区间实际占比和其他阶段耗时,而不是继续扩大搜索空间。配置也应与硬件、模型、量化方式及软件版本一起记录;其中任一条件变化,过去的最优选择都需要重新验证。原文没有提供通用的收益保证,也没有量化所有部署场景的维护成本。
阅读建议:先看混合分发和实验设置,再看代码。 这篇工业工程报告说明高级 DSL 可以把多种算法变体纳入同一搜索框架,也说明搜索、冷启动和配置维护仍是系统成本。Blackwell、AMD、TPU 与 MoE 扩展在文中属于后续方向,不能当作本次 Hopper 实测的延伸结论。