Benjamin Chislett (NVIDIA) · vLLM 官方工程报告
原文:Hyper Optimizing Kimi K3 in vLLM: Moving Fast and Responsibly
更值得看的是专用路径怎样被约束
这篇文章把两件事放在一起:为 Kimi K3 写更快的解码内核,以及让这类高度特化的改动仍然可检查、可维护。最高速度很醒目,但主要进展是按硬件、模型和请求形状共同设计执行路径,再要求贡献者交出能实际覆盖该路径的正确性与性能证据。
通用推理框架要服务许多模型和配置,很难让每一个小矩阵、归约和内存交接都恰好适合一个目标负载。这里的专用路径使用 CuTe DSL,覆盖注意力、MoE 与通信,面向同一支持 multicast 的 NVLink 域内 8 或 16 张 Blackwell GPU,解码批量为 1–64,并支持特定长上下文 DCP 配置。它是一组有边界的优化,不是换一个内核就能让所有服务提速。
从算子之间找时间
小批量解码中,矩阵形状和启动开销经常比峰值算力更关键。作者对批量 1–2 使用小矩阵投影内核,较大批量用 split-K 增加并行工作;KDA 也按批量与每卡注意力头数调度。长上下文时,DCP 把 KV 分到多卡,各卡处理局部历史,再融合部分结果、value 投影和门控。
更大的收益来自交接。注意力输出投影、all-reduce 与后续残差计算被串接融合,部分结果进入 NVLink 可访问缓冲区后,接收方直接继续计算。某些小批量配置融合生产者与消费者,较大批量改用两阶段归约,减少卡间搬运。优化对象因此不只是单算子耗时,还包括什么时候能开始下一步。
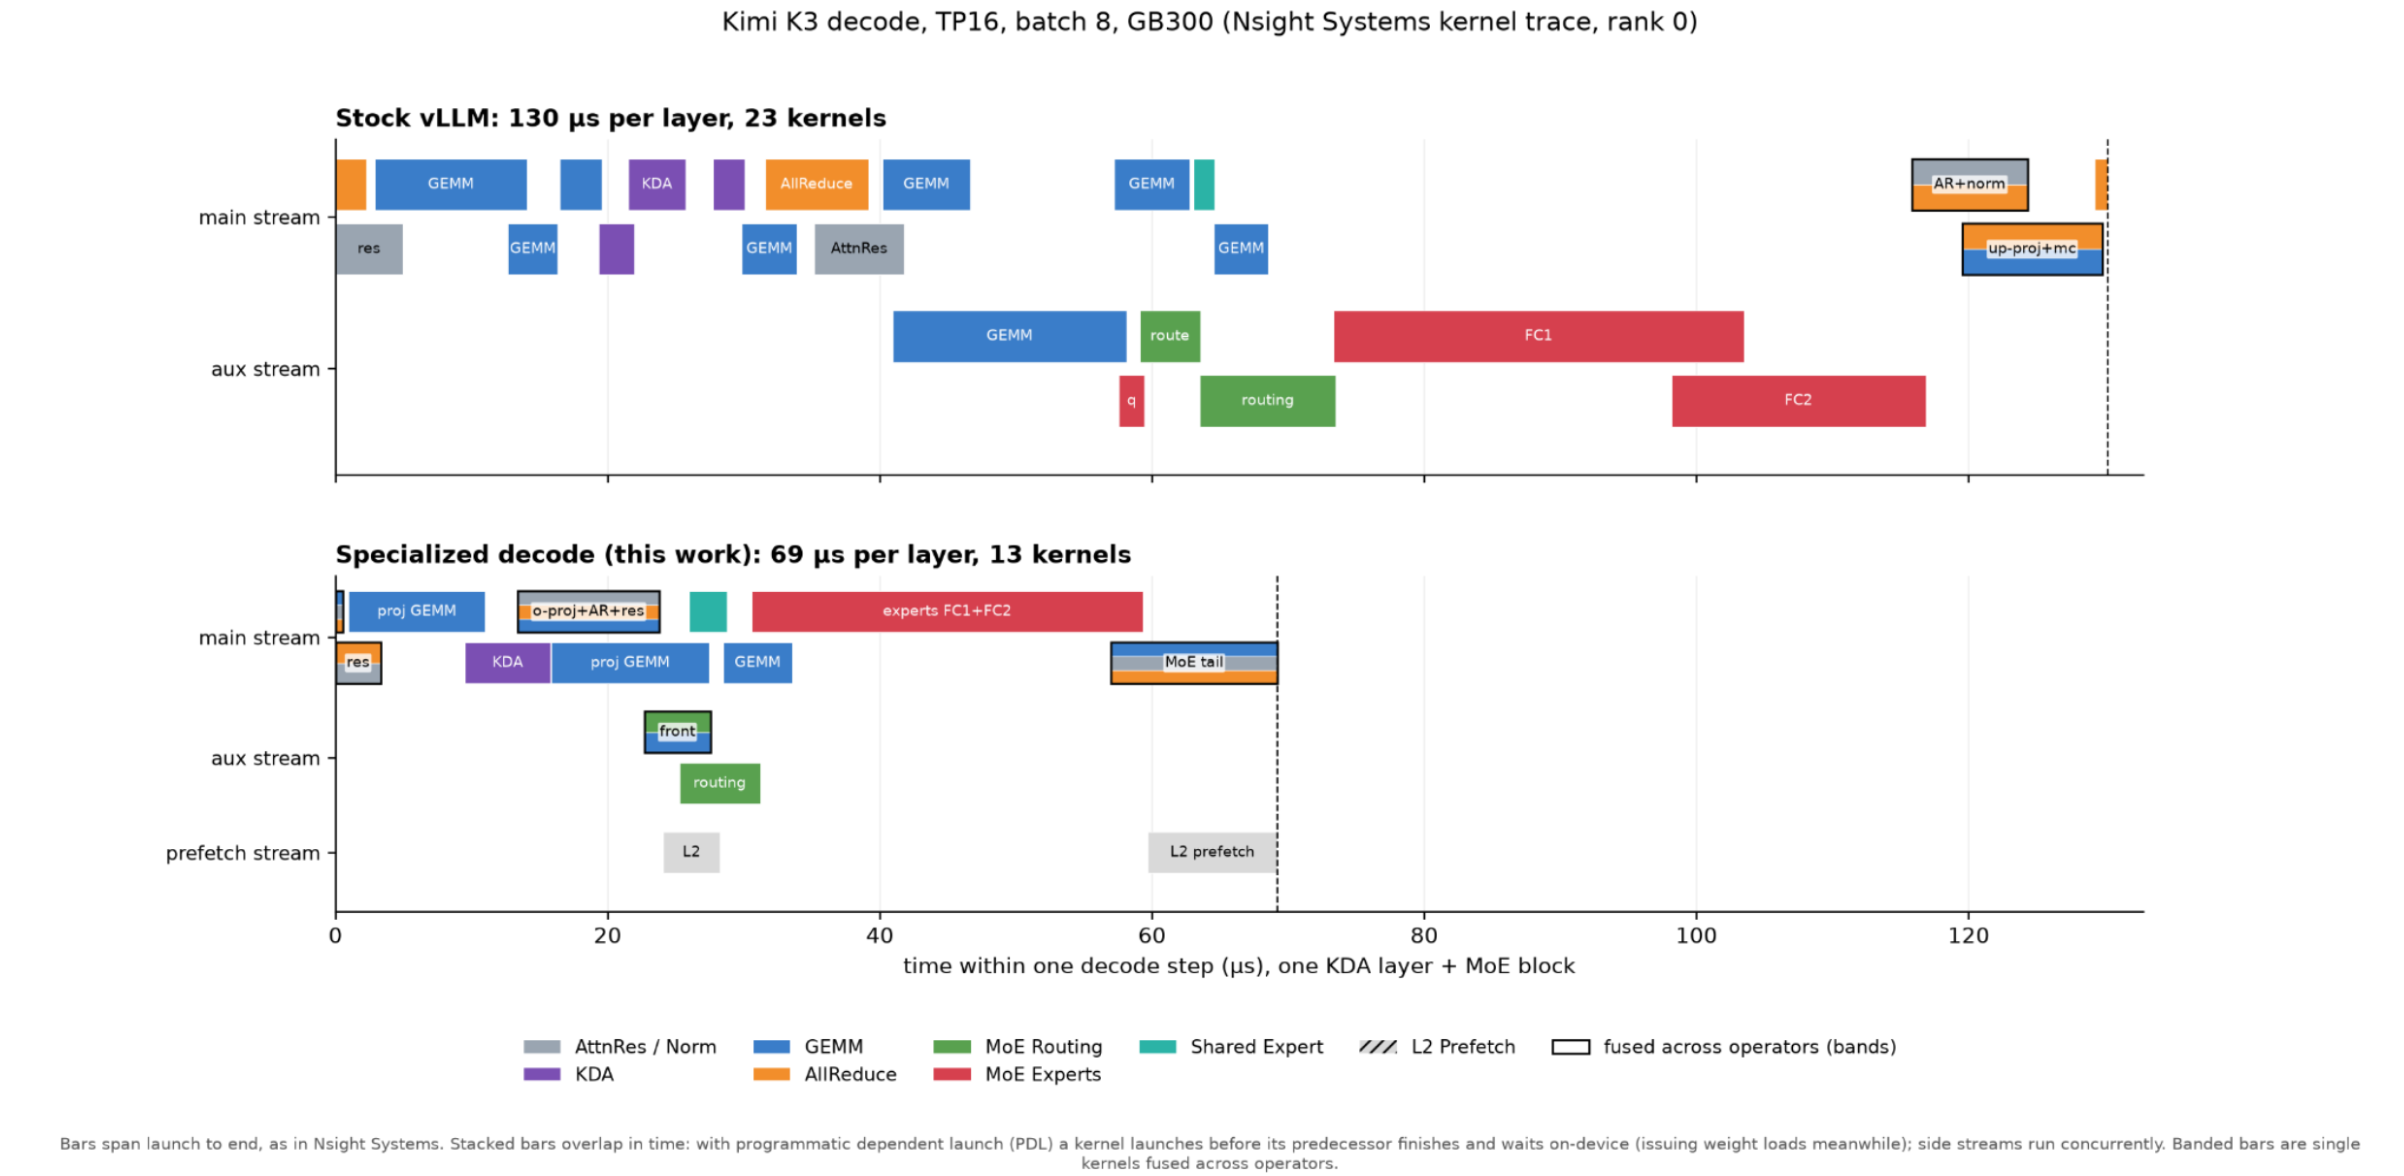
读图:TP16、批量 8 的单层轨迹中,上方标准路径为 23 个内核、130 微秒;下方专用路径为 13 个内核、69 微秒。主流、辅助流和预取流的交叠共同缩短执行,不能把单层比例直接当端到端倍率。
MoE 前处理也存在跨卡重复劳动。基线在每张卡算完整 router 分数和 latent 输入投影,专用路径把这些工作按 TP rank 分开,将各自份额合成一次矩阵乘,再经 NVLink 交换。共享专家在独立流运行,与路由或被选专家计算交叠;资源配额需要调到不互相争抢,否则并发只是把瓶颈换个位置。
另一个技巧是趁通信阶段预取下一步权重到缓存。小批量通常受读权重带宽约束,而通信阶段未必用满内存带宽,辅助流可以提前搬入即将使用的权重。这解释了为什么读时间线时要看空隙与依赖,而不只是数融合后的内核。
三组性能证据要分开读
作者最醒目的 842 token/s 来自 16 张 GB300、TP16、批量 1、DSpark 七个 draft token,合成接受长度 AL=6,输入长度 1、输出约 1K。相同推测设置下标准 vLLM 为 488 token/s,即 1.73×。这里统计纯 decode,排除 prefill;固定接受长度也不能预测真实提示下的接受率。
无推测解码实验更能看出基础路径的收益。作者报告 TP16 在批量 1 为 256.4 token/s、1.88×,批量 64 为 3,606.1 token/s、1.62×;TP8 同两点为 193.3、2,375.9 token/s,对应 1.58×、1.31×。这些吞吐是整个 TP 组的总量,大批量结果不能写成每用户速度。
AgentX 进一步保留编码 Agent 会话的长度、轮次、工具停顿和复用模式,用合成文本替代私有内容。并发 1 时,作者报告 P90 interactivity 从 223.7 到 403.2 token/s/user,约 1.8×;但这比较早先 8 卡结果与优化后 16 卡结果,不能全部归因于软件。纯解码、真实形状重放和跨硬件数量比较回答的是不同问题。
收益随批量变化本身也提供线索:小批量时减少启动、重复权重读取和同步等待的相对价值更高;批量增加后,更多实际矩阵计算进入总时间,固定开销节省的比例可能缩小。这是对报告曲线的工程解释,不能仅凭倍率反推某一个内核贡献。图中包含一个 KDA 层与 MoE 块的 rank 0 轨迹,不能代表所有层、所有 rank 或所有请求的尾延迟。
对于推测解码,还应把 draft 长度与接受长度分开。前者是主动提出多少候选,后者决定最终留下多少工作;加深 draft 会增加生成和验证成本。固定 AL 的比较有助于隔离目标路径速度,但生产端仍需要在真实接受行为下测量每个完成请求的成本。原文最高速度的适用条件应与数字一起传播。
更快的代码需要更有针对性的验证
文章中的一个具体错误很有启发:编译器把 activation 读取移到同步等待之前,修复方式是把相应加载类型限制为静态权重。普通功能测试未必覆盖这种时序问题;如果测试悄悄走回标准路径,更无法证明优化正确。MRCR 长上下文与 AIME25 长生成还暴露出模拟输入的独立内核测试没有发现的数值问题。
因此,验证至少包含两个层次:算子层面比较形状、输入和数值,模型层面检查完整路径的回答。性能扫描也要覆盖批量、上下文与并行设置,MoE 应包含真实提示,因为专家选择会改变权重访问和复用。全文上下文服务、温度采样与结构化输出仍是服务能力,不能为跑分省略。
作者提出的 fast-track 工作流把特化改动留在模型代码内部,同时要求运行时能说明何时选中、改了哪些状态、何时回到标准路径。采样、输入准备和 KV 管理等共享部件受影响更广,仍需要核心维护者更深介入。这种隔离会放弃部分优化空间,却让评审范围更明确。Bring-Your-Own-GPU 评测提案则希望贡献者提交标准环境中的结果包,分担验证算力;这些是提案方向,不等于所有评测设施已经完成。
如何判断它与你的系统是否相关
如果目标是同类 GB300 小批量低延迟服务,值得继续读内核时间线、支持范围与相关 PR;若负载主要受 prefill、排队或跨域通信限制,不能直接套用最高倍率。实用的评估顺序是先确认优化确实被选中,再比较输出与持久状态,最后用目标请求分布检查延迟和吞吐。
这篇报告没有给出所有硬件与任务的质量、成本保证,也不能据博客发布日期推断某个正式版本已默认开启。它最有价值的工程经验,是把每次加速关联到具体形状、执行依赖和验证范围,使优化收益与可维护性能够一起审查。