AMD and Embedded LLM · vLLM 官方工程报告
原文:Scaling Kimi K3 on AMD Instinct MI355X: Matching NVIDIA HGX B300 Throughput per GPU on AgentX
先定义“同样快”
主比较采用 10 月 9 日取得的 InferenceX 快照,AMD 与 NVIDIA 提交分别来自 9 月 30 日和 8 月 16 日;局部优化实验另有配置。
这篇文章的重点是把服务表现沿缓存、重复计算、内存搬运和并行粒度逐层解释。AgentX 复现编码 Agent 的请求长度、时间与共享前缀,用合成 token 代替私有内容;无限缓存下理论复用率超过 96%,推测解码采用固定合成接受曲线。因此,它反映的是特定会话结构下的完整服务栈,而非任意真实提示的通用硬件排名。
在 P90 interactivity 为 50 token/s/user 时,作者报告 MI355X 每卡总吞吐约 7,567 token/s,HGX B300 为 6,083,高 24.4%。这里 interactivity 是 P90 响应 token 间隔的倒数,不含 TTFT;“总 token”包含复用输入和生成输出,也不是纯输出吞吐。两边均为八卡、TP8、FP4 权重、FP8 KV,但 offload 实现、CPU 缓存预算、软件版本、并发及推测设置并不完全相同。
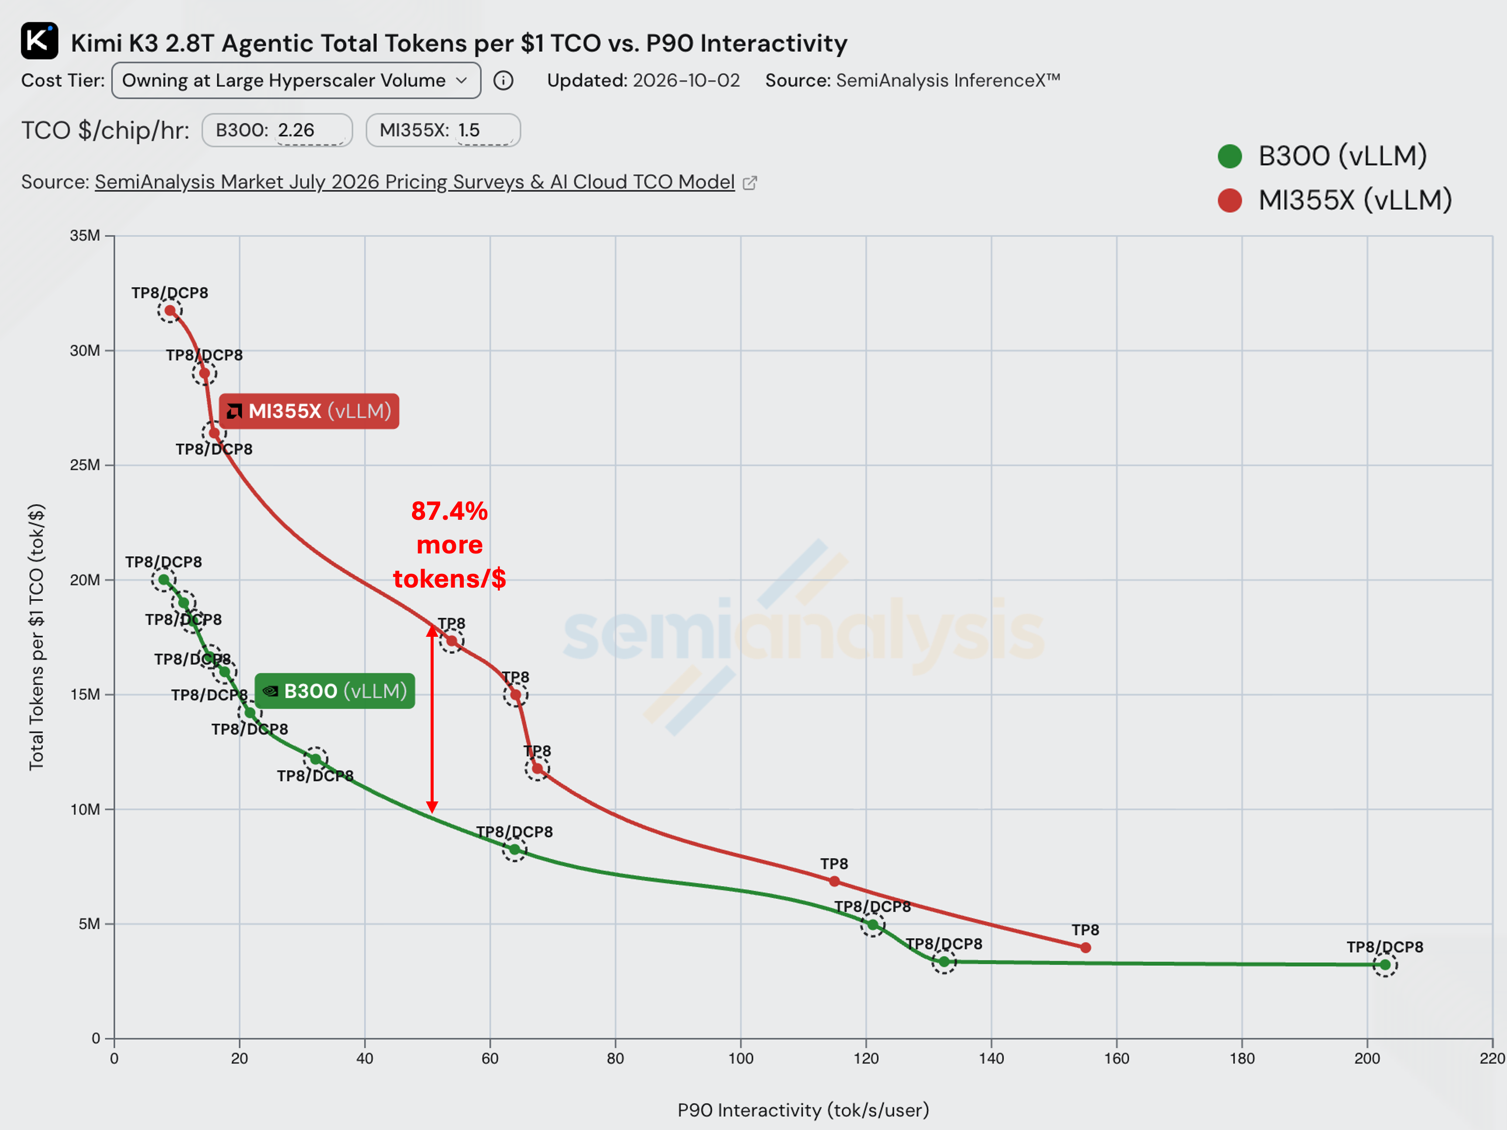
读图:横轴是交互速度,纵轴是每美元 TCO 的总 token;在相同横轴位置比较两条曲线。红色 87.4% 依赖图上每卡小时成本假设,不能当作实测能效。
缓存可复用,还要能一致地恢复
Kimi K3 的 24 层 MLA 保存随上下文增长的压缩 KV,69 层 KDA 保存固定维度递归状态。TP8 虽然分了查询头,MLA 历史仍可能在八卡重复;DCP8 再按位置分片,各卡交换查询、计算局部注意力,并按归一化信息合并结果。它主要减少重复存储,领先项注意力运算量大致不变。
文章用 142,000 token 估算:24 层乘以每位置 576 个 FP8 字节,约为每卡 1.96 GB;DCP8 后约 245 MB,均未计分配开销。节约的空间让更多历史留在 GPU,CPU offload 则保存装不下的 MLA 历史与 KDA 检查点。但两种状态必须找到共同恢复位置:示例中 MLA 到 3,072,兼容 KDA 仅到 2,048,就仍需重算后续 1,024 个前缀位置。保存注意力块尾部状态来对齐检查点,才让“命中”真正可用。
先删掉重复工作,再优化搬运
路由专家输出投影原来在八卡重复执行。优化把输出坐标分给不同 rank,各卡把负责部分加进共享专家的部分结果,复用已有 all-reduce 拼回完整向量。每个坐标只贡献一次,不额外增加 collective。作者在八张 MI355X、TP8、并发 8–128、随机 8K 输入/1K 输出、关闭前缀缓存的独立实验中报告输出吞吐提升 3.05%–4.91%。
后续只加载各 rank 需要的权重行,又在 TP8 的 92 个 MoE 层合计省约 3.85 GiB/卡。这项改动晚于头条快照,不能解释头条全部收益;其独立 AgentX 实验使用 TP8/DCP8、FP8 KV、30 分钟运行,无 CPU offload 和推测解码。在并发 32、48 时提升不足 1%,并发 70 时达到 28.9%,前缀命中率从 74.8% 到 80.1%。更像是高负载下额外缓存容量变得有价值,仍缺重复运行不确定性与等容量对照。
内核内部同样要追踪数据消费者。单 token KDA 将三个计算内核与两次输出复制收进一个 HIP 内核,历史卷积与递归状态仍需写回。另一处矩阵乘分派在选实现前先复制输入,回退分支却不使用副本;把复制移入实际需要的分支,消除了每步 69 次小复制。每次仅 1,792 字节却约耗 4.8 微秒,说明主要浪费是启动,不是字节数量。
并行度必须适配真正的形状
TP8 下每卡 12 个 MLA 查询头,补到 16 个可进入 AITER 汇编路径;多出的头输出丢弃,原头各自独立做注意力,KV 历史不扩张。八张 MI355X、TP8、并发 1、无 DCP、MXFP4 权重和 BF16 注意力下,32K 输入/1K 输出的平均 TPOT 从 43.8 降至 23.6 ms;1K/1K 则只有 22.9 到 22.8 ms。关键是长历史被分给更多工作组,短输入收益很小。
KDA 的递归依赖则通过分组变换处理:先求各 token 组的组合规则,扫描组摘要得到入口状态,再并行重放各组,组内顺序不变。代价是更多遍历,启动数从二增至四,只有原先并行工作不足时更划算。独立后端比较在八卡 TP8、并发 32、关闭前缀缓存、单 token 输出下,4K/16K 输入吞吐提升 5.3%–5.6%。
短推测验证还会遇到另一种不足:12 个头按 32 列分块只有 48 个工作组,改成四列后为 384 个。单张 MI355X、TP8 维度、单序列四个验证位置的图重放内核测试中,每层从 16.20 到 5.61 微秒,2.89× 包含窄分块及其他特化,并非整机加速。数值上,敏感矩阵逆使用 FP32 输入和累加;先把输入舍入到 BF16,再用 FP32 累加,无法找回丢失信息。
内存容量还有离散门槛。文章解释 KDA 前处理通过复用 Q/K 暂存空间、只保存三角矩阵实际占用块,使工作组请求约 79.5 KiB LDS,分配后为 80 KiB。MI355X 每计算单元有 160 KiB LDS,容量上可以同时容纳两组;稍微越过分配粒度,就可能只能留一组。但寄存器等资源仍会进一步限制驻留,所以“刚好装下两个”只是必要的容量检查,不能直接宣布吞吐翻倍。
主比较的软件与内存条件也应成为阅读结论的一部分:AMD 使用 vLLM 36768d1bf,NVIDIA 使用 5894fdf98,主机缓存配置分别为每卡 224.875 与 281 GB。固定合成接受曲线、一小时 profiling 与排除 warmup 有助于解释流程,但下载的数据集修订未记录,闭环重放完成的请求组合也可能不同。因此可认可该快照的完整栈表现,同时保留对纯硬件归因与严格重现的限制。
成本与推测深度都需要完整分母
头条每美元 token 计算采用每卡小时 1.50 与 2.26 美元的超大规模自有 TCO,得到约 1,816 万与 969 万 token/美元,高 87.4%,等价于模型中的单 token 成本低 46.6%。资本与利用率部分假设未公开,不能当作租赁报价或实际账单,曲线还在不同并发、DCP 和 draft 深度之间插值。
推测深度也不能只看一次接受多少。固定参考曲线下,三 draft 每周期期望提交 3.00 token,四 draft 为 3.36,多 12%;只有完整 draft–verify–commit 周期增长小于 12%,四 draft 才更快。文章未实测这组周期增长,所以它是成本预算示例。
文章没有给出全部优化的独立贡献分解。缓存、算子融合和调度之间会互相改变瓶颈,因此把不同测试中的最高提升连乘,也得不到这套服务的预期收益。
阅读价值在于定位瓶颈的过程。 先核对缓存恢复点,再检查各 rank 是否重复算、临时副本是否真被使用、工作组是否够多;最后按目标交互速度比较整条请求。局部倍率不能相加,也不能把晚于快照的改动追溯成头条收益来源。