AI 集群里的故障经常先表现为产出下降:一块 GPU 变慢、一段网络拥塞或一块 NVMe 盘在负载下退化,都可能让整个训练作业等待。Minerva 最值得关注的变化,是把这些组件信号放回作业关系里,试图回答“哪个基础设施问题正在损害哪项工作”,而不是让网络、计算和调度团队分别解释各自仪表盘。
原文:NVIDIA Unveils Minerva to Bring End-to-End Observability for AI Factories · Brian Sparks / NVIDIA · 2026-10-22
补充:官方技术规格
从设备健康走到有效产出
发布稿把目标称为 AI factory yield,包括有效 GPU 小时、goodput、集群可用时间和 token 产出。这个视角比单独查看利用率更接近业务结果:设备很忙,仍可能在等待、重试或做无法形成有效输出的工作。工程上需要把组件异常、作业受影响范围和产出损失连起来,才能决定先处理哪一个问题。
Minerva 收集 GPU、网络、存储、调度器及工作负载信息。技术规格进一步列出 Spectrum-X、NVLink、SuperNIC、DPU、NCCL 与 Slurm,并支持 OpenTelemetry、gRPC/gNMI、syslog 和 DCGM 等接入方式。多接口的意义,是降低不同团队信号拼接的阻力;它并不自动解决设备身份不一致、采样频率不同或日志缺失的问题。
知识图谱是分析上下文,不只是拓扑展示
平台把 GPU、交换机、线缆和正在运行的作业组织成动态知识图谱。按作业 ID 查看底层日志、指标与异常,可以把“某个接口异常”缩小为“哪些任务的通信路径经过这里”。对于灰色故障,这尤其重要:组件尚未完全失效,单条阈值告警不足以解释分布式作业为什么被拖慢。
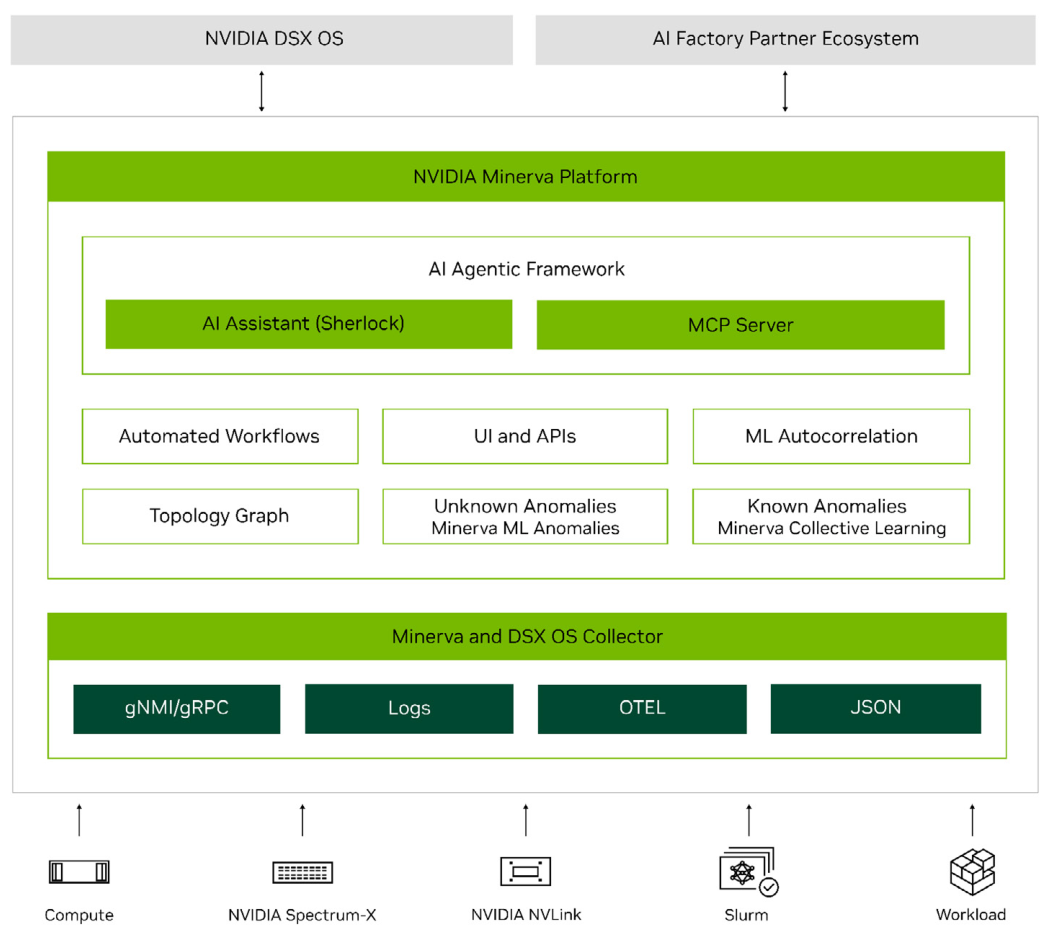
读图:底部采集器接收基础设施与作业信号,中间建立拓扑、异常识别和事件关联,上层通过工作流、Sherlock 与 MCP 接口交付调查及处置能力。
官方描述同时使用监督与无监督模型:已知错误可借助既有模式识别,未知异常则通过正常行为偏离发现,再按依赖关系关联事件。其目标是把成百上千条级联症状收敛成带可能根因的事故。这个机制的价值取决于图谱是否及时反映调度和网络变化;如果关系过期,相关性分析也可能把症状接到错误节点上。
从工程判断看,归并效果应与漏报风险一起衡量。通知减少可以减轻值班负担,但过度合并会掩盖同时发生的独立故障。更有解释力的验收方式,是查看一个事故包含哪些原始证据、为什么关联、有哪些竞争性解释,以及被压缩掉的告警是否仍可追查。这些是由架构推导的评估问题,发布稿没有给出对应误报率或漏报率。
自然语言接口接在实时证据之上
原生助手 Sherlock 使用实时遥测和集群图谱提供查询、调试及修复建议;MCP server 将同类能力开放给外部 Agent 工具。这里的进展是调查入口统一:操作者可以从作业症状追问到相关设备与异常,而不用每次重新描述上下文。
但自然语言解释与执行动作仍是不同层次。官方允许人工实施建议,也允许通过调度器、SuperNIC、交换机 API 或外部自动化系统执行缓解。以节点排空为例,异常检测提供了“值得处理”的信号,调度系统还要决定是否有替代容量、哪些作业可以迁移,以及处置后是否恢复产出。知识图谱提供关系背景,并不代替这些操作约束。
技术规格列出 RBAC、SSO、多租户和高可用。对集成方而言,需要把助手可读的数据范围和自动化可写的资源范围分别配置;MCP 是连接机制,无法单凭接口存在就证明动作授权充分。把建议、批准和执行结果保留在同一事故记录中,才更容易判断自动化究竟减少了排障时间,还是只更快地产生动作。
发布证据支持到哪一步
NVIDIA 称平台可每小时分析数十亿数据点,并面向数十万 GPU 的部署。IREN 被列为使用方,其他多家合作伙伴计划部署。它们说明产品定位和采用进展,但公开材料没有给出统一实验设计、基线、误报统计或完整的 MTTR 对照,不能据此量化“提高多少产出”。技术规格中的定性收益也应按厂商陈述理解。
部署选择包括单用 Collector、自有可观测平台配合 Minerva 分析,以及完整方案;可以在本地运行,也可接入 DSX OS。选择因此不只是买一个新仪表盘,而是决定哪些采集和拓扑能力由现有体系承担,哪些交给专用平台。已有可观测投资较多的团队,尤其需要核对数据重复采集、存储成本和图谱维护责任。
从一次慢作业看闭环是否完整
可以用一个假设场景理解这套结构:某训练作业出现周期性拖尾,GPU 利用率下降,但设备并未报告致命错误。操作者先按作业找到参与节点与通信关系,再检查相邻网络接口、存储延迟和调度事件。如果多个受影响作业共享某个链路,拓扑提供了缩小候选的依据;如果没有这种关系,就不应仅凭时间接近把它们归为同一个事故。
下一步还要验证干预是否符合解释。排空疑似节点后作业恢复,可以增加对假设的信心,但同时发生的负载变化也可能解释恢复,因此应保留干预前后的观测条件。这是根据产品结构推导的调查方式,官方发布稿没有报告该场景的对照实验。它帮助把“有一个根因建议”转化为“这个建议有哪些支持与反证”。
同样需要区分集群健康和单作业健康。集群总吞吐稳定时,一个重要作业仍可能受损;单个作业变快,也可能来自挤占其他租户。以作业为中心的观测若要支撑调度动作,就应同时查看整体容量和受影响对象。这样才能把图谱关联用于优先级,而不只是把更多数据画在同一张界面上。
对于已有 Grafana 或工单体系的团队,外部集成的价值在于让证据和责任流入既有流程。接口是否开放只是起点,事故标识、原始查询和动作结果能否持续对应,才决定跨平台调查是否可追溯。
阅读价值在于作业与基础设施关联的产品化。 对 AI 集群运维,最值得跟踪的是灰色故障能否提前进入调查、事件归并能否保留可追溯证据、缓解能否实际恢复有效工作。先看 Collector 与 Platform 的分工、job ID 关联和动作接口,再看宣传中的规模数字,能更准确判断它与现有监控系统如何配合。