分布式训练中,一块 GPU 异常可能让整个作业停住,但作业恢复与硬件修复并不需要在同一时刻完成。NVIDIA Mission Control 2.5 将自主恢复能力扩展到由 NVIDIA Run:ai 管理的 Kubernetes 工作负载,最值得关注的是职责划分:先让作业找到可用容量继续执行,同时把疑似故障节点移出调度池,再完成诊断与修复。这篇文章提供了恢复流程的工程说明,没有给出受控对照的 MTTR 或训练吞吐提升数据。
原文:How NVIDIA Mission Control 2.5 Brings Autonomous Recovery to Kubernetes
Ryan Prout、Casey Dugas · NVIDIA · 2026-10-26
三个组件回答三个不同问题
调度器决定工作负载放在哪里,作业恢复服务判断当前执行怎样继续,硬件恢复服务判断哪些设备暂时不能承接任务。原文中,Run:ai 管理队列、策略和可用容量;作业恢复服务结合拓扑、放置位置与失败历史形成恢复建议;硬件服务观察节点和 GPU 健康,负责隔离、诊断和修复。
这种分工的意义可以从一次通信超时看出来。超时是作业看到的症状,并不能单独证明 GPU 已损坏。若立刻把节点永久移出资源池,可能损失健康容量;若只重试作业,又可能反复调度回同一故障节点。两个恢复服务需要交换证据,但不必共享同一个完成条件。调度器则根据已经确认的可用状态做放置,不需要等所有根因解释完成。
这里的“自主”也不等于没有策略约束。重启、重排队和重新放置如何落地,取决于资源管理器的集成与作业类型。对使用其他 Kubernetes 调度配置的团队,原文描述的是特定产品集成,不能直接等同于任意集群都具备相同恢复行为。
一次故障分成两条路径
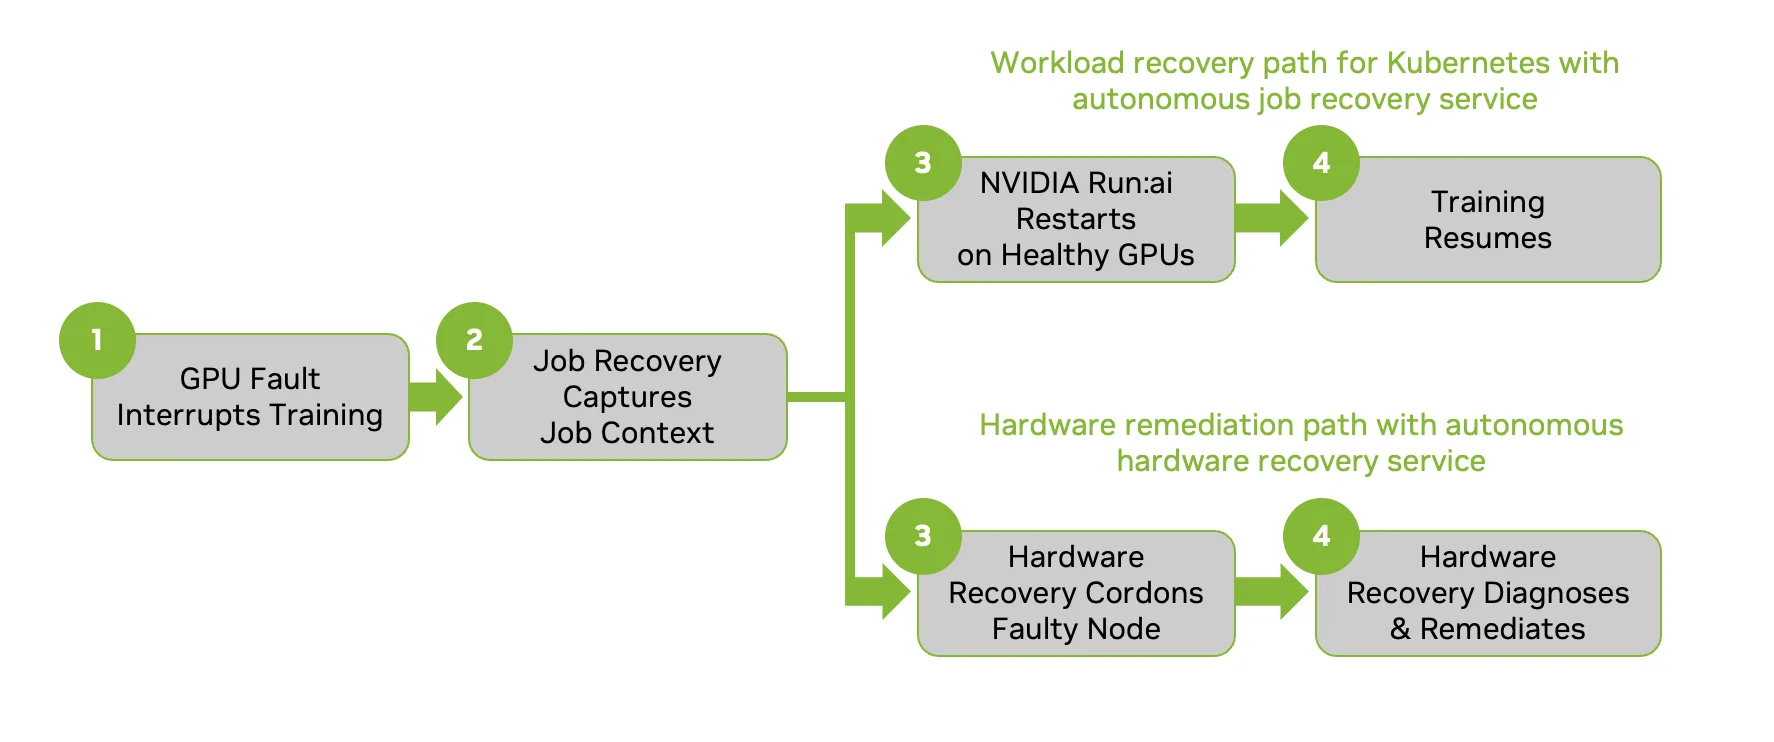
读图:收集作业上下文后,上路在健康 GPU 上恢复训练,下路隔离并修复故障节点。
第一种场景是训练中的硬件异常。作业恢复服务收集上下文,调度集成推动作业在健康容量上重启或重新放置;另一边,硬件恢复服务隔离疑似节点,记录原因并开始诊断。价值在于缩短恢复的等待链,同时避免故障资源立即被下一项作业复用。
从工程上看,这要求“不可调度”状态及时被放置逻辑观察到。否则,作业恢复可能已经提交了新请求,硬件隔离却尚未生效,形成再次落回故障节点的窗口。这是依据流程推导出的集成检查点,文章没有给出该窗口的测量或一致性协议。评估时应关注状态传播与重复故障,而不只看重启命令是否发出。
第二种场景是暂时的软件错误。系统按失败历史和调度策略决定是否重试,硬件恢复继续监控,但没有新证据就不介入修复。这种克制很有价值:同一程序缺陷若在多个健康节点上重复出现,持续隔离设备只会缩小资源池。相反,重复或不可重试的错误应转入升级处理,而不是无限延长自动重试。
第三种场景是健康告警先于作业失败。反复的 GPU 告警或连接问题可以触发预防性隔离,使新作业避开风险节点。这将可靠性控制前移,却也引入误报成本:隔离过于敏感,健康资源会闲置;隔离过于迟缓,故障又会扩散到新的任务。
恢复速度取决于状态能否接续
把作业调到健康 GPU 只解决了执行位置,训练进度还要依赖可读且一致的检查点、数据加载状态和恢复入口。文章描述了从检查点重启的流程,但没有证明所有训练框架都能无损接续。因此,不能从“自动恢复”推导出“零训练进度损失”,更不能把节点重新上线当成原作业已经恢复。
一个可用的评估方式,是把事故后的时间拆成故障识别、容量隔离、等待健康资源、恢复状态与重新产出有效训练步。这个分解是工程分析,不是产品公布的指标。若主要时间花在容量不足或检查点读取上,自动化诊断再快,也未必显著减少总停顿;若故障节点反复污染后续调度,隔离一致性可能比单次重启速度更重要。
正常运行时也有成本。健康检测和诊断占用资源,备用容量压低瞬时利用率,过于积极的迁移还会增加状态恢复次数。只统计 GPU 忙碌率会混入失败重算,较有解释力的指标是有效训练进度、重复失败次数和健康容量被误隔离的时间。
还应把作业故障与节点故障的统计分开。一项跨节点训练任务可能因单点异常整体重启,同一块设备也可能先后影响多个作业;直接相除会混淆不同分母。若用平台指标比较更新前后,应保持任务规模、检查点频率和排队负载可比,否则恢复时间变化可能只是工作负载改变。
回归服务是闭环的另一半
故障节点被移出调度池之后,必须经过明确的健康验证才能回归。否则自动化只是把人工操作加速,未必减少复发。反过来,修复完成却迟迟不能重新调度,也会形成闲置容量。原文用健康状态与调度资格的交叉关系解释了这两种损失,提醒团队同时观察“危险但可调度”和“健康但不可调度”的节点。
对实际验证,可以选择三类与文章相符的场景:可隔离的硬件故障、无需隔离的可重试软件失败,以及尚未导致作业失败的退化信号。每类都应跟踪作业和节点的不同结局:是否重复触发、有没有恢复有效进度、何时允许节点重返资源池。这些是评估建议,不是原文已经完成的独立实验。
这项更新值得关注,因为它把 Kubernetes 作业恢复纳入更完整的基础设施控制流程。阅读重点应放在三类失败如何分流,以及调度状态如何与恢复证据衔接。收益是否成立,最终取决于目标集群的故障组成、可用容量和训练恢复能力;文章展示的是机制与集成方向,尚不足以给出可迁移的性能倍率。