Kevin Lee, Yashar Bayani, Ahmed Sharif, Yee Jiun Song · Meta Engineering · 2026-10-19
原文:Inside Prometheus: Meta’s Journey to a Gigawatt-Scale Supercluster
Prometheus 最值得关注的不是最终规划中的百万 GPU,而是 Meta 怎样让已经投入运行的庞大集群持续产出有效训练进度。原文把网络、备件、checkpoint、硬件筛查和功耗控制放在一起:一个部件故障会不会扩大成全任务中断,往往比部件本身多快更影响训练周期。首期已完成,约百万 GPU 仍是完整规模目标,两者需要分开理解。
分层网络对应训练的通信层次
数据并行副本内部的通信对带宽和时延更敏感,副本之间相对宽容。Prometheus 因此在楼内安排高带宽低时延 fabric,再以 Backend Aggregation 网络连接楼宇;BAG 覆盖距离从约 2 km 到超过 100 km。距离带来的传播时延不能靠交换机优化消失,训练并行划分也要跟着物理网络设计。
楼内单个 fabric 最多连接 20,736 张 GPU。早期 DSF 使用更细粒度多路径、重排、虚拟输出队列和基于 credit 的流控处理长流碰撞;NIC 能在端点重排后,设计转向采用浅缓冲交换机的 NSF。这说明可靠性与性能不只靠增加带宽,还取决于拥塞控制和责任放在哪一层。
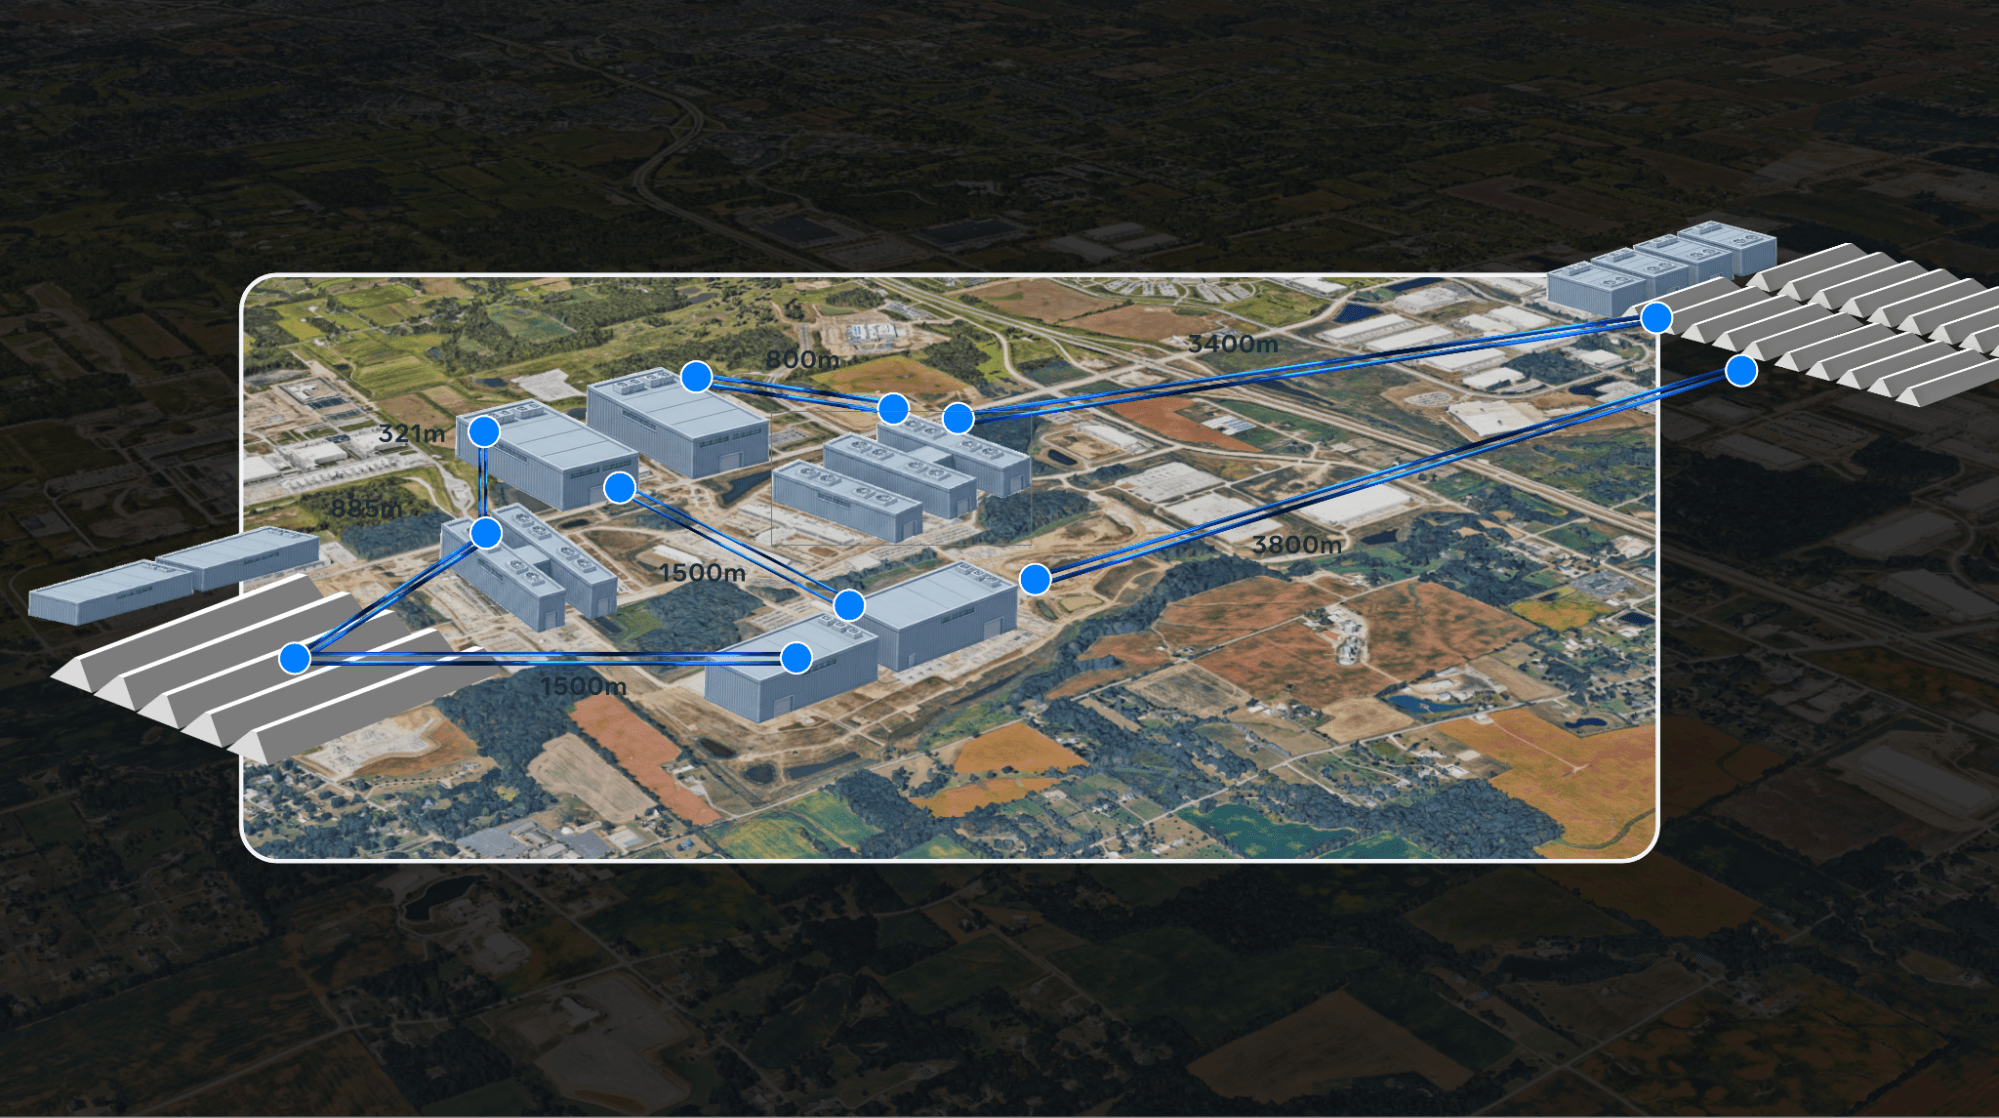
蓝色连线连接不同楼宇;物理距离说明跨楼通信与楼内紧耦合通信需要不同安排。
Catalina 的 GB200 Ariel 配置将 72 GPU 分到两个机架,以每 GPU 两张 400G NIC 提前提供 800G scale-out。作者的理由是:计算、HBM 和 scale-up 都提升后,保留较低的外部带宽会形成新瓶颈。后续 GB300 平台原生提供 800G,每个 72-GPU 域可以装入单机架。型号更新同时改变网络和维护方式,不能仅用峰值 FLOPS 解释系统进步。
备用 GPU 为什么不是简单浪费
从 NVL8 到 NVL72,紧耦合域扩大九倍,潜在故障影响范围也随之扩大。Meta 采用每域 64 张活动 GPU 加 8 张域内备件的布局,匹配训练常用的二次幂分组;另保留约 2% 机架应对整架故障。域内故障可以切换到备件并恢复,不必等待物理维修完成。
原文给出一个具体配置:32,768 张活动 GPU 对应 523 个 NVL72 机架,共 37,656 张 GPU。原文称其比活动规模高约 13%,但按所列数量计算,备用占总供给约 13%,相对活动 GPU 则多配约 14.9%。这里分母不能混用。大部分余量来自 64-of-72 的切片几何,并非全部是额外购买的可靠性保险。
这种取舍要看有效产出:减少闲置备件会提高名义利用率,但一次中断若让数万张卡一起等维修,实际 goodput 可能更差。它也依赖故障分布;域内备件无法解决把整个供电或网络域一起带走的事件,因此整架备件和恢复策略仍然必要。
按故障影响范围选择恢复方式
PAFT 处理能隔离在单个数据并行副本内的故障:其他副本重做当前步并继续训练,故障副本到备用主机重启后重新同步。其代价是暂时减少吞吐,而不是整个任务停止。超过这个边界的故障,则让全任务退回 checkpoint。
checkpoint 异步写入多级存储,结合增量保存和内存 staging,以降低正常训练的保存开销。备件缩短替换硬件准备时间,checkpoint 减少丢失进度,PAFT 减少需要全局恢复的事件;三者作用不同,不能拿其中任意一项代表完整容错方案。恢复后的节点还要隔离验证,防止坏部件过早返回计算池。
结果要用有效训练时间读
Meta 报告 Muse Wonder 训练中,预训练 goodput 超过 85%,RL 超过 90%;当时 MTBI 约 47k GPU-hours,后续固件等修复提高到超过 54k。GPU-hours 是按设备规模归一化的口径,不能解读成整个大任务连续运行数万小时。
团队还报告,相对 2025 年中每 8K GPU 每日接近 1,000 次中断的早期峰值,中断率降低 99%。这是硬件导入期到逐步成熟的整体变化,涉及 NVLink 信号筛查、内存固件与纠错、交换 fabric 恢复、网络重路由和运营协同,不能归因于单个算法。每 8K GPU 每日两次中断、约 100k GPU-hours MTBI 仍是目标,不是已经实现的结果。
功耗波动也是可靠性问题
同步训练会让计算和通信阶段一起切换,原文描述 30–40% 的功耗瞬变。Dynamo Dimmer 接近供电上限时逐渐调整 GPU 功率,而不是直接停任务;机架电池、容性缓冲与设施储能分担不同时间尺度的波动。液冷及维修质量控制也在同一闭环内,因为温度和电源故障最终都会表现为训练进度损失。
从中断归因到可验证的修复闭环
原文将 NVLink 信号完整性、HBM/LPDDR、交换 fabric 和后端网络分别处理,而不是把所有训练停止都归到“GPU 坏了”。例如,链路筛查试图区分瞬态错误与持续信号质量问题,前者和后者需要不同维修动作;内存错误则通过设备群体的重复模式指导固件设置、scrubbing 与提前淘汰。故障分类能否稳定复现,决定修复投入是否真正命中主要损失来源。
另一个容易被忽略的指标是改进传播速度。团队称已能在几小时内把固件及驱动修复推到超过 100k GPU,单 pod 升级时间的 P90 从早期超过七小时降到两小时。修复有效却发布很慢,仍会让大量设备持续暴露于已知问题。发布效率本身因此也是可靠性机制的一部分,但更快升级不能替代上线前验证和修复后隔离。
从这套实践可推导出一个可迁移的观察方法:先确认中断影响了哪些活动副本,再测恢复损失的进度和时间,最后核算备件与维护占用。相同中断次数,在快速局部恢复和全任务 checkpoint 回退下会造成完全不同的有效计算损失。只看设备可用率,既可能高估忙于恢复的 GPU,也可能低估那些为缩短恢复而保留的备件。
把这些指标放到同一个观察周期也很重要。中断率取自硬件导入阶段、goodput 取自特定模型训练、MTBI 又随着后续固件变化而更新;它们不是同一次实验的三个读数。理解时间背景,才能避免把早期峰值改善误当作成熟平台上任何训练任务都能继续获得的同等收益。
这篇文章提供的是工业运行经验,最有参考价值的是指标和故障域如何对应:同时看中断频率、恢复时间、备用容量与 goodput。它没有逐项隔离贡献的对照实验,也没有给出完整训练任务分布。阅读时可借鉴分层恢复和归因流程,而不把一个超大集群的备件比例直接套到不同规模与故障结构的系统。