服务端请求成功,不一定意味着用户完成了操作。页面脚本出错、弱网下的等待,以及提交后没有收到确认,都可能落在后端可用率之外。Datadog 这篇文章值得关注的变化,是把可靠性目标放到完整用户旅程中,再用真实用户监控(RUM)和合成测试分别观察。判断它的价值,关键在于指标是否忠实表达用户遭遇,而不是界面上汇集了多少个绿色状态。
原文:Build better SLOs with RUM and synthetic SLIs
Addie Beach、Andy Amick · Datadog · 2026-10-20
两种观测,保留两种问题
合成测试按计划执行受控路径,适合回答“这条路径现在还能否走通”;RUM 从实际会话观察操作,适合回答“使用者是否成功、用了多久”。原文把两者放在 Journey Monitoring 中关联;该功能在文中仍处于 Preview。这里的进展是将用户旅程作为组织可靠性证据的入口,并没有给出一种新的故障检测算法或通用的准确率提升。
工程上,最好保留两条证据线。探测失败而真实请求正常,可能意味着测试账号、区域或脚本的问题;真实请求恶化而探测正常,则可能暴露脚本没有覆盖的设备或输入。两者不一致是值得调查的现象,简单求平均反而会抹掉差异。
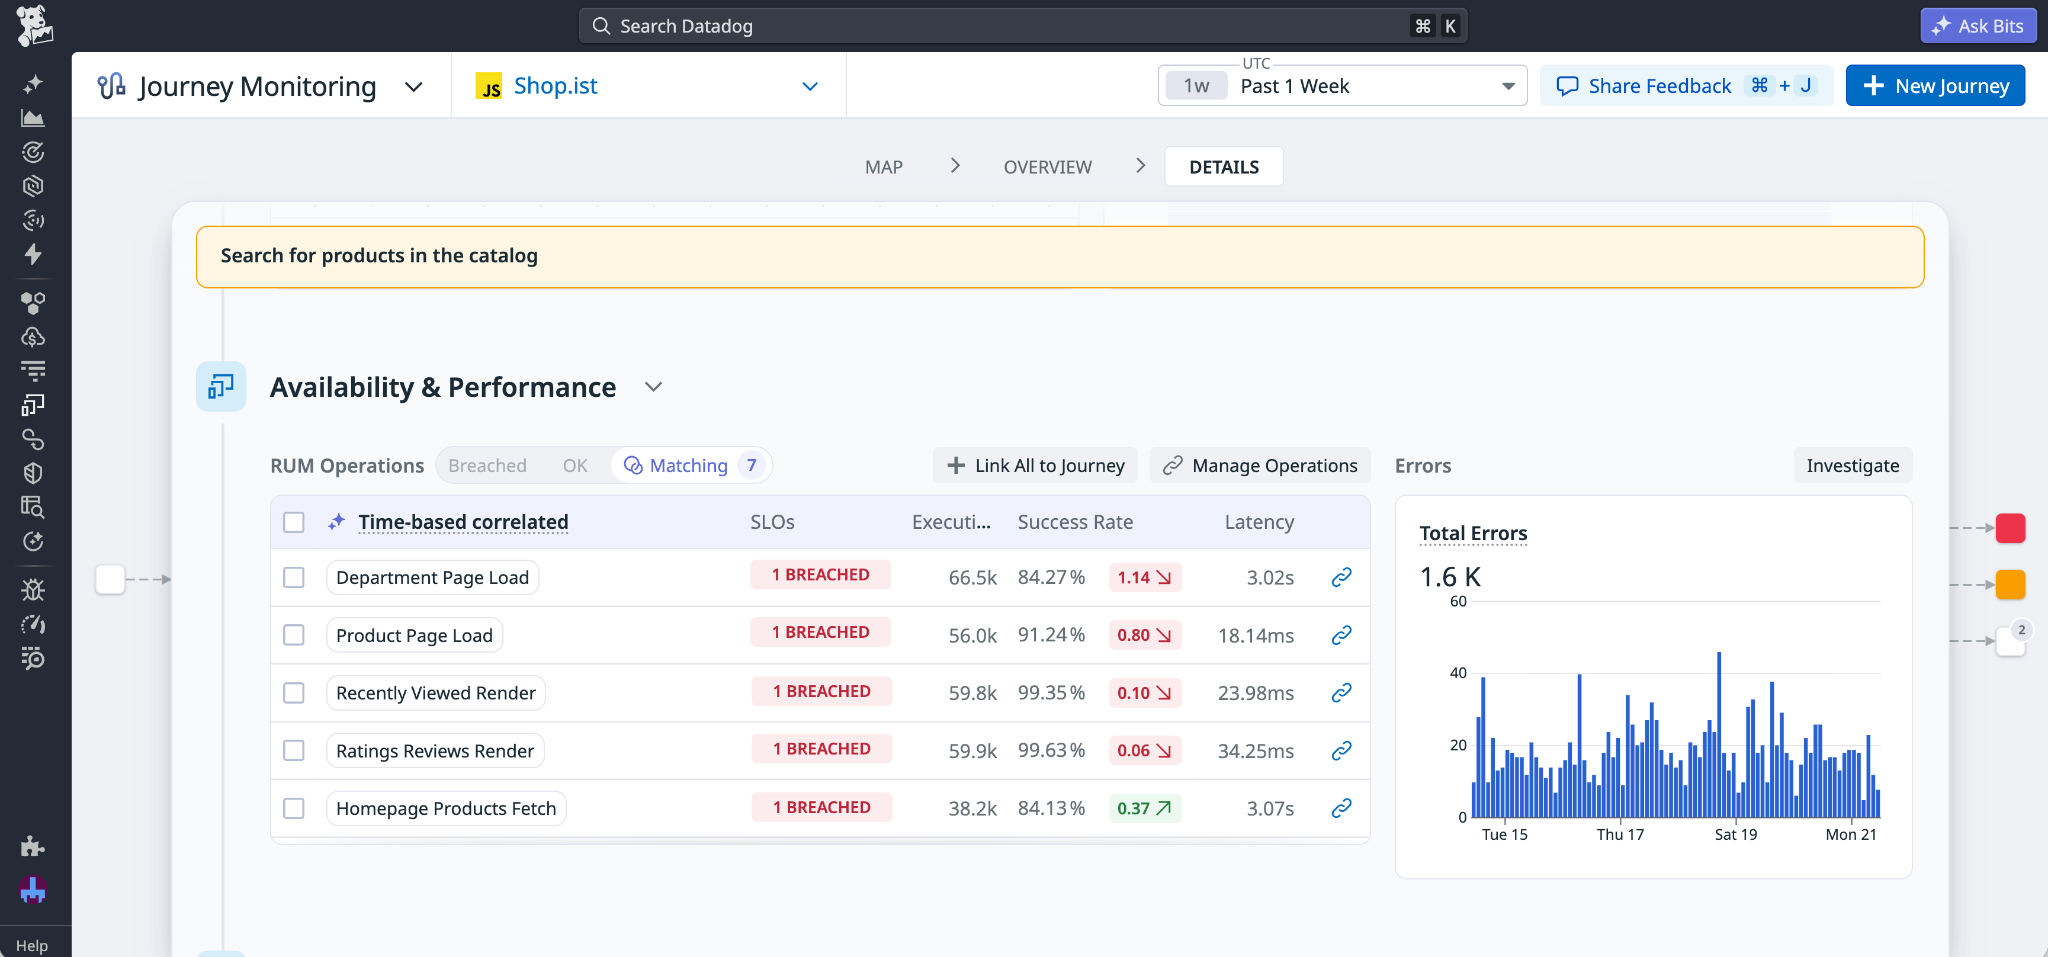
读图:先看旅程下的操作,再比较各操作的成功率、延迟和 SLO 状态;这是官方产品示例,不是一次性能评测。
先定义分母,再讨论目标
Metric-based SLOs 文档按窗口内好事件与全部纳入事件的数量计算 SLI。指标查询中对操作、环境和用户群的过滤必须一致,否则得到的比例甚至不再对应同一组请求。按事件数加权也意味着繁忙时段影响更大,不能与“每分钟是否健康”的比例互换。
一个用于理解的假设例子:上午有 990 次成功、10 次失败,深夜只有 1 次成功、1 次失败。把两个时段成功率平均,会得到 74.5%;按事件汇总则约为 98.9%。两者回答不同问题。若目标是用户操作成功率,应使用对应事件总数;若目标是各时段持续可用,应另建时间口径,不能为了数字更好看而切换分母。
RUM 操作指南进一步区分结果:可用性计算排除主动放弃,将超时计为失败;延迟计算把超过阈值的放弃纳入坏事件,却排除没有可靠完成时间的超时。这些定义把“慢”和“失败”分开,避免把所有未完成行为机械地当成一种故障。若网站的业务含义不同,需要先确认操作埋点是否吻合这些定义。
测量分辨率必须配得上承诺
Monitor-based SLOs 文档说明,这类 SLO 根据监视器处于告警状态的时间计算,并受每分钟评估的粒度约束。用七天窗口和 99.999% 目标做算术检验,允许的故障时间只有约 6.05 秒:
一分钟状态变化已超过整个预算。这个例子解释的是目标与测量能力不匹配,不是建议把平台不支持的精度强行配置进去。测试运行间隔、重试和告警确认还会改变何时进入失败状态,所以“失败测试次数”和“告警持续时间”也不能混为一谈。
Time Slice SLOs可直接用指标条件评估 1 分钟或 5 分钟切片,不必维护中间监视器;但它仍然是时间离散化。文档还明确将缺失数据计为 uptime。对工程判断而言,绿色 SLO 必须同时配有采集健康检查,否则遥测中断可能被误读为服务恢复。
把旅程变成可追查的操作链
一种可行的设计顺序,是先选一条业务关键路径,明确起点、终点和失败定义,再把其中的关键技术操作分别建模。例如“用户完成付款”可以要求提交成功且收到确认,而不是只记录按钮点击。此处是工程设计示例,并非产品已自动理解所有业务完成条件。
随后用受控测试检查端到端通路,用真实操作检查设备、地区及流量构成下的体验。定位问题时,先判断是共同退化还是单个群体恶化,再回到相关操作的错误和延迟。保留各自的时间窗口和分母,才能解释为何一个告警触发而另一个没有触发。
低流量也不能仅靠加宽窗口解决。窗口变长会稳定比例,却延迟发现故障;增加探测频率可以缩短空白,但增加成本,也不会自动覆盖新用户路径。这里需要根据故障持续时间、业务敏感程度和诊断能力做取舍,而不是追求统一频率。
告警后的行动也要与口径一致
一个容易被忽略的取舍,是全站比例与局部体验可能同时正确,却给出不同的优先级。假设一个新版本只影响少量使用旧浏览器的用户,整体成功率变化可能很小,但该群体已无法完成关键操作。分组查看并不是为了寻找最差数字,而是为了明确服务承诺究竟针对全体平均,还是也包括重要的用户群体。
反过来,细分维度越多,每个分组样本越少,偶然失败造成的波动也越大。因此,告警应同时让处理者看到事件数量、影响对象和持续时间,而不只显示一个百分比。是否立即响应,可以结合业务关键性和合成测试是否同时异常决定;这种判断不能由一条无上下文阈值替代。
最后还应检查恢复语义:故障结束后,长窗口的预算可能仍未恢复,而短窗口已不再恶化。前者影响后续发布节奏,后者帮助判断事故是否仍在扩大。把“服务恢复”与“预算恢复”分开,才能避免团队在同一面板中争论两个不同的问题。
值得采用的是什么
这是一篇测量设计与产品工作流文章,公开内容没有证明某种组合能普遍降低 MTTR。值得迁移的是分开定义实际体验与受控可达性,再让两种证据在同一旅程上相遇。上线前可以用一次已知故障检查:它是否进入正确的分母、是否消耗预期预算、能否从违约追到具体操作。这样的验证比增加一个总览百分比更能说明 SLO 是否有用。