原文:Introducing TorchNeuron: Native PyTorch backend for AWS Trainium · 2026-10-19
作者:Nafea Bshara、Robert Hundt、Ron Diamant、Colin Brace、Rahul Solanki、Maen Suleiman、Khaled ElGalaind、Temesghen Kahsai、Cyril Bortolato、Indu Thangakrishnan、Shauheen Zahirazami、Sarang Ozarde、Adarsh Singh、Hanbo Wang、Esha Lakhotia、Jianying Lang。
变化发生在框架与芯片之间
TorchNeuron 值得关注的不是一组新的模型分数,而是 Trainium 接入 PyTorch 的方式。公告把它定位为原生设备后端,通过 PrivateUse1 扩展点和设备无关 API,让已有模型、训练库和性能工具进入 Trainium2、Trainium3。目标是减少为了硬件重写工作流的需求,让研究调试与生产编译共用一套模型表达。
官方示例用 .to('neuron') 选择设备,编译时指定 backend="neuron"。这展示接口入口,不意味着所有 CUDA 专用代码或任意动态模型都能只改一个字符串。可迁移性取决于算子、数据类型、形状与通信能力是否真正覆盖目标负载,后面的测试和限制比示例本身更能说明范围。
一套前端,两种执行路径
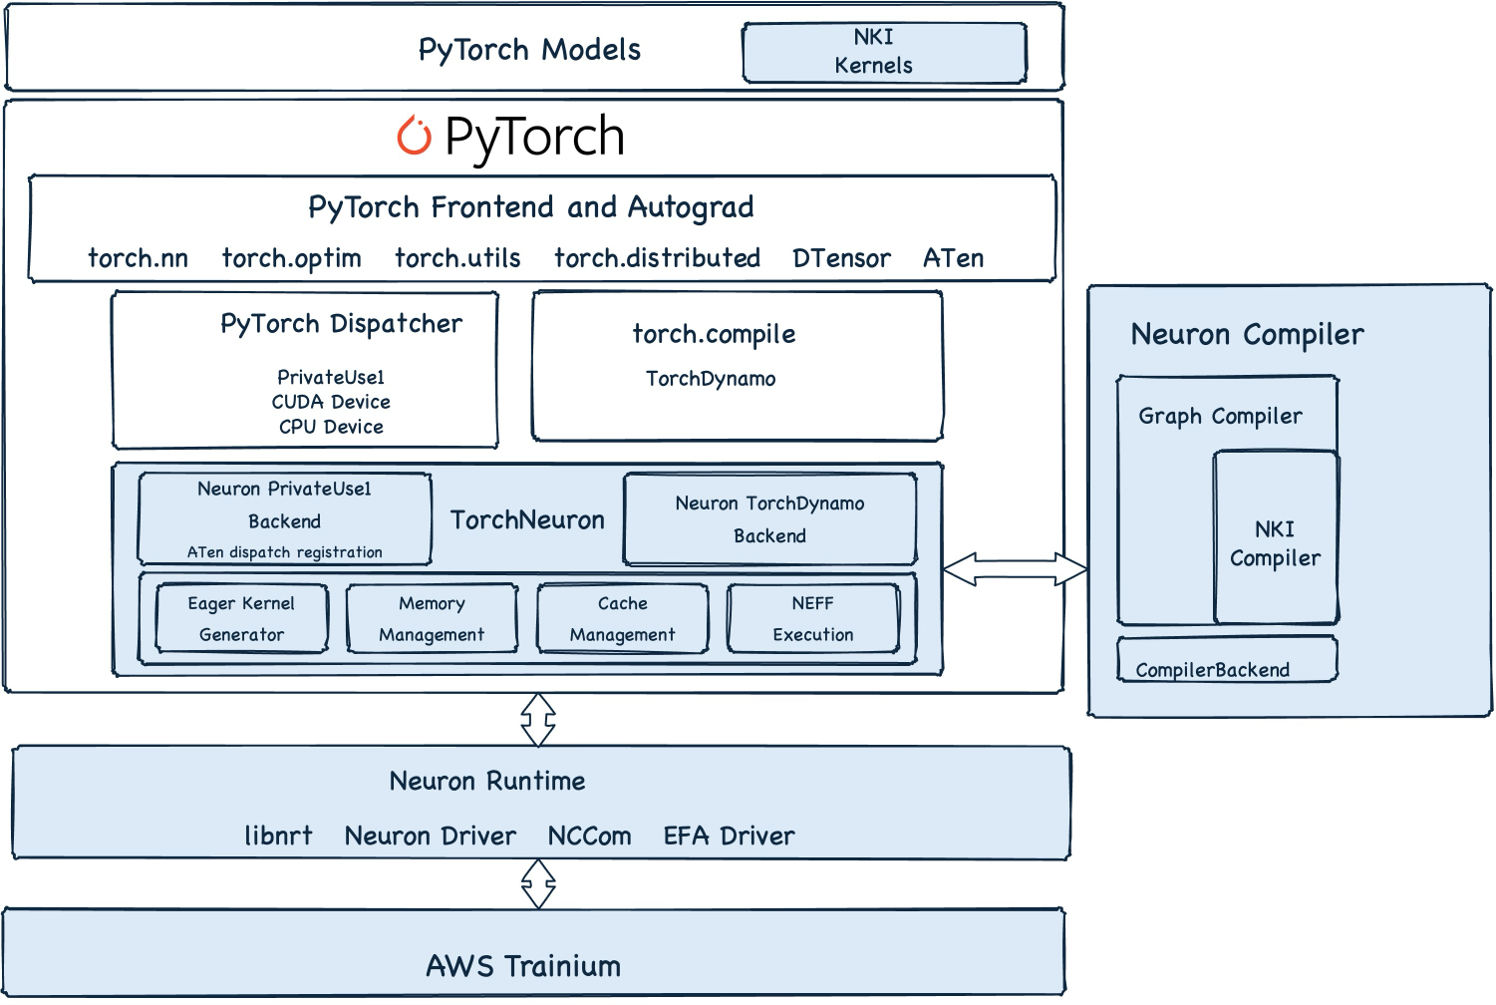
从上向下看共享 PyTorch 前端;中间分为 eager 分派与图编译,随后经 Neuron 编译器和运行时到达 Trainium。
eager 路径逐个分派操作,保留 Python 控制流、打印和断点,方便研究与调试。其代价是独立操作可能各自编译成 NEFF 可执行文件、启动设备执行,并把中间数据写回 HBM。接口灵活并不消除编译、启动和数据搬运开销。
公告同时介绍实验性的 adaptive eager,试图减少启动成本、增加融合机会,接近编译图的性能。这里没有给出可通用于全部模型的加速倍率,因此应理解为一条正在发展的执行路径,而非 eager 已与完整图优化等价。
稳定工作负载可用 torch.compile:TorchDynamo 捕获 FX 图,AOTAutograd 处理反向图,后端经 Torch-MLIR 降至 StableHLO,再由 Neuron 编译器生成 NEFF。这条链能跨算子优化,却也需要清楚的图与形状边界。公告将动态和符号形状列入首发未支持项,不能从“原生 PyTorch”推导出完整动态行为支持。
原生 API 仍有硬件语义
分布式接口包括 DDP、FSDP2、SimpleFSDP、张量和流水线并行,以及 DTensor、DeviceMesh。集合通信使用节点内专用通信核和节点间 EFA。它降低了应用层迁移负担,但通信拓扑、分片方式与模型规模仍决定实际效率,API 一致不是通信成本相同。
stream 和 event 的说明尤其值得读。流内保持顺序,跨流依赖需要事件显式连接;非默认流复用一个硬件队列,不会各自获得独立引擎。因而创建更多流未必增加物理并行。异步错误在下一同步点抛出,后端保留最早异常的上下文;排查时要沿依赖回溯,而不能只看报错所在代码行。
NKI 则提供自定义算子的底层通路,可同时接入 eager 与 compile,官方 NKI-lib 提供 attention、MoE 等实现。工程上的取舍是:通用算子保留迁移便利,关键热点可换成硬件专用内核,但手写内核仍需要维护数值行为、自动求导与目标硬件上的正确性。
可观测性把框架事件接到设备执行
TorchNeuron 接入 torch.profiler,并用 NeuronConfig 控制运行时和设备数据采集。Neuron Explorer 将框架、运行时与硬件事件关联到源码,支持查看调用层次与等待依赖;还可导出按算子、引擎组织的 Parquet 数据,供程序分析。
这对性能诊断的价值是缩短从“某一步很慢”到“等待了哪项计算或搬运”的距离。它提供可调查的证据,而不是自动保证找到根因。实际分析仍应区分首次编译、模型加载、预热和稳定执行,否则一次长编译会掩盖稳态热点,或缓存后的漂亮数字会掩盖启动成本。
覆盖数字必须连同分母看
官方称持续扫描 10 万个 Hugging Face 模型,按下载量覆盖 99.9% 的使用量;这些运行采用缩小但有代表性的配置,检查加载、前向、反向、编译和 CPU 回退。它不是 10 万个原始规模模型全部通过训练的声明,下载量覆盖也不是架构覆盖或正确率。
上游测试的 2026 年 8 月运行约有 15.4 万项结果,其中约 6.9 万跳过:约 3 万来自 PyTorch 自身的适用性检查,另约 3.9 万是 Neuron 主动跳过,后者中约 2.2 万涉及尚无原生 lowering 的算子。跳过数量解释了为什么只看“已启用测试通过率”会高估完整兼容性。
首发边界还包括稀疏与 NestedTensor、前向模式自动求导、任意 attention mask、部分插值与量化功能等。BF16、FP32、FP16 是公告列出的模型类型;TorchAO 与 FP8 当时仍处私有 beta,计划后续发布。应把已支持、实验性、私有测试和未来计划分别理解。
迁移判断应沿数据流展开
对一个具体模型,第一层是执行能否覆盖:哪些算子原生运行,哪些回退到 CPU,是否依赖首发尚不支持的形状或张量类型。第二层是输出是否保持预期:同一输入的前向结果、训练梯度与长期收敛分别回答不同问题,某个算子测试通过不能替代完整训练验证。第三层才是性能:编译后的图是否减少了中间写回,通信是否成为新的等待点。
CPU 回退尤其容易被一个“能运行”的结论掩盖。若反复在主机与设备间搬运张量,模型可以正确执行却无法达到预期吞吐。公告的扫描明确记录回退,因此阅读覆盖图时,应将加载成功、计算成功和全部在设备执行区分开。这是从测试设计得出的使用判断,不是说被测模型普遍发生回退。
优化路径也不必一次完成。研究阶段需要可观察、可调试的执行;稳定阶段可以编译热路径;只有证据指向关键算子时,专用内核的维护成本才有明确对象。这样的分层理解解释了为何 eager、compile 与 NKI 同时存在,也避免把原生后端误解成唯一执行策略。
当前值得怎样跟进
10 月 19 日公告计划于 10 月 20 日以 Apache 2.0 开源并进入 public beta;本篇没有独立验证该日包和仓库已经上线。最值得继续阅读的是架构、测试分母与功能边界,再针对真实模型判断能否顺利迁移。
从本批领域进展看,TorchNeuron 改善的是开发接口与工具链衔接,DIFFLET 讨论的则是扩散组件怎样编译、驻留与服务,两者处在不同层。对一个候选负载,有意义的工程比较应同时保留输出质量、CPU 回退、启动费用、稳态吞吐和尾延迟;公告没有提供这些维度上的统一优胜结论。