vLLM Team、Inferact、Red Hat、NVIDIA · 官方技术预览 · 2026-10-09
原文:vLLM Support for NVIDIA Vera Rubin NVL72: 7.8x Throughput over GB200 NVL72
先看服务曲线,再看硬件倍率
vLLM 对 Vera Rubin NVL72 的支持,值得关注的不只是下一代 GPU 跑出了更高吞吐,而是软件开始针对 GPU 内部的内存位置调整计算。官方预览同时讨论了兼容运行、专用内核和 locality domain:前者让模型尽快可用,后两者决定新增算力与带宽能有多少转化为服务收益。
最醒目的 7.84 倍来自 MiniMax M3 的 AgentX 测试,口径是在匹配交互速度时比较相对 GB200 NVL72 的每 GPU 吞吐。同一篇文章在 150 TPS 约束下给出 5.18 倍。这两个数字描述性能曲线的不同位置,并不冲突;对实时 Agent,吞吐必须和用户获得后续 token 的速度一起看。
硬件资源增长,瓶颈却不会同比消失
按官方文章相对 GB200 NVL72 的比较,Rubin 提供约 5 倍 NVFP4 FLOPS、2.4 倍 HBM 带宽、1.7 倍双向 NVLink 带宽,FP32 指数运算吞吐提升 2 倍,BF16/FP16 提升 4 倍。指数运算关系到 softmax,说明矩阵乘法之外的部件也需要跟上。
这些提升并非可以相乘的加速因子。一个执行阶段受计算限制,另一个可能受权重读取限制;跨设备通信又可能成为下一段等待。作为工程推论,评估新平台应先识别 prefill、decode 和通信各自的限制,再判断哪一种硬件增长与当前负载有关。仅用峰值低精度算力预测整个服务,容易忽略批量大小和访问模式。
Locality domain:让算子靠近自己的权重
文章最具体的机制是 CUDA 13.4 的 locality domain。GPU 内部不同 SM 到不同 HBM 区域的访问成本并不均匀;结合 Green Contexts 与 CUDA stream,可以把计算分组,限制每组 SM 访问分配给本地的权重,从而减少跨域读。
以 MoE decode 为例,token 较少时,前向过程主要消耗在从 HBM 读取专家权重。官方采用 split-N:对 FC1 和 FC2 的权重矩阵按列切分,把两半放在两个域中,各域内核读取自己的那部分。输入和输出激活仍跨两个域使用,因为这一小 token 场景里激活相对较小,额外访问代价较轻。
这里的关键是同时安排计算与数据。如果只把 SM 分组,却让两组都远程读取整份权重,局部带宽优势未必能兑现;若把这种激活很小的判断推广到大批量 prefill,也可能改变收益。这是由机制推导出的适用边界,原文没有声称所有矩阵乘法都能同样获益。
域划分还涉及可用 SM 数量。默认等分方式只使用 212 个 SM 中的 200 个;启用 backfill 模式后可使用全部 212 个。文章同时报告这两种模式,小 token 前向平均约有 1.2 倍加速,即使少用部分 SM 也有类似收益,支持瓶颈主要在权重读取的解释。
但这一实验计时的是 MiniMax M3 形状下每个 rank 的 FC1+FC2,采用均衡路由,不包含通信时间,并比较 TP2、TP4、EP2、EP4。它只能说明这段 MoE 计算有改善,无法单独解释整个 AgentX 的 7.84 倍,也不能代表专家路由倾斜时的端到端效果。
层级收益怎样传到用户等待时间
一个简单的工程估算可以帮助理解这条边界。假设被加速的 MoE 层占原请求耗时的一半,且其他部分完全不变,那么层级快 1.2 倍之后,总时间仍约为原来的 0.5+0.5/1.2,即约 0.917,整体只快约 1.09 倍。这是说明用的假设计算,不是文中测量;它也没有包含排队与并发改变后的非线性影响。
线上系统靠近饱和时,少量执行时间变化可能显著改变队列,所以层级收益既不能机械相乘,也不一定线性传递。需要分别观察首 token 等待、后续输出速度和总吞吐。图中的 P90 interactivity 属于输出交互速度口径,不是 P90 请求总延迟;把它当成完整响应时间,会遗漏长输入处理和请求排队。
精度同样影响比较。NVFP4 算力增长、FP8 KV cache 和特定 checkpoint 对应的是不同配置条件;更高吞吐本身并不证明精度变化对任务质量没有影响。对于需要保持既有回答质量的部署,合理的工程做法是把性能与任务质量分开验证。原文的这组吞吐结果没有建立一套跨精度的质量等价结论。
可运行与充分优化处在不同阶段
Rubin 是新的 sm107 编译目标,同时能运行面向 Blackwell 家族 sm100f 的内核。这使已有大量 GEMM、注意力和 MoE 路径能够先工作,再逐步加入硬件专用优化。文章给出的每日容器是 vllm/vllm-openai:cu134-nightly,使用 CUDA 13.4 与 PyTorch 2.15;模型覆盖包括 DeepSeek、Kimi、GLM 和 MiniMax。
针对 Rubin 的优化通过 FlashInfer 0.7.0 等组件接入,涉及低精度 GEMM、NVFP4 MoE、FP8 attention 和 MSA prefill。附录也体现了配置的约束:不同权重格式对应不同 linear backend,FP8 attention 需要匹配的 KV cache 精度,专家并行内核还依赖部署方式。模型能加载与某个最快内核真正生效,是两个需要分别确认的状态。
从部署管理角度推导,每日镜像标签会随时间变化,比较结果时需要固定实际镜像及模型配置,记录精度与并行方式。文章的价值是展示当时已经打通的路径,而不是保证未来任一 nightly 都与图中环境相同。
怎样读这张吞吐图
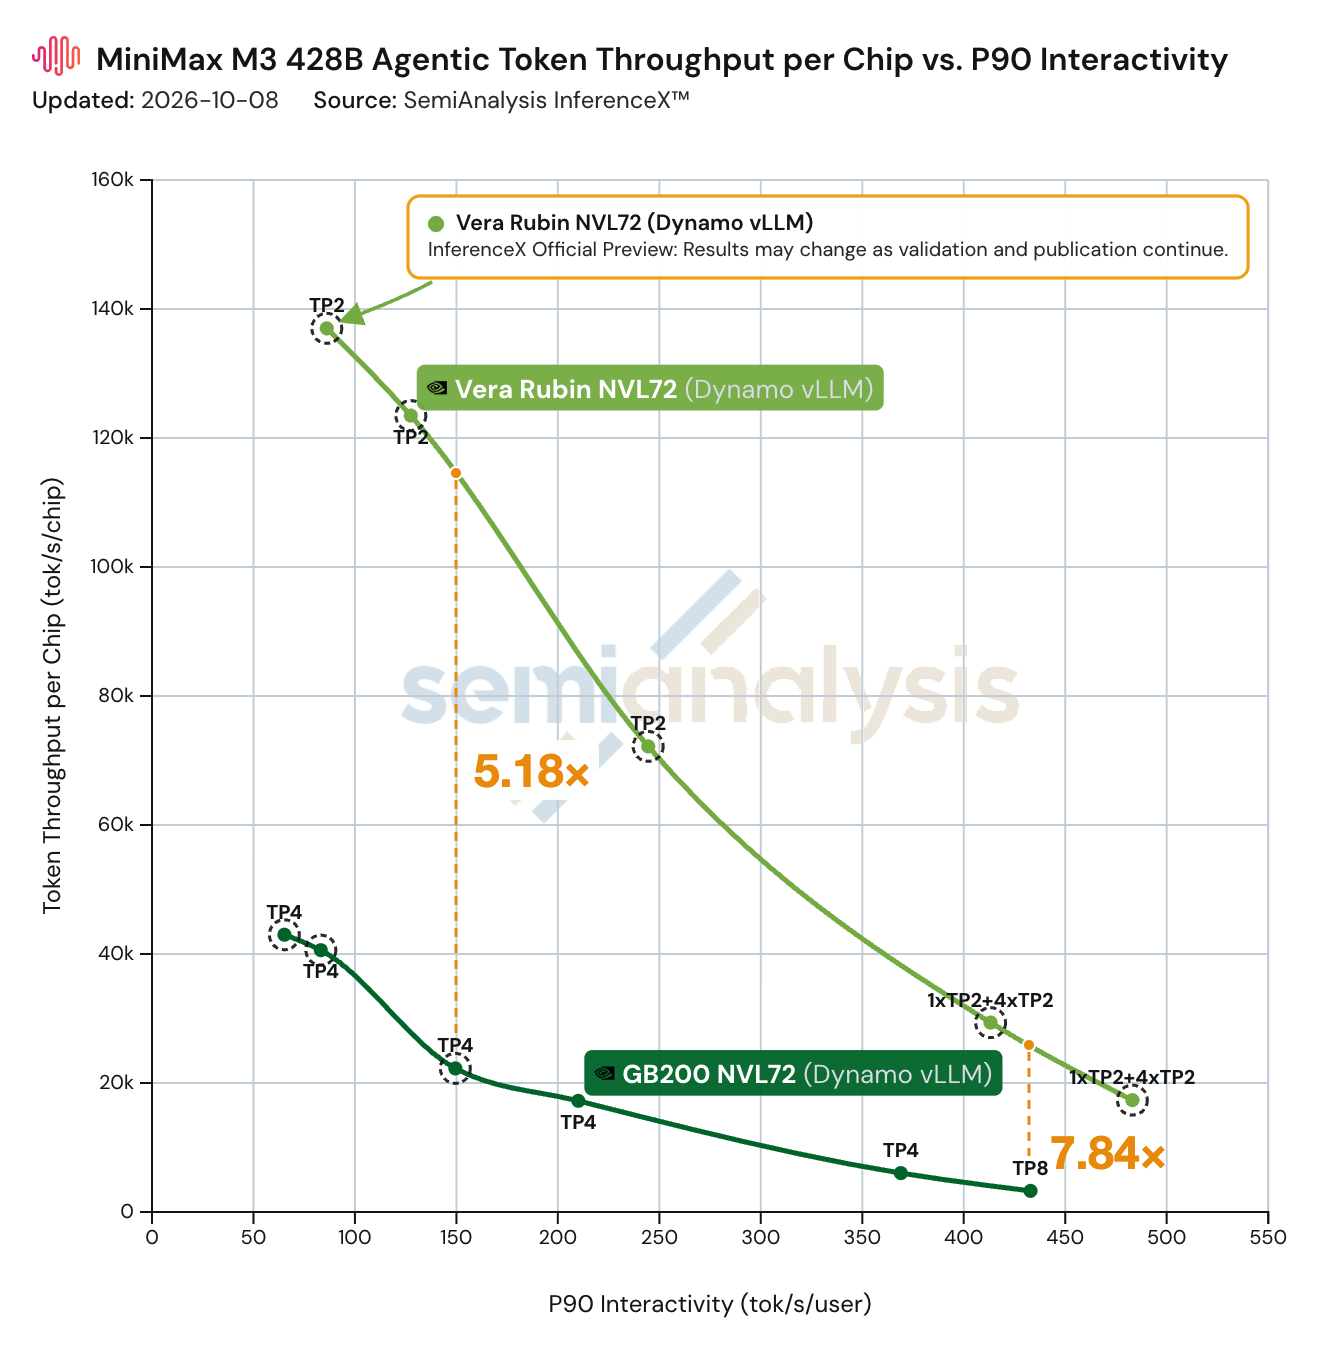
读图:横轴是 P90 单用户交互速度,纵轴是每芯片 token 吞吐;在相同横坐标比较两条曲线。150 TPS 位置标出 5.18 倍,更高交互速度处标出 7.84 倍。图中同时保留不同 TP 配置与官方预览标记。
曲线展示了吞吐与交互速度的取舍,也表明不能只拿两条曲线各自最高点相比。图里 Rubin 与 GB200 的并行配置并非一律相同,因此结果代表平台与软件配置共同形成的服务能力,不能把全部增益归因于单一内核或 locality domain。
另一个结果来自 MLPerf Inference v6.1:以 Qwen3-VL-235B-A22B 为 VLM 工作负载,vLLM 作为后端、Dynamo 作为前端路由,Rubin 相对 GB300 NVL72 在 offline、server、interactive 场景中最高达到 3.7 倍吞吐。这里的模型、测试协议和比较硬件都与 AgentX 不同,不应把两组倍率合并成一个“通用提升”。
接下来值得跟踪什么
这份预览呈现了三个层次的进展:兼容内核提供可用性,面向硬件的内核发挥新增能力,数据与计算位置协同减少内部访问成本。对 Agent 服务,真正有用的是在既定交互目标下多承载多少工作,以及这一能力在模型、上下文和路由分布变化时是否保留。
原文仍把 locality domain 的完整启用、更多 MoE 与注意力内核,以及算子间重叠列为后续工作;不宜把路线图当成已经交付的能力。后续最值得比较的是完整通信计入后的收益、非均衡专家负载、不同精度配置,以及固定延迟目标下的持续吞吐。现有数字足以说明值得继续跟踪,但没有给出可直接换算的单位成本或能耗结论。