本期看点
优先读 E4 和持久记忆实证研究。 前者把运维 Agent 的分析限定为可检查、可重用的数据流,探索如何兼顾诊断范围与执行成本;后者拆开“多 Agent 降低单次上下文”和“跨问题记忆提高准确率”两个主张,说明系统能运行、消融开关存在,都不足以证明一个组件有效。
其余四篇从状态管理补上系统侧视角:TRANSIT 借主机内存减少训练所需 GPU,FailBench 比较容错机制的日常开销与恢复代价,Lachesis 用上下文寿命减少闪存写入,NeMo-DCR 则让权重增量同步保持逐位一致。这些工作衡量的目标并不相同:单卡效率、完成时间、介质寿命与同步延迟,需要分别理解。另附 FBTriton 长文,讨论推荐系统稀疏算子的执行方式为何比简单换一种编程语言更重要。
01 · E4:把根因分析组织成可检查的数据流
Agentic RCA for Internet-Scale Services Using Constrained Creativity
Sayan Sinha, Vipul Harsh, B. Aditya Prakash, Vyas Sekar, Hui Zhang · 2026-10-06
诊断的自由度应放在哪里
线上故障的证据分散在指标、事件、调用链和用户群体中。让通用 Agent 随意写脚本,能探索新假设,却也可能反复读大量数据、产生难检查的分析;固定 playbook 更容易解释,但遇到新故障就可能没有合适路径。E4 在两者之间加入一层有类型的 DSL:LLM 选择并连接分析算子,执行器处理数据,输出排序后的根因线索。
它限制的是程序结构,而非永远固定诊断算法。算子分为候选生成、打分和汇总,例如找异常用户群、比较历史窗口、结合服务依赖降低传播症状的权重。无环数据流让每条线索都有可追踪的分析过程,也让多个分支共享中间结果。这是 harness 与执行层的设计,不是训练一个新的基础模型。
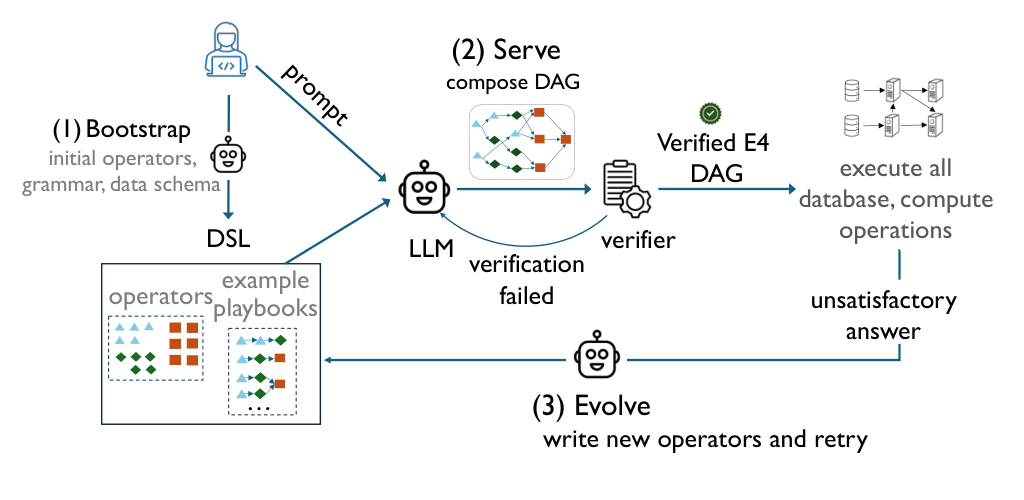
读图:左侧建立算子与示例库,中间生成并验证 DAG,右侧执行分析;结果不满意时,下方扩展算子,再进入诊断循环。
从已有方案逐步扩大搜索空间
部署时,系统读取遥测 schema、任务描述和示例,用合成数据检查初始 playbook。每次事故先选择已有方案;失败后用现有算子组合新 DAG;仍不足时,才让编码 Agent 提议新算子。新增算子只有帮助定位真实根因、经用户反馈确认后才长期保留,因此“自动演化”仍有人工判断边界。
执行前,验证器检查算子是否存在、输入输出类型是否相容、图中有无环,以及最终是否只有一个答案。Ray 执行独立分支并缓存中间结果。完整遥测由本地算子处理,LLM 主要看到事件描述、schema 与算子目录,减少反复把原始数据塞进上下文的成本。但类型正确、图可执行,只保证分析程序符合约束,并不证明它找到了因果根源。
数字如何影响阅读判断
作者使用同一 Gemini-3.1-Pro 比较 E4、直接分析遥测的 LLM、RCA-Agent 和 Terminus-2,覆盖扩展的 DeathStarBench、三个 OpenRCA 部署与 ORCA-bench。在 DSB 上,E4 对最强基线的提升是 34.7 个百分点,即相对提高 62%。这里的 Accuracy@3,3 允许最多三次尝试,每次检查前三条线索;不能理解成一次回答的准确率。ORCA-bench 则使用 Recall@5,3,衡量多根因召回,不能与前者混作同一指标。
总分析成本包含推理与系统成本,相对每个数据集最便宜的基线,平均降低 5.4 倍,DSB 最高 12.1 倍。生产试点仅六起事故,五起找对用户群,其中两起需要分析师提示。原型在单台 M3 Pro 笔记本运行,这些证据支持受约束分析的可行性,尚不能据此宣布互联网规模的无人工闭环。
阅读判断:值得精读的运维 Agent 系统设计。 优先看算子组合、验证与准入机制,再看分阶段实验。最有价值的变化是把探索转成可重复执行的分析资产;适用范围仍取决于遥测质量、算子覆盖和反馈质量,减少 token 也没有消除这些工程工作。
02 · 持久记忆:分解任务省缓存,记住过去是否有效仍待检验
Persistent Memory in Multi-Agent LLM Inference: What It Costs, What It Buys, and When You Can Tell
Hochan Son, Kyungdoe Han, Jaehan Koh, Xiaowu Dai, Wenlu Xu, Guang Cheng · 2026-10-06
先把两种“记忆收益”分开
多 Agent 可以把长任务拆成若干短调用,每个 Agent 只接收相关证据和前序摘要,从而降低单次调用的 KV 峰值。另一个常见设计是把推理轨迹存下来,供后续问题检索。两者常被放在同一系统里,但一个解决工作集大小,另一个主张历史经验能改善答案,不能用同一组总分证明。
论文研究三层结构:L1 是短暂的调用级 KV,L2 用 Redis 传递结构化 Communication Units,L3 用 Qdrant 做证据过滤及轨迹持久化。完整系统 COA-PKV 与对照 COA-NOKV 只差轨迹读取、写入两项操作,证据检索和 Agent 流程保持一致。因此,它研究的是特定系统中的持久轨迹,而不是否定所有检索增强或长期记忆。
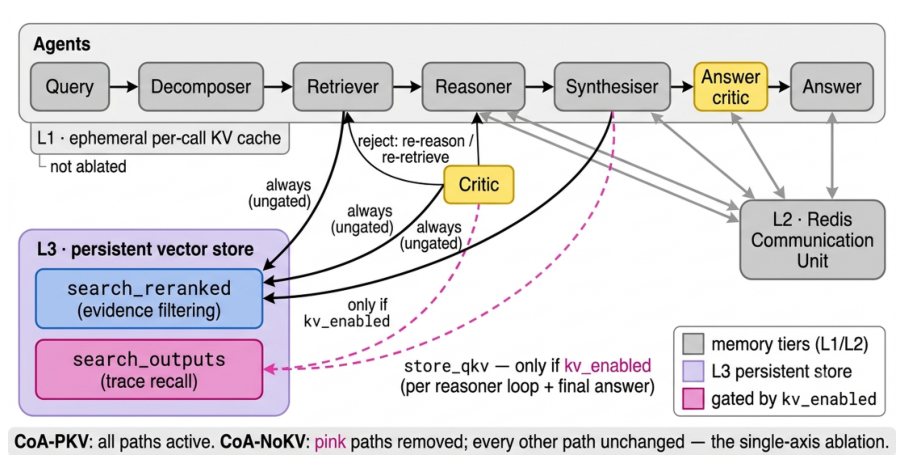
读图:上方是问题分解到答案的调用链;黑线证据检索始终保留,粉色路径才是消融对象,右侧 L2 继续传递 Agent 间状态。
峰值更小,累计工作仍可能更多
在 HotpotQA 与 LB-HotpotQA 两个条件、每个条件每组 100 个问题上,作者报告 COA-PKV 的平均每问题峰值 KV 为 14.3 MiB,单次回答与检索匹配的 RAG 分别为 35.5、35.3 MiB。代价是累计 KV 流量约增加到 1.6 倍,更多调用把工作分散开,并未让所有成本同时下降。
这些数值按 token 数及所用 Qwen3.5-35B-A3B-FP8 的 10,240 B/token 换算,不是显存占用实测。系统还使用 Jetson 上的较小模型;统一换算会高估小模型调用的 KV,而线性注意力层状态、权重和分页开销未计入。所以它支持“单次 KV 工作集更小”,不支持直接推算并发能力提高相同倍数。
没检测到收益,说明测试条件出了什么问题
八个数据集配对中,开启持久记忆增加峰值 KV 0.368 MiB,95% 置信区间为 [0.167, 0.590];准确率变化为 +0.015,区间 [−0.011, +0.046],尚不能从噪声中分辨收益。每组目标规模为 100 题,实际有效配对随失败记录而异。失败计零与剔除失败题的处理,也会把总效果从 +0.015 改成 +0.003。
原因与基准结构有关:独立问题各自携带证据;为防止重复运行检索到自己的旧答案,又必须清除历史轨迹。清除后,能召回的主要是本轮其他无关题,原请求口径下只有 24% 的问题满足召回条件。真正检验跨会话记忆,需要任务之间确有可复用信息,同时避免答案污染。
作者还追查了四类测量问题:组件没有真正执行、历史轨迹污染、消融同时改变其他执行条件,以及重复实验不足。修正后仍保留运行顺序混杂和少量重复的限制。这是一项值得读实验与附录的实证研究: 它推进的是如何判断系统组件是否生效,而不是给持久记忆下无效结论;下一步应在共享状态的多会话场景验证。
03 · TRANSIT:用主机内存降低训练的 GPU 门槛
TRANSIT: Transparent Scale-in for Multi-Node LLM Training
Hyungyo Kim, Nicholas Satchanov, Hrishi Shah, Gaohan Ye, Jiaqi Lou, Robert Walkup, Shweta Salaria, I-Hsin Chung, Hubertus Franke, Seetharami Seelam, Apoorve Mohan, Nam Sung Kim · 2026-10-06
显存不足常迫使训练扩到更多节点,通信也随之增加。TRANSIT 在用户态拦截 CUDA 分配,以 UVM 承接内存,再用预取与零拷贝策略减少缺页和来回迁移;无需改写训练应用,但依赖相应 CUDA/UVM 路径。
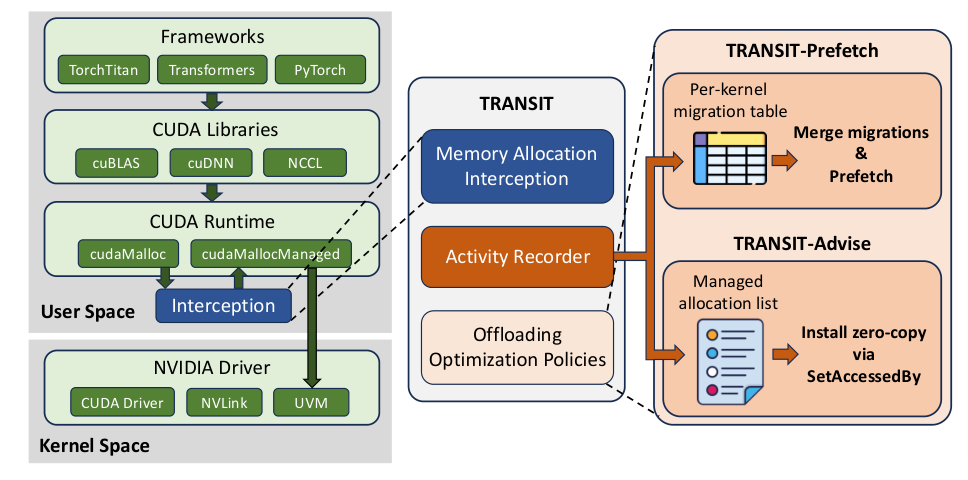
读图:中间记录分配与执行活动,右上合并迁移并预取,右下让 GPU 直接访问主机驻留数据。
在 Cluster-B 的 Llama3-70B、16 张 H100 实验中,最佳变体为每卡 433 TFLOPS,TorchTitan-Offload 为 258;不卸载的 24 卡基线为 418。这里比较的是每卡效率,不能读成减少 GPU 后总吞吐不变。卸载数据量、PCIe 与网络配置共同影响收益;运行阶段的识别还采用热身后的内核计数启发式。值得读其零拷贝与预取对照,集群级排队改善则属于轨迹模拟。
04 · FailBench:恢复快,不等于整个训练更快
FailBench: Evaluating Fault Tolerance Across Distributed Training Architectures
Khaled Aljbab, Amine Barrak · 2026-10-06
FailBench 在两节点、8 张 V100 上组织七类训练架构与容错机制比较,覆盖单次、并发及级联的 fail-stop 故障。它最实用的提醒是:恢复状态的耗时、重新建立通信的耗时和正常训练开销,需要分别衡量。
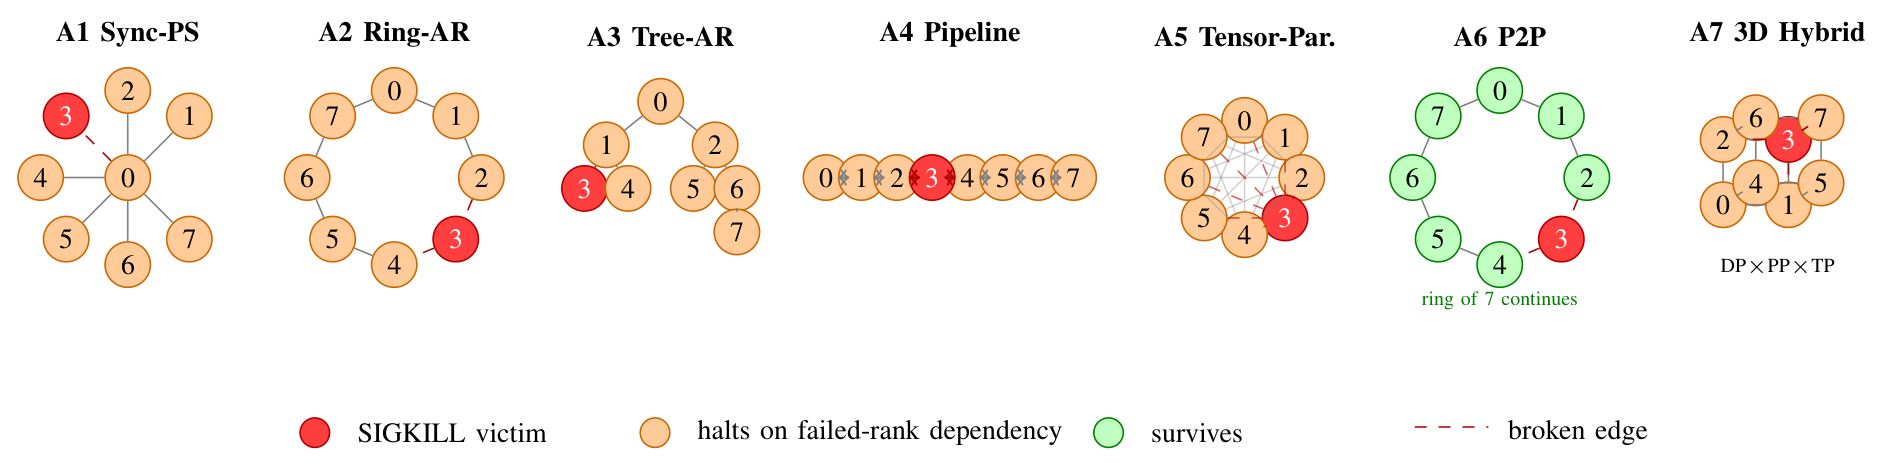
读图:红色 rank 被终止,橙色节点因依赖失败而停止,绿色 gossip 节点继续;图展示的是测试配置下的故障传播。
在 Ring All-Reduce、ResNet-50、约 205 MB/rank、每 100 步保存一次的条件下,磁盘与内存复制开销分别为 0.48% 和 3.78%,约 155 ms 与 17 ms 的恢复值是分析下界。会停机的架构没有完成端到端进程组选举与重建,不能称为 17 ms 恢复训练。gossip 丢失一个 worker 后样本吞吐增加 17.9%,却未检测到更快的 loss 进展。优先读实验口径和适用矩阵:工作负载含 ResNet 与 MLP 代理,绝对值不能直接外推完整大模型训练。
05 · Lachesis:按上下文寿命分配 HBM 与闪存
Lachesis: Lifetime-Aware KV Cache Placement for Agent Serving across HBM and High-Bandwidth Flash
Jaehoon Yang, Jeongmin Lee, Haneul Park, Seung Yul Lee, Nam Sung Kim, Jae W. Lee · 2026-10-06
高带宽闪存 HBF 的容量可缓解 KV 压力,但在线写入会消耗介质寿命。Lachesis 让 harness 暴露上下文片段的结束边界:短命推理片段优先留 HBM,长期主 Agent 状态进 HBF;worker 再按生成时元数据预测寿命排序,片段结束即释放。
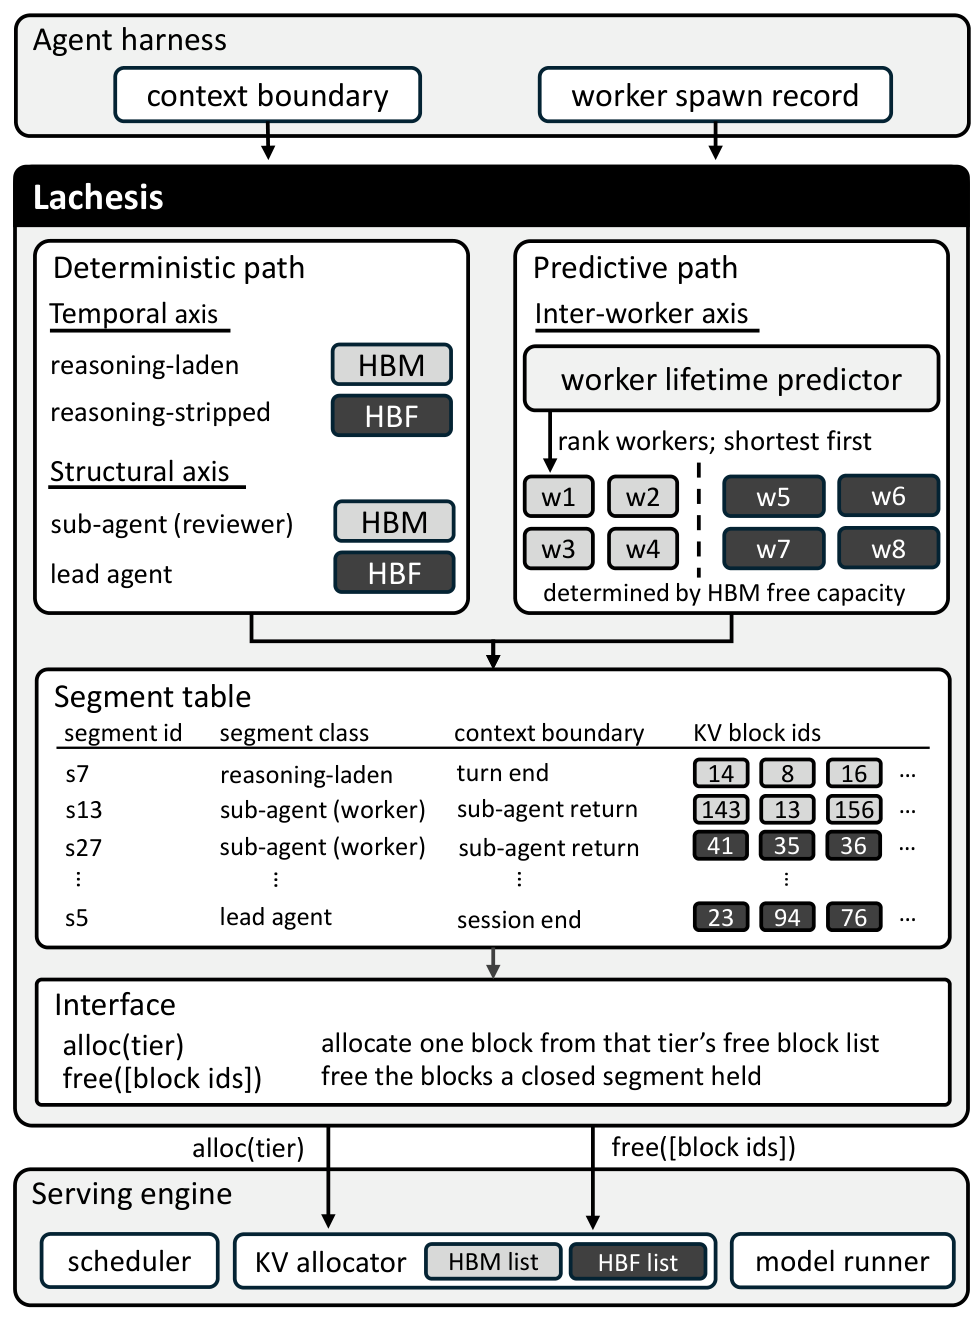
读图:左侧按片段类别决定层级,右侧优先让预计短命的 worker 占用 HBM,中间片段表把生命周期连接到分配与释放。
作者在真实 Agent 轨迹驱动的模拟中,对 Llama-4-Maverick 与 Qwen3-235B-A22B 回放,设置 TTFT 2 秒及 p99 TPOT 60/100 ms。四种共置内存配置的多 Agent 结果中,紧 SLO 下寿命相对 HBM-first 增加 1.50–2.95 倍。结论依赖 100,000 次擦写、写放大 1.02 和用户/工具延迟模型,不是 HBF 实机寿命测试。值得关注的是编排语义如何指导存储,而非把所有慢层缓存都视为相同设备。
06 · NeMo-DCR:同步变化的位,并保证失败后可重试
NeMo-DCR: Bit-Exact Delta-Compressed Refit for Scalable Agentic RL at Trillion-Parameter Scale
Songlin Jiang, Zhiyu Li, Terry Kong, Yu Yao, Youngeun Kwon, Bernard Nguyen, Ashwath Aithal, Mario Di Francesco · 2026-10-06
Agentic RL 分离训练与 rollout 后,每次更新都要同步策略。NeMo-DCR 比较训练分片与基线,把变化映射到标准检查点坐标,由服务端原生 loader 决定落位;保位路径用 XOR,其余覆盖写,失败重试改用覆盖写,所有接收端确认后共同提交版本与基线。
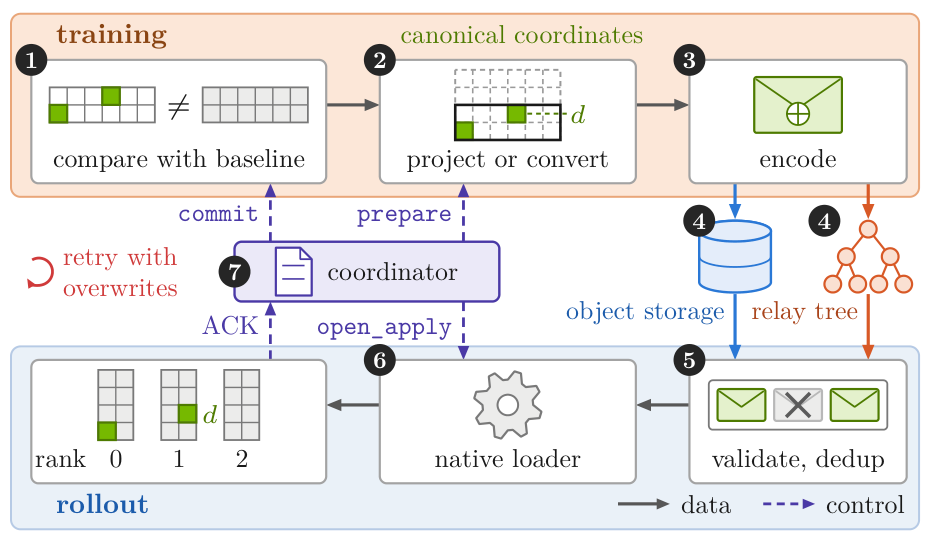
读图:上方找变化并编码,经对象存储或中继树传递;下方验证去重、原地加载,协调器用确认与提交绑定新版本。
作者在跨 AWS 区域测试中,1T 规模、人工注入 3% 元素变化的中继树同步为 150 秒,完整检查点纯传输参考为 87.5 分钟;1T 检查点由 550B 模型扩层构造。这是权重同步实验,非万亿模型完整 RL 训练加速。另有 Qwen3-30B-A3B、50 步 GRPO、五次重复及接收端终止测试。逐位一致与重试协议值得读,收益仍依赖变化稀疏度,并需训练侧约一份检查点大小的主机基线内存。
社区观察:通用榜单之外的运维评测
Franco Naumow 的原帖指出,10 月 5 日快照中 Claude Opus 5.5 (Max) 的 Artificial Analysis Intelligence Index 为 57.6、排名第一,但在 ITBench-AA 的 21 个当前模型中排名第 12,得分 38.2%。帖文描述的任务包含 59 个 Kubernetes 事故快照,漏掉任一根因实体即该题零分。
这是已核对原帖的榜单观察,数字按发帖者所述,未独立复算官方榜单;不代表模型能力的普遍排名。它与 E4 的联系是任务口径:通用能力分数不能代替指定诊断任务的实测,完整实体定位也不同于前三条线索中的命中。
同批技术长文
FBTriton:按稀疏访问形态组织嵌入训练解释 Table Batched Embedding 的前后向、长短 run 分工及同步正确性。