本期看点
值得优先读的是 KV 驻留分析与 SchemaShield-Lite。前者把 Agent 的资源问题从一次请求延伸到完整会话:模型不执行时,显存仍可能被长期保留的上下文占据;后者则问工具描述、字段和候选集合发生变化后,原本会调用工具的模型为何失效,以及验证反馈能修回多少。这两项工作分别给出生产轨迹和受控实验,让性能与可靠性的讨论有了更具体的对象。
其余三篇补充不同层面的证据:BaGuaLu-2 针对 MoE 训练的激活内存波动,光网络演示把诊断陈述连接到真实数据片段,MLOps-Bench 检查代码修改能否同时满足新行为和既有契约。它们的成熟度不同,不能把万卡吞吐、原型展示和合成任务成绩放在同一种“已验证落地”尺度上。
01 · KV 驻留:会话还活着,缓存就该一直留着吗
Understanding KV Residency in Production-Scale Agentic LLM Workloads
Mayank Arya, Agrim Bari, Anjaly Parayil, Yogesh Simmhan, Renee St. Amant, Victor Rühle, Saravan Rajmohan · arXiv v1 · 2026-10-16
从请求速度转向状态的寿命
Agent 调用工具后,常带着更长上下文重新进入模型。前缀缓存能省去重复 prefill,但工具执行和用户停顿期间,保留 KV 仍占显存。论文分析 Microsoft M365 的四类生产负载,合计超过 1.21 亿次模型调用;Coding Agent 的记录粒度主要是事件,作者将它与逐调用轨迹区分,未纳入字节容量和放置分析。数据采集窗口在 2026 年 6 月下旬至 8 月初。
Deep Research 中,89.3% 的调用由应用内部发起,约 80.3% 的上下文 token 命中前缀缓存。研究价值在于同时观察会话、上下文和服务部署位置,使“缓存有多大、要留多久、下一次能否找到”进入同一分析。
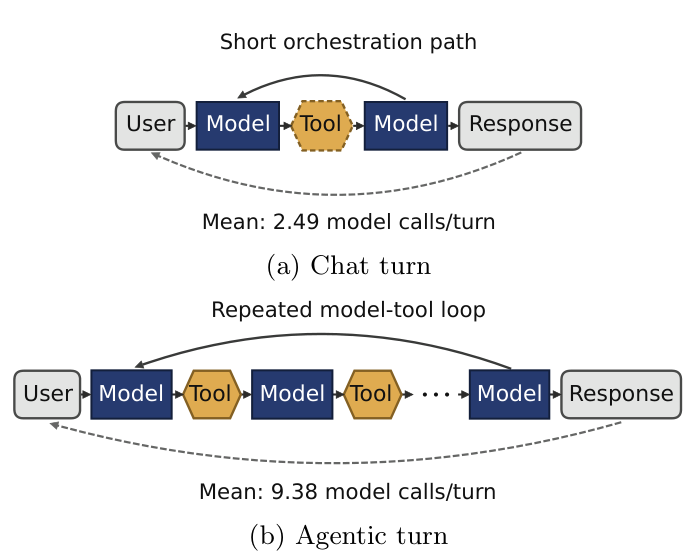
读图:上方聊天路径较短,下方 Agent 在返回用户前反复调用模型与工具。图中均值按用户轮次统计,不能当作会话深度。
留多久、留什么、留在哪里
为了不披露生产模型细节,作者统一用 Llama-2-70B 的 FP16 GQA 布局换算,每 token 为 327,680 字节。假定所有活跃会话从首到末次调用一直保留各自生命周期峰值,Deep Research 的全轨迹峰值为 501.8 TB。这是偏保守的容量上界估计,排除了权重等内存,并非线上实际占用。
给空闲会话加一小时上限后,估计上界降至 140.8 TB,重放中的重算调用占比从 4.07% 升至 4.53%。长尾停顿占住大量容量,却只有较少调用需要重新加载;但把上限缩至一分钟,重算率升至 14.1%,会伤及工具循环中的短暂停顿。
容量紧张时,论文按时间顺序重放最忙一小时的 176,007 次调用,将每个会话当前 KV 看作可变大小对象。预算设为该小时无驱逐峰值 47.0 TB 的 10%,即 4.7 TB:LRU 的重算率为 62.9%,知道未来访问的 FNU 为 31.1%。MRR 按 LRU 顺序将状态降为四分之一大小的 int4 副本,仍计入同一显存预算,返回时提升表示,重算率降至 13.6%。它主要增加可保留容量;FNU 对可变大小对象也不是严格最优界。
另一个瓶颈是位置。同模型调用留在同一部署时,平均复用为 88.9%,跨同区域部署后为 29.0%;这是关联观察。将重放对象从“会话”改为“会话加部署”,即使无限内存,首次访问造成的重算下限也从 5.4% 升到 20.2%。因此,多加内存不能单独解决路由造成的状态不可达。
值得继续验证的部分
优先读容量重放和放置分析。 MRR 没有计入提升、反量化与传输时延,也未验证这些生产会话的回答质量;int4 再转回 FP16 并不会恢复丢失精度。加入量化元数据后,重算率变为 14.99%–19.25%。预算还被理想化为跨副本共享池。论文支持继续研究分层保留和亲和路由,但尚未证明端到端加速。生产轨迹不能公开,AgenticTraceSim 在论文中仍是计划发布。
02 · SchemaShield-Lite:接口变化后,用验证反馈修复工具调用
Robust Function Calling for LLM Agents Under Interface Drift
Aniruddha Chattopadhyay, Kanishka Halder, Partha Sarathi Roy · arXiv v1 · 2026-10-16
工具语义没变,接口仍可能把模型带偏
工具升级会改参数名、留下旧例子,也会把描述相近的新工具加入列表。模型看到的文字变了,底层操作却可能没变。SchemaShield-Lite 研究这种接口漂移,目标是给现有模型加运行时修复层,而非重新训练。实验扰动由作者设计,不能视为真实 API 变更的完整分布。
输入是用户上下文与变动后的可见工具;模型先生成调用,验证器检查工具名、必填字段及参数结构。合法输出直接通过,失败则把原调用、结构化错误和工具说明送回模型,要求受约束修复。如果连工具名都没给出,先在可见候选中重试选择,再针对选中的工具修复。因此“一次修复”在缺名场景可能多出一次候选重试。
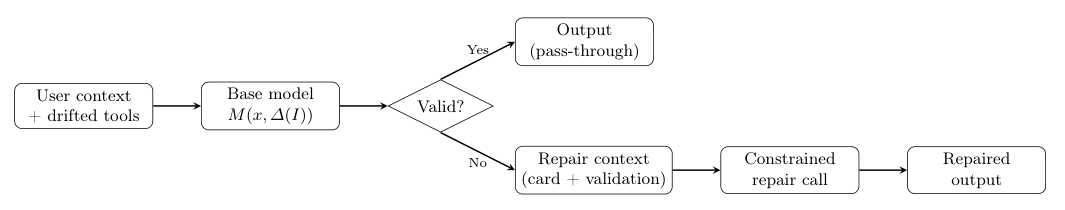
读图:有效调用沿上支路直接输出;无效调用进入下方反馈修复。缺失工具名时还需先从可见工具中解析目标,图中未单独展开这一步。
提升来自反馈,也付出额外调用成本
主要证据采用不向修复器透露标准答案工具的 non-oracle 协议。Qwen3.5-9B 在 DICE 的 300 个单函数首轮对话样本上使用轻度扰动、一个干扰工具;BFCL 的 200 个样本均分四类,采用中度扰动、三个干扰工具,温度均为 0。
| 主实验 | 原始接口 | 漂移后 | 修复后 | 原先正确样本中的漂移失败恢复 |
|---|---|---|---|---|
| DICE-300 | 75.7% | 71.7% | 81.3% | 19/22 |
| BFCL-200 | 79.0% | 58.0% | 80.5% | 33/45 |
修复后超过原始成绩,部分原因是顺手修好了基线已有错误;不能把全部提升都算成抗漂移收益。独立基线运行中,普通重试仅达 72.7% 与 61.0%,对应结构化修复为 81.3% 与 79.5%;这些是另一组运行,不能把 BFCL 的两个修复数字混用。主实验修复触发率为 16% 与 32%,额外 token 分别为漂移调用 token 的 32.6% 与 47.1%。
消融中,DICE 的候选集合扩张比仅改描述或参数名造成更大损伤。工程上值得监控工具目录增长带来的混淆,而不是只统计 schema 是否变化。不过,一部分机制消融使用已知目标工具的 oracle 设置,只能作为上界参照。
验证器看得见什么,决定它能修什么
合法但语义错误的参数可能绕过检查。主要样本中未观察到修复破坏原先正确子集,并不构成安全保证。跨模型结果也不均匀:Llama-4-Scout 在 BFCL 的准确率仅从 63.5% 到 66.5%,缺工具名让大量目标无法解析。另一轮带时延仪表的 BFCL 重跑中,27% 的触发率对应平均每例约 3.5 秒额外时延,不能直接配到主表的 32% 上。
这是值得精读的受控可靠性研究。 最有用的是验证、候选解析与修复之间的关系;尚待检验的是更广的模型、真实变更分布、复杂多工具重构和时延预算。它也不认证工具来源,修复层不能代替对新增工具的信任检查。
03 · BaGuaLu-2:跟着 MoE 路由波动调整激活显存
BaGuaLu-2: Taming Dynamic Memory Fluctuation for Efficient MoE Model Training over 10,000 GPUs
Mingshu Zhai, Minkun Guo, Hongrui Lian, Shuangyu Li, Qi Zhang, Chen Hu, Xiawei Du, Yuyang Jin, Zan Zong, Jidong Zhai · arXiv v1 · 2026-10-16
MoE 路由倾斜使激活显存随微批次变化。BaGuaLu-2 在流水线调度点估算内存需求,按算子选择重算、卸载或量化,再交叠相邻前向与反向微批次,隐藏缓解内存压力的开销。
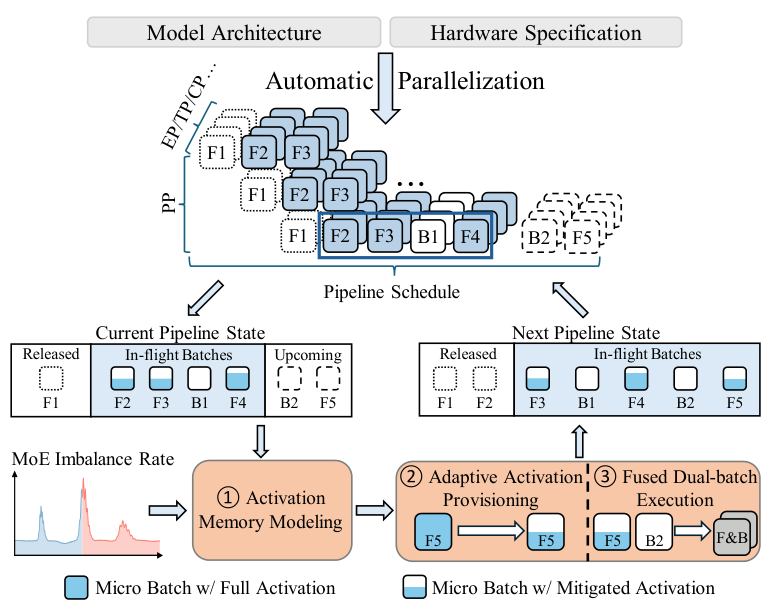
读图:当前流水线状态和专家失衡进入内存模型,随后调整激活保留方式,再用交叠执行推进下一状态。
作者在每卡 64 GB HBM、BF16 峰值 480 TFLOPS 的厂商 GPU 上,报告 12,288 卡达到 2.012 EFLOPs;跨配置平均比 Megatron-Kuai、AdaPipe 快 1.14×、1.13×。这些基线经过 MoE 适配或组件裁剪,统计含 OOM 重启的机器预热,不含人工处置时间。双批次执行要求流水线并行度大于二,评测均至少为四。最大规模 MFU 的摘要与图示取整不一致,因此不以该百分比作结论。适合关注大规模训练内存调度,迁移仍依赖硬件代价模型与配置。
04 · 光网络诊断:用数据引用约束展示的证据
Preventing Data Hallucinations in Agentic AI for Optical Network Troubleshooting
Jeremias Dötterl, Martin Kuipers · arXiv v1 · 2026-10-16
这份面向 ECOC Demo Zone 的演示稿让工具返回 URI 数据引用,定位时序窗口、日志行或 JSON 片段。Agent 在诊断中引用这些位置,后端再从原始遥测提取内容并渲染,避免让模型重新抄写数值。
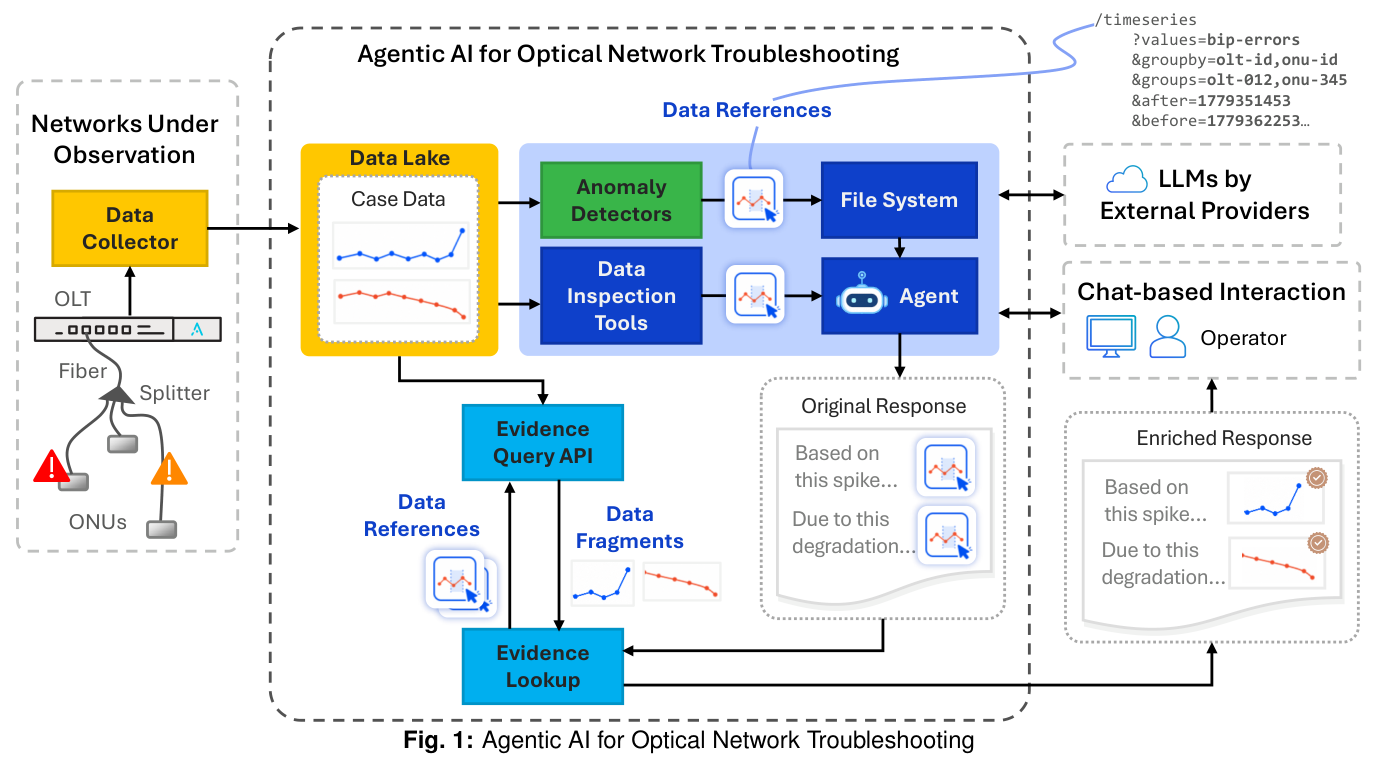
读图:检测器和检查工具给出数据引用,Agent 组织解释;下方查询与回填模块把引用替换为真实片段,再交给操作者。
原文描述 Adtran 实验室商业 OLT/ONU 设备及断纤、断电演示,使用 deepagents 实现,但没有给出样本规模、根因准确率或对照改善数字。引用不存在时可警告;引用存在也不保证因果推理正确,更不能证明遥测未被投毒。值得关注的是证据接口与展示约束,证据程度属于原型展示,不能理解为消除了所有诊断幻觉。
05 · MLOps-Bench:把生产 ML 行为契约变成可执行测试
MLOps-Bench: Benchmarking AI Agents on Production ML Engineering in Real Repositories
Quoc Co Tran, Hitesh Laxmichand Patel, Diwakar Mahajan, Kshitij Bakliwal, Avi Sil, Katrin Kirchhoff · arXiv v1 · 2026-10-16
MLOps-Bench 从真实仓库代码和配置合成任务,覆盖数据、特征、训练、服务、监控、治理及跨阶段集成。每题提供参考补丁、貌似合理但错误的补丁,以及新行为与回归测试。总计 31 个仓库、212 题,其中 25 题用于开发,报告评测使用剩余 29 个仓库的 187 题。
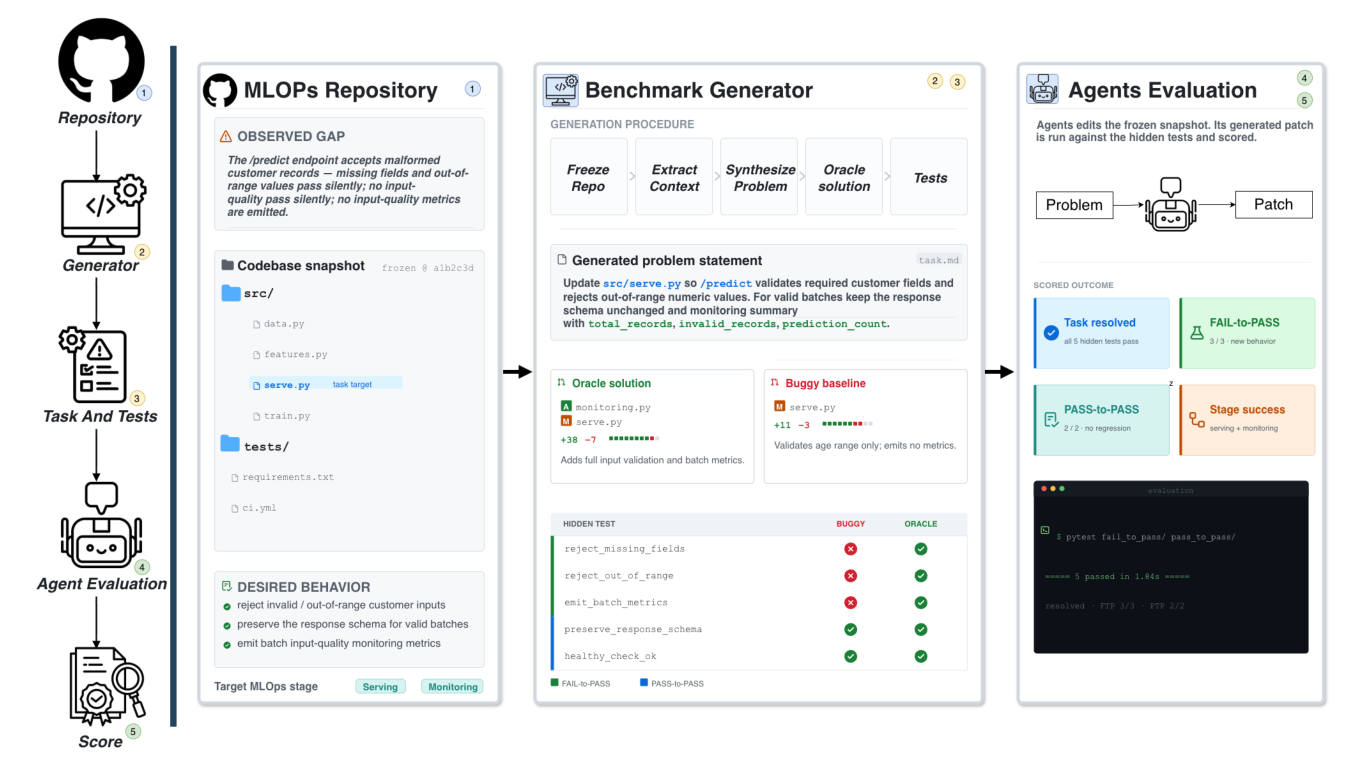
读图:左侧冻结仓库和行为缺口,中间构造需求、正确与错误补丁及测试,右侧只给被测 Agent 任务和工作区,再用隐藏测试评分。
六种 Agent 配置中,作者报告最佳 Codex/GPT-5.5 完成率 31.2%、测试通过率 68.7%,提示“部分实现”距离满足完整契约仍很远。它不是 212 起真实生产事故:任务与测试经模型辅助构造,有限测试不能代表所有运行风险,交互式编码系统与基础封装的比较也包含工作流差异。适合跟踪生产 ML 行为评测,不能据此推算工业部署成功率。
两则社区动态
CNCF 提醒关注遥测投毒。 10 月 16 日原帖推广 KubeCon + CloudNativeCon North America 2026 的零信任遥测议题。官方议程列出 Chad M. Crowell 与 Diana Todea,涉及采集链路认证、查询权限和防篡改。这是议题预告,不是已发布的攻击成功率报告。
Push/Pull 的区别在准备工作的时机。 Navaneeth Krishnan 的原帖回顾 vLLM 10 月 14 日文章:Push 提前准备 decode 内存,并把传输设置移到 prefill 后台线程。作者在 Qwen3-32B、P5en/EFA、1P1D、关闭 decode 前缀缓存、输出 128 token 的实验中,报告 8 QPS、16K 输入下 TTFT 约从 1,744 ms 降至 540 ms。短输入低负载差异很小;提前确定 decode 节点也牺牲了部分后置路由灵活性。