本期几项工作把 Agent 的可靠性问题落到了可检查的系统边界上。BASIN 解释短暂流量峰值如何经由会话与缓存反馈留下持久故障;DistDebug-Bench 则显示,找到相关代码仍不足以完成可信诊断。小模型 RCA 工作进一步追问:模型已经分析过传播关系,为何最终仍会选错组件?
Exo 与 RTP-LLM 分别讨论运行策略变化和模型接入变化时,哪些状态与权限应由稳定机制管理。网页抓取测量提醒我们,成功状态码也不保证拿到正文。它们共同值得关注的,是把性能或能力结果连接到状态生命周期、证据质量与失败边界。
Exo:修改运行中的 harness,保留独立的状态与替换权限
Exo: An Architecture for Self-Improving Systems at Runtime
Alexander Krentsel, Sylvia Ratnasamy, Ion Stoica, Martin Casado, Ankur Goyal · arXiv · 首次提交:2026-10-30
Agent 在一次长任务中已经发现重复操作,却仍要等外部优化器收集样本、评估新版本,改进才能落地。Exo 把改进循环放进执行过程:运行中的 agent 可以读写自己的工具、上下文压缩、模型调用及改进策略,再请求启用新 executor。它关注的是任务继续运行时如何替换策略,而非仅积累经验文本。
架构将可编辑策略与受保护机制分开。历史只追加,产物保留旧版本,guardian 独立决定新 executor 能否启用;替换时保留任务环境和执行记录。成本、token 与缓存信息帮助 agent 判断哪些操作值得改写。SREGym 中,它逐步形成收集异常 pod、版本变化和可疑日志的 incident-snapshot 工具,减少重复诊断调用。
使用 gpt-5.6-sol、以同一起始策略但禁用自编辑为对照,在 21 个学习事故之后,20 个同类故障、不同应用的留出事故中,作者报告诊断时间中位数从 81 秒降到 53 秒,平均模型成本从 0.892 美元降至 0.584 美元,正确性相近。保护边界的含义要谨慎理解:默认 guardian 只检查构建成功,不保证修改正确或性能改善;回滚也不能撤销外部副作用。对 AgentOps 而言,值得借鉴的是把“提出修改”与“批准生效”分成不同权限。
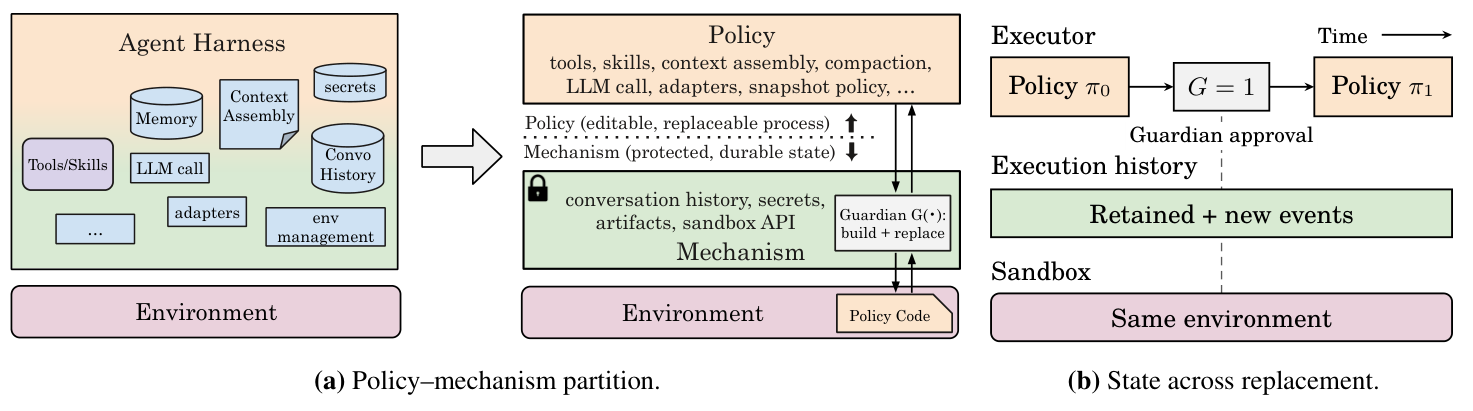
策略可以改变工具与上下文组织;历史存储和新策略的启用检查位于独立边界之下。
BASIN:流量恢复后,为什么推理服务仍困在缓存抖动中
When Cache Pressure Becomes a Trap: Metastability in Agent Serving
Chengzhi Lu, Boxi Zhou, Yanying Lin, Dmitrii Ustiugov · arXiv · 首次提交:2026-11-02
峰值流量消失,并不意味着服务会自行恢复。 这篇工作把 agent serving 的缓存压力与亚稳态故障联系起来:系统在原本能承受的流量下持续恶化,原因是请求变慢改变了仍在运行的会话数量,而会话数量又决定缓存需求。
Agent 会在模型调用与工具执行之间反复切换,下一轮往往复用不断增长的历史。一次调用变慢,会话就更晚结束;新会话持续进入,使所有活跃会话的上下文总量扩大。前缀被逐出后,下次调用必须重新 prefill,进一步延长会话寿命。工具正在执行的会话也占据未来复用需求,因此只看当前 decode 的 KV 使用率会漏掉压力。SGLang 预先为等待 prefill 的请求保留 decode KV,还可能加剧等待。
作者在两张 H100 NVL、1P1D 的 SGLang 上运行 Qwen3.6-35B-A3B FP8,回放 216 条 Terminal-Bench 轨迹、7,108 次调用。基础到达率为每分钟 3.3 个会话时,十分钟的翻倍流量使前缀命中率从约 0.95 降至 0.27。随后一小时新到达会话的 goodput 从每小时 138 降至 17,约下降 88%。这里 goodput 要求会话减速比不超过 4,且至少 95% 的 decode 步满足 50 毫秒 ITL 目标;它不同于完成调用数。终止残留突发会话后恢复的干预实验,为反馈机制提供了比相关曲线更强的证据。
BASIN 据此联合控制三个环节。首先,用到达时间和预计峰值上下文确定固定会话优先级,让准入、prefill 与 decode 队列遵循同一顺序。其次,借用空闲 decode 内存保留跨轮次状态,真正执行 decode 时优先收回。最后,按会话预计峰值工作集限制新会话进入,根据命中率调整预算;只有长期需求超过容量时才丢弃部分排队会话。这样既保护已进入的上下文,也减少把所有代价转移到入口长队的风险。
证据必须分层看:真实 H200 1P3D 原型使用到达时间排序和当前上下文准入,四个场景下 goodput 是 Continuum 的 1.20–1.70 倍;完整预测式策略的更广泛比较来自校准模拟。流体模型标记出全部 17 个缓存先受限的模拟部署,也误报了 8 个 decode 先受限部署,不能称为完美分类器。
这项工作的价值是把过载保护单位从单次请求提升到跨工具调用的会话工作集。其收益取决于瓶颈:decode 已先饱和时,借缓存空间的改善有限;缓存很大时,准入仍可能放进过多 decode 并发。阅读重点是故障干预、会话生命周期和 goodput 定义,而非只看加速倍数。
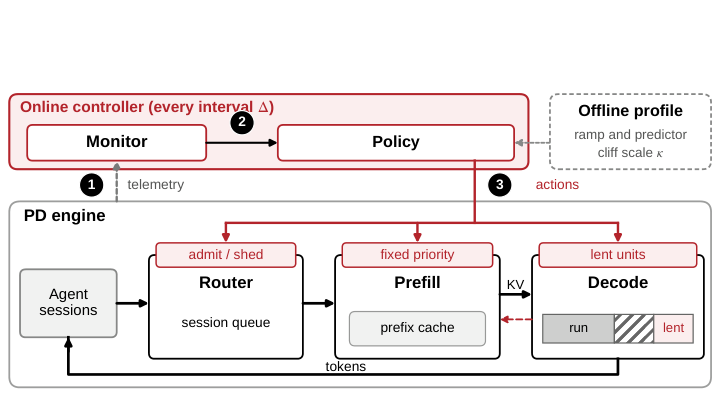
控制器同时管理新会话进入、已有会话的服务顺序和可借用缓存,避免只扩容或只限流。
DistDebug-Bench:找到相关文件,离找到故障原因还有多远
DistDebug-Bench: Can LLM Agents Diagnose Bugs in Distributed Systems?
Yuxuan Jiang, Chenglin Liu, John Rose, Mason Miller, Ruthesh Thavamani, Juntao Wu, Yinwei Huang, Jiahao Xu, Peng Huang · arXiv · 首次提交:2026-11-02
诊断一个分布式系统故障,需要解释症状如何从因果代码产生。 找到报错文件或者生成能通过测试的补丁,都不完全等价于这项能力。DistDebug-Bench 将任务落在这个缺口上:给 agent 修复前仓库、事故描述及已有日志等材料,要求指出承载故障机制的代码块,直接评估定位。
基准含 11 个生产级系统、5 种语言的 120 个历史故障,标注 218 个根因代码块。每例由三名标注者独立检查后协调,排除测试、顺手重构和与根因无关的防御性修改。45% 的事故需要多个代码块,约 23% 跨文件,代码块中位长度仅五行。这要求 agent 既能沿跨组件因果链探索,也能收敛到精确范围。
数据还保留了真实诊断证据的不均衡:83 个报告不直接包含正确方法名,75 个没有可用的项目内栈轨迹。环境移除未来提交并禁止联网,另检查推理与工具记录中是否泄露隐藏 issue 编号。这样的控制减少直接查答案,但作者明确无法排除预训练暴露。样本也偏向能从已有报告诊断、修复范围可清晰标注的故障,不能代表所有线上事故。
在完整的 120 例比较中,作者每例平均三次有效尝试。GPT-6 Astra 配 Mini-SWE-Agent 的文件覆盖率为 83.9%,代码块覆盖率为 67.7%,代码块精确率为 42.7%;代码块覆盖率的 95% bootstrap 区间为 60.4%–74.9%。这些数字揭示“走到相关仓库区域”与“准确解释因果位置”之间的距离,而不是端到端修复成功率。该配置仍有 15 个故障在重复运行中的覆盖率跨度超过 0.2。
轨迹分析给出具体失败机制:一次搜索限定在错误子目录,可能使后续每一步看似合理,却始终看不到真正的原因;只读日志片段与搜索异常关键词,也会得到不同的证据范围。模型常在第一个自洽解释上继续深挖,缺少重新打开其他假设的动作。更宽泛地报告代码能提高覆盖,却会降低精确率,工具调用与上下文组织因此是评估对象的一部分。
定位标签也有边界:另一处有效干预点可能解释同一机制,却未命中最小根因块。作者的零覆盖人工审查中,20 例有 4 例属于这类情况。这不抹去困难,但提醒读者同时看解释质量与覆盖指标。对 AI SRE 研究,值得关注的是把证据获取、假设修订和最终定位拆开评估,并按报告线索强弱观察失败,而非仅比较总榜。
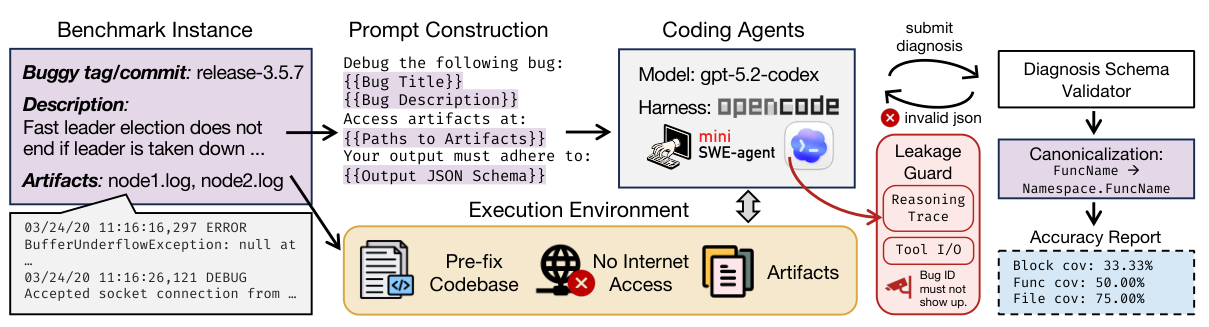
输入隐藏修复与答案线索,输出经过结构校验、符号规范化及多粒度定位评分。
小模型 RCA:补上正常行为基线,再纠正最后的决策
Fault-Free Profiles and Decision-Level Training for Root Cause Analysis via Small Language Models
Kyoohyun Lee, Woohyeok Park, Taeyoon Kim, Sungyong Baik, Kyungyong Lee · arXiv · 首次提交:2026-11-02
异常分数大,不代表更接近根因;模型写出了传播分析,也不代表最后会遵循它。 这篇小模型 RCA 工作分别检查输入与决策,发现两个经常被混在一起的问题。短时间参考窗口会把正常的周期变化当成异常,最终回答又可能忽略中间分析,转而选择分数最高的组件。
作者在 OpenRCA Bank 中发现,某 JVM 内存指标在无故障窗口里有 97% 会越过短窗口估计的阈值;改用完整无故障时期的统计量后,该比例降至 4%。根因组件在 99% 的事故窗口中已经进入候选集,却只有 8% 拥有最大异常分数。问题因此不只是“有没有找到候选”,还在于模型如何理解这些候选的背景。
Historical Frequency Profiling 为指标和日志添加 Expected Outlier Baseline:同一信号在无故障窗口里被标为异常的频率。在线提示同时展示异常强度与平时出现频率,优先列出平时少见的异常;trace 则与正常延迟比较。它不把罕见直接等同于因果,而是给模型补充原先看不到的参照。候选组件仍由指标筛选,日志与 trace 不会额外引入候选,因此前处理漏掉根因时,后续推理仍无法补救。
Biased-Decision Correction 则对同一推理前缀重新采样,构造通向正确与错误结论的偏好对。DPO 的损失只作用于前缀之后的续写,并通过 LoRA 更新,避免把已有分析过程也一并当作需要重学的目标。若普通采样始终失败,离线生成可使用特权提示救援,但训练输入移除提示,并检查选中解释是否仍由原始证据支持。审查模型参与的是离线数据构建,不能把整个训练流程都描述为无需外部模型。
在各系统按 60%/40% 随机划分训练和评估事故、每例八次响应独立评分后平均的设置下,4B 系统的 Exact 在 Telecom、Bank、Market、AIOps 2025 分别为 39.3%、48.7%、11.9%、21.1%。Exact 要求问题所问的组件、故障类型和时间全部正确,不能与只排组件的基线直接等同。Market 仍然困难;迁移到只评组件的 GAIA 时,本方法为 68.6%,低于 FoundRoot-14B 的 88.6%。
值得读的是正常画像与决策训练的拆分,而非“小模型全面胜过大模型”的概括。画像需要可识别的无故障时期及相对稳定的正常行为;实验还使用事故前后的无故障数据,不能直接当成严格在线、只用过去数据的结果。部署时如何更新画像、避免正常状态漂移,仍决定这条路径是否可靠。
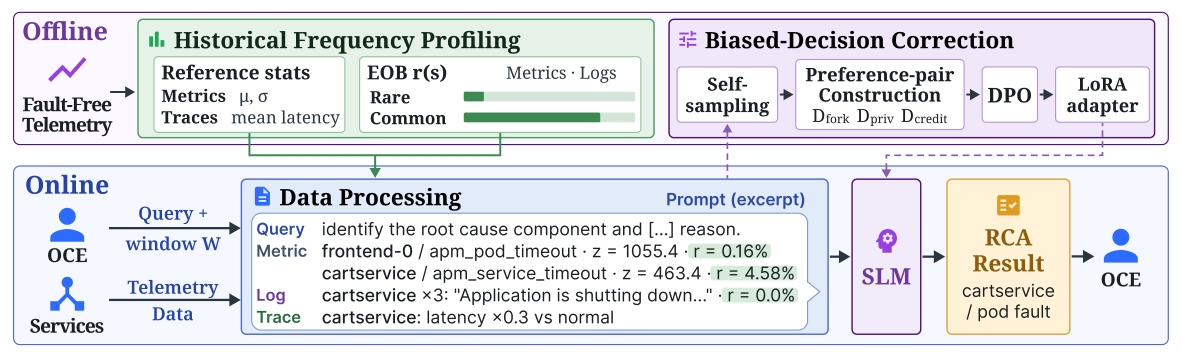
离线路径统计正常时期的异常频率并训练 LoRA;在线把这些频率与事故遥测一起交给小模型。
RTP-LLM:把模型变化与状态生命周期分开管理
RTP-LLM: Building an Evolvable and Reliable LLM Inference Engine at Alibaba Scale
Jiarui Guo, Zhi Zhang, Boyu Tan 等 · arXiv · 首次提交:2026-10-31
RTP-LLM 记录了阿里推理引擎从 Python 服务层到 C++ 优先、再到模型与 serving 分离的演化。当前模型语义放在 Python/PyTorch,调度、KV 管理和资源协调保留在 C++,以减少每次新模型接入都重新翻译参考实现的成本。
可靠性细节比部署规模更值得读:异步缓存传输“已提交”不等于数据“可复用”;请求、传输与保留缓存分别持有引用,全部释放后块才可重新分配;超时停止响应也不意味着可以立即回收仍被异步任务使用的 KV。新状态类型仍可能要求同时修改模型层与共享运行时,接口并不能自动吸收所有变化。
作者给出的四个模型接入案例中,三个 serving 层改动不足 100 行,DeepSeek-V4 则需 5,207 行,体现了复用的边界。生产性能来自三个应用各自单集群的七天观测,报告的小时均值 TTFT 小于 2 秒、TPOT 小于 20 毫秒,不能读成每次请求或尾延迟保证。这是一份维护与运行经验报告,适合关注取消、缓存一致性和回归覆盖的 Ops4LLM 团队。
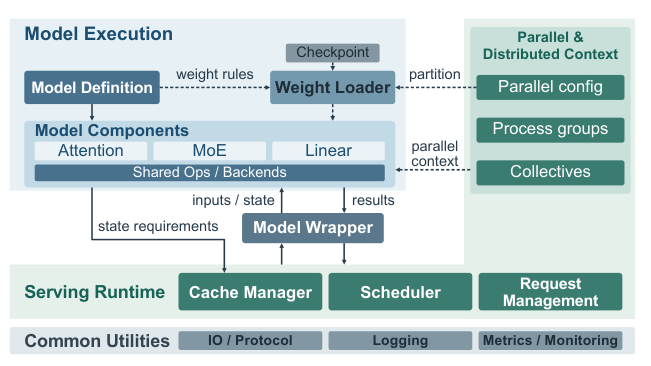
模型描述计算、权重与状态要求,共享运行时负责调度、分配和回收。
静默抓取失败:HTTP 200 也可能没有正文
When 200 OK Is Not an Answer: Silent Fetch Failures in Agentic Web Content Acquisition
Shuyang Zhang · arXiv · 首次提交:2026-10-31
网页 agent 若把 HTTP 200 当成“读到了资料”,可能实际拿到应用空壳、验证页或替代首页。作者在三天内用静态与渲染客户端抓取 10,307 个 URL,包含普通页面、随机不存在路径和 ExpertQA 引用,并区分正文、阻断、挑战、空壳、替代页等结果。
自动标签判断,静态返回 200 的页面中 20.9% 不可用;对留出测试集的复核重加权后,估计从自动标签的 25.5% 降至 20.0%。复核主要由另一 LLM 辅助完成,人工盲审子集的可判定项一致率为 82.5%,不能说全部标签经人工独立确认。只按状态码计算,还会把引用内容漂移从 5.8% 放大到 21.9%。
文本长度、随机路径相似度与跳转首页检查的组合,在复核样本中召回约 86% 的不可用响应、误报约 6%。这些值来自单一访问位置和有限时间窗口,渲染浏览器本身也会失败。可迁移的结论是让抓取工具报告“拿到了什么”,并把缺正文与内容真的变化分开计量。
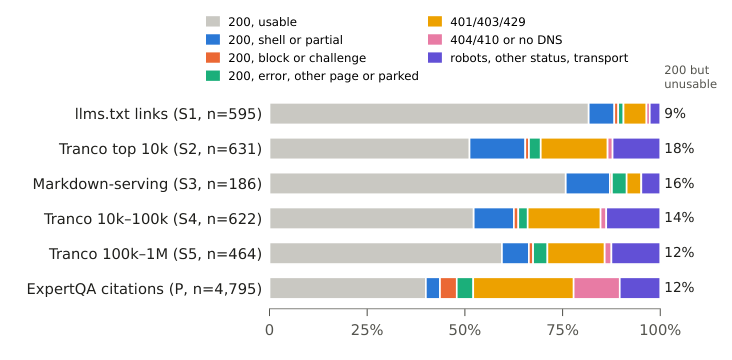
图中比例以全部页面为分母;正文中的 20.9% 则只统计返回 200 的页面,两者不可直接混用。
社区动态:确定性模拟进入验证流程
Workers IO 的发布帖提出在确定性 hypervisor 中运行包含依赖的系统,注入网络延迟、磁盘错误、时钟偏移和进程故障,并复现失败。发布者将目标放在代码生成之后的系统验证瓶颈。值得跟踪的是整系统状态探索与重放能力;“数百万场景”与加固效率属于发布方陈述,短帖尚未给出覆盖度、开销或独立实测。原帖发布于 2026-11-02(UTC)。
社区动态:Paige 把调查过程留在共享证据空间
PagerDuty 原帖链接的完整工程文章发布于 2026-11-03,介绍 SRE Workbench、Deep Investigation 与代码驱动的拓扑。调查保留多个假设、直接和间接证据及被否定的解释,并随新日志、值班记录和人工引导更新。拓扑主要由静态提取与跨仓库事实连接生成,AI 用于离线补充新框架的提取规则。这与只给 agent 更多工具不同:重点是让证据来源与假设修订可追查。文章也承认历史事故回放不完整,现场基准尚不能重现人工输入的全部价值;这些仍是厂商工程报告,不能据此推断跨产品胜负。
社区动态:可观测性任务仍需看失败发生在哪一步
这条关于 APEX-SWE 的讨论提醒,AI SRE 应分别检查证据遗漏、误诊和修复失败。Mercor 官方榜单的 Observability 分项列出 Opus 5.5 为 69.8%,与帖中“约三成未通过”的描述一致。该分项考查生产式遥测下的诊断与修复,不能与 DistDebug-Bench 的代码块覆盖率直接比较,也不能把未通过任务解释成同一种根因分析错误。榜单成绩之外,分阶段失败记录更有助于判断下一步应该改善检索、推理还是验证。原帖发布于 2026-11-03(UTC)。