本期看点
今天的进展有两条主线。Agent 侧,研究开始把“怎样改进”拆得更细:ActiveSaddler 选择下一批最值得学习的失败,RETIRE 处理用户改口后旧执行与新执行的交接,两项实证研究则把目光放在多组件之间的编排、工具与语义边界。关注点从单次回答是否正确,延伸到系统怎样持续演化、怎样停止过时工作。
系统侧,Leto 尝试保住故障后仍可用的训练状态;MegaFlux 与 RapidMoE 分别处理集群中的专家负载倾斜和显存不足时的异构执行;FastCI、ePACT 则把优化目标扩展到开发验证成本与用电合约约束。它们共同提醒我们:单个算子更快,不必然意味着整个系统更高效。
优先读 ActiveSaddler 和 Leto。 前者提供了可与固定课程直接比较的 Agent 改进机制,后者重新划分故障与状态的边界。其余八篇按 Agent 可靠性、MoE 执行和运维效率归组,便于快速判断哪些值得继续追踪。
重点解读
01 · ActiveSaddler:决定 Agent 下一轮应该从哪些失败中学习
ActiveSaddler: Automated Curriculum Learning for Agent Harness Optimization · 项目页
Sungho Park 等 · 2026-10-01 · 重点关注:Qingwei Lin 参与
补丁会变,练习题的价值也会变
Agent 的 harness 是包在模型外面的提示、工具接口与运行控制逻辑。自动优化器已经能够读取执行轨迹、诊断失败并修改这些部分,但常常按预先排好的顺序执行训练场景。一个问题修好以后,继续做同类题的收益会下降;一个失败被第一次修改漏掉,也可能因为课程已经往前走而再无修复机会。
ActiveSaddler 把这个缺口变成独立问题:保持修改 harness 的优化器不变,动态选择提供修改证据的场景。它是离线课程学习,不是给基础模型继续训练权重,也不是在每次线上请求中自动改代码。这个区分决定了应如何理解它的成本和部署位置。
选择的是失败模式,而不只是最难的题
系统把多条失败轨迹背后可复用的薄弱点归成“失败模式”。太粗的任务类别会混在一起,单个场景又容易把同一种问题拆散;以失败模式作为选择单位,才能让多个案例共同支持一次改进。
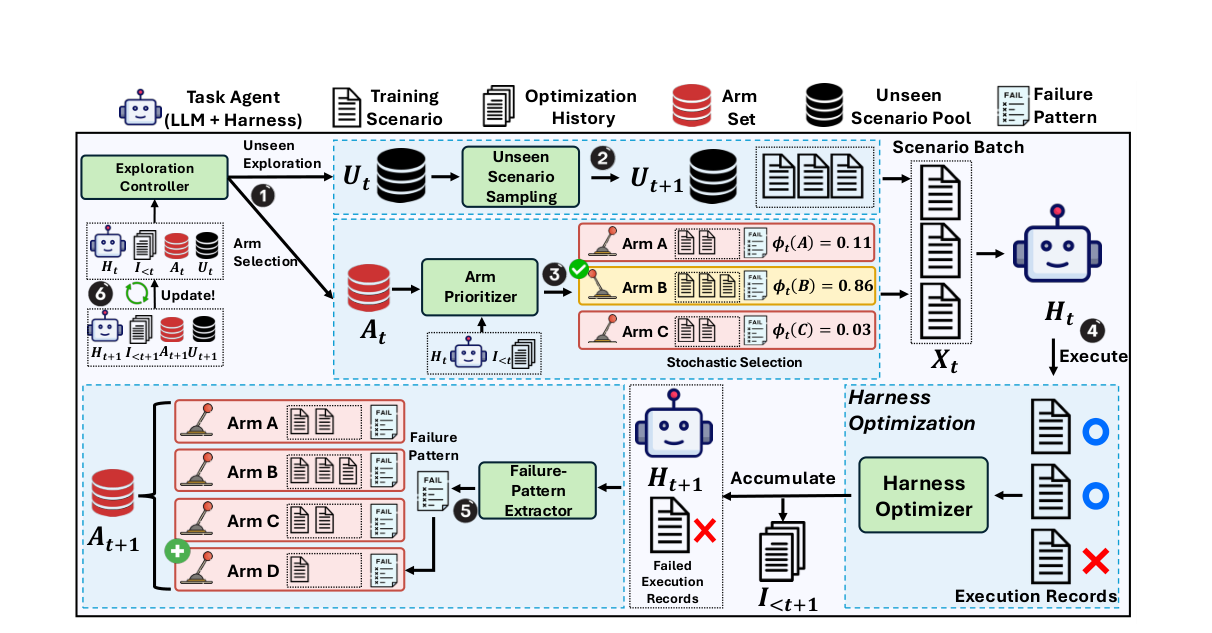
读图:左上决定探索新场景还是重访已知失败;中间选择一类失败及对应场景;下方执行和修改 harness;左下提取新失败模式,并把结果反馈给下一轮选择。
一次迭代先决定“探索或重访”。重访时,优先级模块根据当前 harness 和历史修改,估计不同模式还有多少改进空间,再随机选择目标;探索时,执行尚未看过的场景。随后仍由 AutoSaddler 完成诊断、修改与验证。新的执行结果更新模式集合和优先级,最终用开发集选出一个 harness,测试集只用于最终评价。
因此,这不是把所有失败机械地重试一遍。课程需要辨别“仍值得改”“可能已修好”和“尚未发现”的问题;而这些判断本身也可能出错。方法的增量在于让训练证据的选择跟着系统变化,而非声称模型诊断出的失败模式天然正确。
结果支持什么
论文保持优化器不变,与固定随机场景顺序比较:
| 测试集 | 固定课程 AutoSaddler | ActiveSaddler |
|---|---|---|
| GAIA2,300 个测试任务 | 55.4% | 59.8% |
| Terminal-Bench 2.0,40 个测试任务 | 72.5% | 80.0% |
表中为三次测试执行的平均 Pass@1,提升分别为 4.4、7.5 个百分点。比较共享任务执行预算,但课程控制器也需要额外的 LLM 调用;“同 rollout 预算”不能简化为“完全相同成本”。去掉失败模式分组、动态优先级或探索控制,成绩都会下降,说明收益来自整套反馈分配机制。
阅读判断:值得精读的 Agent 优化方法。 它推动的是“用什么反馈改进系统”,与改进补丁生成器互补。需要保留的边界是:实验使用特定模型、优化器和划分,Terminal-Bench 的测试子集仅 40 个任务,不能当作整个公开榜单的 80% 成绩。继续追踪时,最有价值的是换模型、换任务分布后,失败模式是否仍稳定,以及新增控制成本能否被节省的执行抵消。
02 · Leto:训练进程失败后,保住仍可用的状态
Leto: Fast In-Place Recovery for LLM Training on Surviving Hardware
Geon-Woo Kim、Joon Ha Kim、Daehyeok Kim · 2026-09-30
恢复为什么仍然很慢
训练进程崩溃不一定意味着 GPU 必须重置或更换。Leto 关注硬件仍可继续使用的故障,称为 hardware-operable failures(HOF)。常见恢复路径仍会加载检查点、重算检查点之后的进度,再重建 CUDA 上下文和通信状态;其中一部分工作原本可以避免。
这项工作的关键问题是:如果硬件还在,能否让重要状态不跟训练进程一起消失?它把“进程的寿命”和“恢复所需状态的寿命”分开,并提前准备接班进程。与在备用机器上预热相比,在原硬件、原 rank 上准备状态,可以提前完成更多与身份和设备绑定的初始化。
三个部件共同保证可以接班
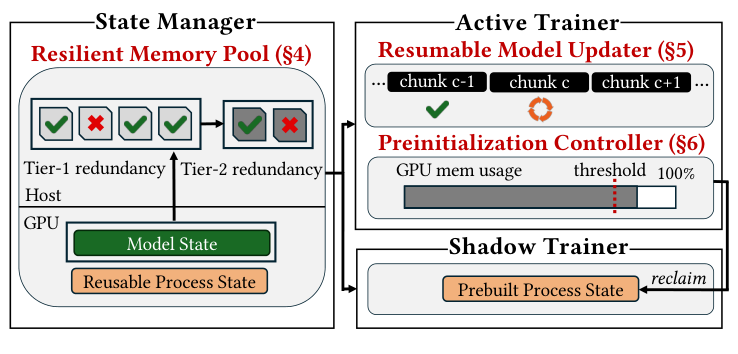
读图:State Manager 持有模型与可复用状态,Active Trainer 正常训练,Shadow Trainer 预先准备接班所需状态。下方的内存控制器在训练需要显存时回收影子进程的预建状态。
首先,状态管理器拥有模型参数、优化器状态及可复用缓冲区的内存,使分配不依附于当前训练进程。模型数据还受到两级纠删保护,冗余保存在主机内存中,以处理部分页面不可访问,而不是假设进程之外的内存永远完好。
其次,保住内存不等于保住一致性。训练若在参数更新中途失败,部分块可能已经更新、部分尚未更新。Leto 用块级事务协调模型状态与校验数据的提交,恢复时从已提交边界继续,避免把半完成更新当成合法模型。
最后,影子训练器预建 CUDA、NCCL 等进程状态。它与正常训练共享 GPU,因此不能无限占用显存;当训练分配器需要更多空间时,系统先回收影子的 GPU 状态。代价是后续恢复可能需要补做初始化。这是把恢复速度与正常训练内存需求放在同一套控制中,而不是免费获得一个完整备用训练器。
故障发生后怎样继续
硬件可继续使用时,影子训练器共同接班,重新连接保留的状态,修复受损页面,并根据更新进行到的位置重启当前迭代或补完更新。它避免重算已经完成的迭代,但不能笼统理解为任何故障都“零丢失、零重算”。若故障需要换硬件、使保留状态无法复用,仍回退到已有检查点恢复。
在 6 GPU 与 72 GPU 的 A100 集群上,作者报告恢复比最优检查点基线快 3.6–6.5 倍,有效训练时间最高增加 13.7 个百分点。论文还给出 131,072 GPU 场景下超过 95% 的有效训练时间,那部分是模拟结果,不是同规模实机部署。
阅读判断:值得关注的训练容错系统设计。 新意在于同时处理状态寿命、更新一致性和预热内存竞争。采用前首先要判断自身故障中有多少属于 HOF,并确认故障分类、状态管理器与检查点回退路径是否可靠;否则,只看恢复倍率容易高估实际收益。
Agent 可靠性与执行语义
03 · 多 Agent 问题实证:编排、工具和记忆是重要故障来源
Understanding Issues, Causes and Solutions in Open-Source LLM-based Multi-Agent Systems
Asad Ur Rehman 等 · 2026-10-01
作者从 21 个开源项目的 22,848 条已关闭 issue 中筛选出 944 条相关记录,分别分析问题、原因与解决办法。最常见的问题类别是编排与执行;常见原因包括工作流、工具集成和记忆机制,优化工作流是主要解决方式。
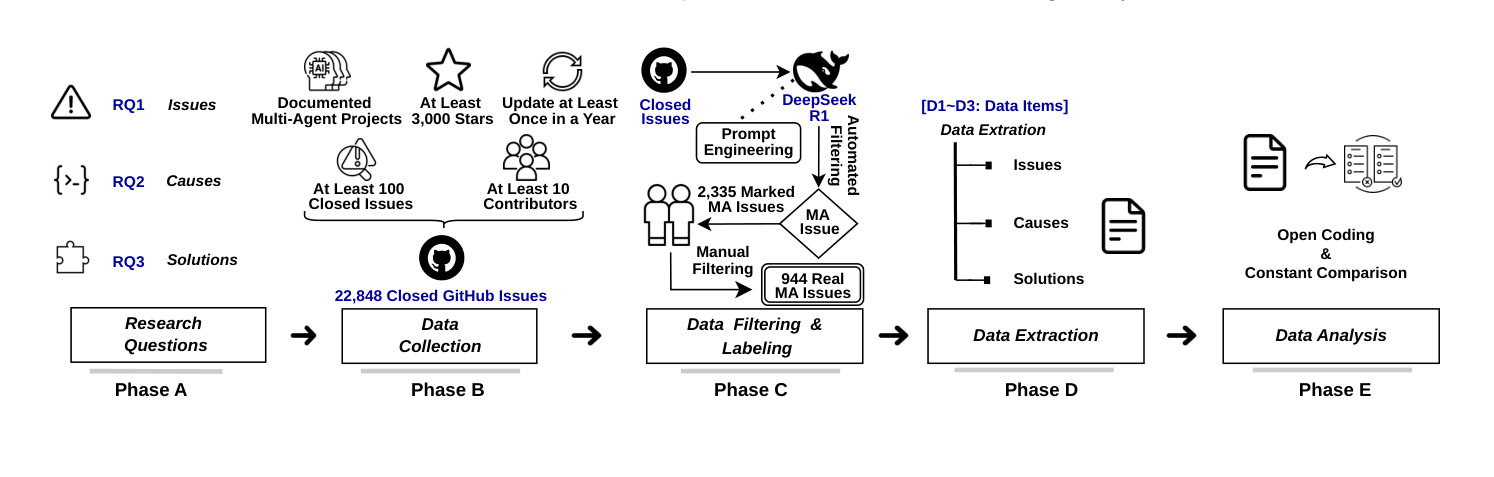
读图:先选择项目、采集和筛选 issue,再分别编码问题、原因与解决方案;这是经验研究流程,不是自动诊断系统。
值得关注的是证据来源。 它将讨论从模型能力转向真实框架的开发与使用问题,可帮助建立测试分类和排查清单。不过,已关闭 issue 具有报告与解决偏差,944 条记录也不是运行次数的分母,不能据此计算多 Agent 系统的线上故障率。
04 · RETIRE:用户改口时,让旧执行失去发布权限
Serving a Revisable World: Versioned Execution for Interruptible Agents
Yanxin Zhang 等 · 2026-10-01
取消旧请求再提交新请求,并不能自动收回已经排队的输出、在途 GPU 工作与可复用 KV 状态。RETIRE 把资源归属和“结果能否继续生效”分开:版本切换先撤销旧执行的权限,再关闭写入、认证可继承前缀,启动后继执行,最后异步回收旧资源。
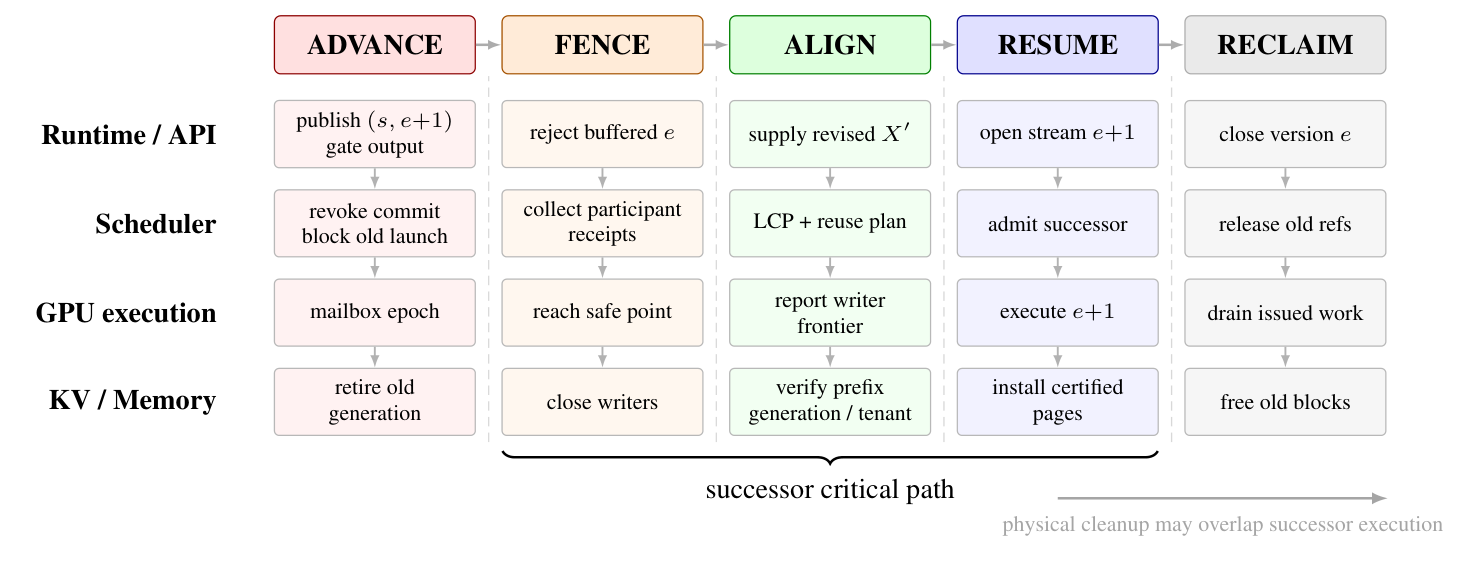
读图:按 ADVANCE → FENCE → ALIGN → RESUME → RECLAIM 读每一列;同一次版本切换跨越运行时、调度器、GPU、KV 与内存层。
作者在 vLLM 上实现这套控制,受控配对实验中后继首 token 延迟中位数下降 17.1%。更重要的是正确性边界:旧结果不得再发布,只有通过认证的状态可以继承。 这不等于能撤销外部工具已经产生的副作用,也不是通用的事务回滚。
05 · Compound AI:把组件之间的边界纳入可靠性设计
Compound AI System Reliability: A Failure Taxonomy and Resilience Pattern Catalog from 150 Production Incidents
Rudrendu Kumar Paul、Sourav Nandy · 2026-10-01
论文分析 150 起事故,将 23 类失败模式归入检索、生成、工具、编排和集成五组,再在六组件测试系统中做故障注入。它强调一种容易漏掉的情况:每个组件都“正常返回”,组件之间的语义或格式契约却已破坏。
作者报告组合至少三种韧性模式后,MTTR 比非结构化监控基线低 71%。这一数字来自其受控实验,不能解释为 150 个生产系统上线后的平均改善。适合作为故障分类与设计检查清单阅读;真正迁移时,还要评估质量门禁的误报、熔断阈值和恢复开销。原文没有适合的架构图,本节保留文字解读。
MoE 与基础设施效率
06 · MegaFlux:用流水化专家复制缓解路由倾斜
MegaFlux: Skew-Resilient MoE Megakernels via Pipelined Expert Replication
Jianzhu Yao 等 · 2026-09-30
融合通信与计算后,热点专家仍可能让少数 GPU 拖慢整层。MegaFlux 在不改变路由输出的前提下,动态选择专家副本位置并分配 token 块;权重到达一部分就开始相应计算,反向阶段再把副本梯度归约与其他计算重叠。
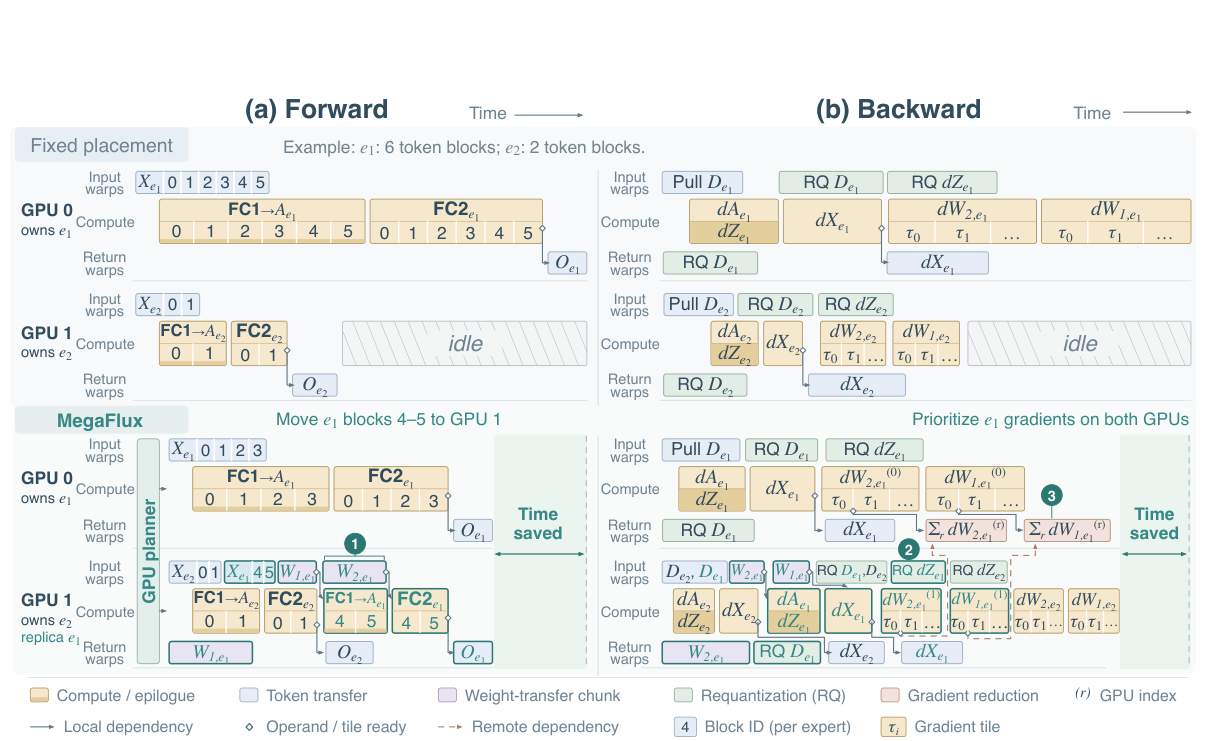
读图:上方固定放置与下方复制方案对比;左看权重到达和前向计算如何交叠,右看反向计算与副本梯度归约如何交叠。
8 张 B200 上,前向和反向层级加速的几何平均分别为 1.45×、1.28×;接入 vLLM 后的 prefill 端到端中位加速为 1.13–1.26×。不能把层级倍率直接当整机收益。 复制也有通信和规划成本,小规模反向工作负载可能退化,跨节点拓扑尚未验证。
07 · RapidMoE:低精度常驻 GPU,关键残差交给 CPU
RapidMoE: Exploiting Cross-Asymmetry via Adaptive Residual Offloading for Large-Scale MoE Inference
Wenxun Wang 等 · 清华大学 · 2026-10-01
显存装不下完整 MoE 时,整专家搬运受 PCIe 限制,大量 CPU 计算又容易过慢。RapidMoE 将权重拆成低精度表示和残差:GPU 保持量化计算路径,CPU 为动态选中的关键专家做残差修正,UMIA 调整关键集合以平衡精度与延迟。
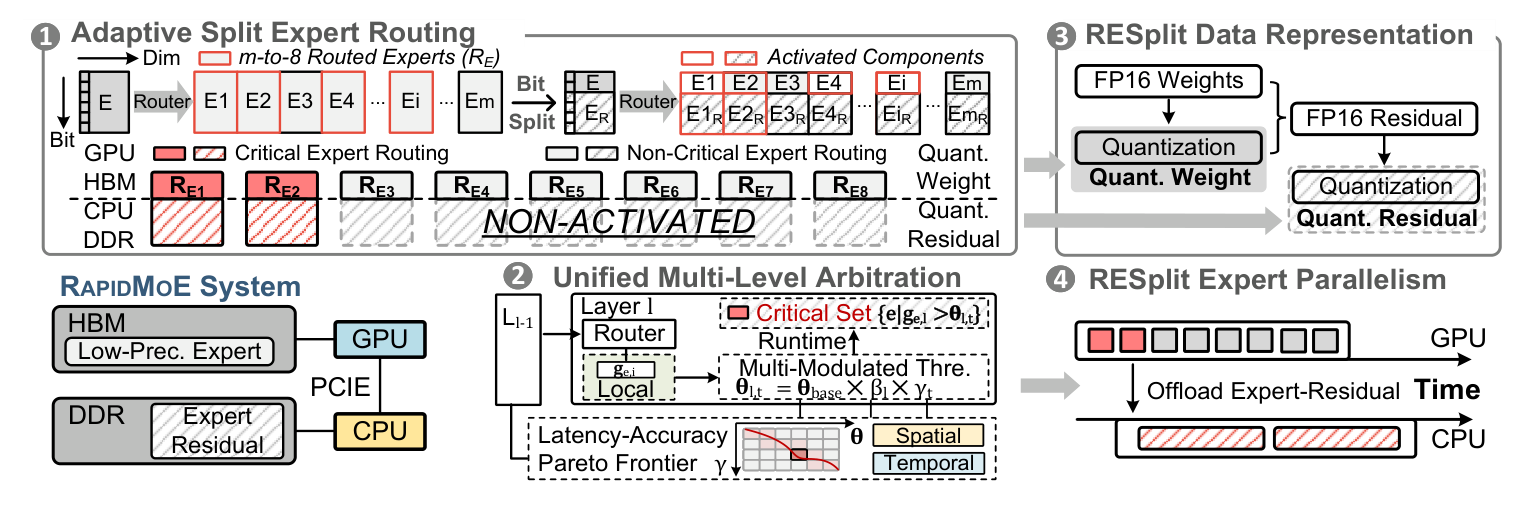
读图:左上选择关键专家,右上分开表示量化权重与残差,左下 UMIA 调整关键集合,右下展示 GPU 与 CPU 的执行交叠。
作者报告相对所比较卸载系统最高 3.5× decode、2.1× prefill 加速。它与 MegaFlux 解决的是不同部署条件:这里针对显存受限、较低并发的 CPU–GPU 平台,并涉及量化与选择性修正的精度取舍;不能视为全 GPU 高并发服务的直接替换。
08 · ePACT:把用电承诺偏差纳入服务调度
ePACT: Energy-Performance-Aware Commitment Tracking for LLM Serving
You Peng 等 · 2026-10-01
如果超过和低于事先承诺的用电量都会产生费用,单纯最小化能耗未必最省钱。ePACT 的全局规划器根据累计消耗与剩余小时承诺更新目标,局部控制器预测配置的能耗和完成时间,在服务约束下选择容量与 GPU 时钟。
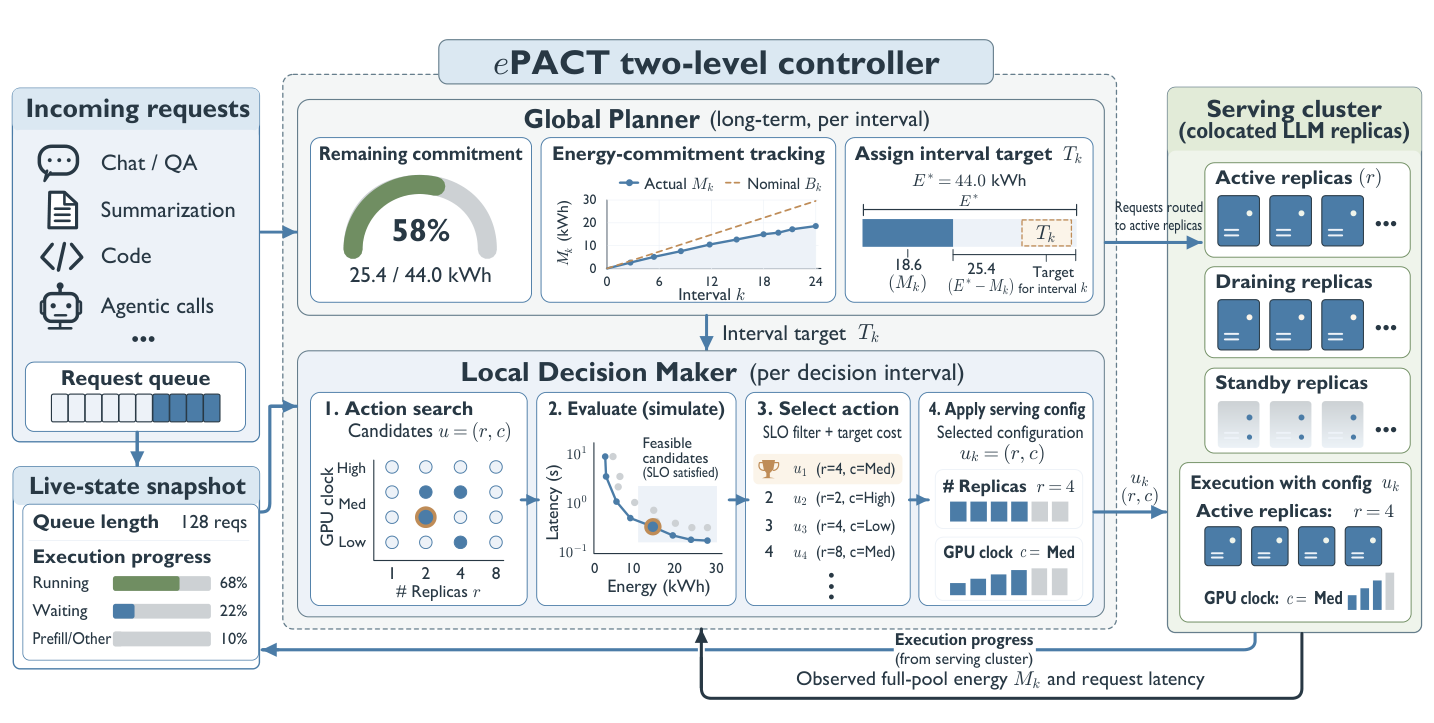
读图:上层更新能量目标,下层搜索配置并检查预测 SLO,右侧将配置应用到服务池;实际能耗再反馈回来。
24 小时轨迹模拟中,H20/H200 的非对称偏差费用分别下降 73.8%/75.7%,SLO 达成率接近 vLLM。这是特定双向收费模型下的偏差费用,不是总电费或能耗下降同样比例。 预测式 SLO 检查也不构成硬实时保证。
09 · FastCI:用运行证据减少 GPU 持续集成浪费
FastCI: Efficient GPU-Intensive CI for LLM Training Frameworks
Tianshuo Qiao 等 · 2026-10-01
训练框架的 CI 常需运行真实训练或评估,测试本身便占用大量 GPU。FastCI 用运行轨迹把改动定位到受影响测试,裁掉在等价上下文中重复覆盖改动的测试,再优先执行高风险测试,并缩小不属于该测试验证目标的负载维度。
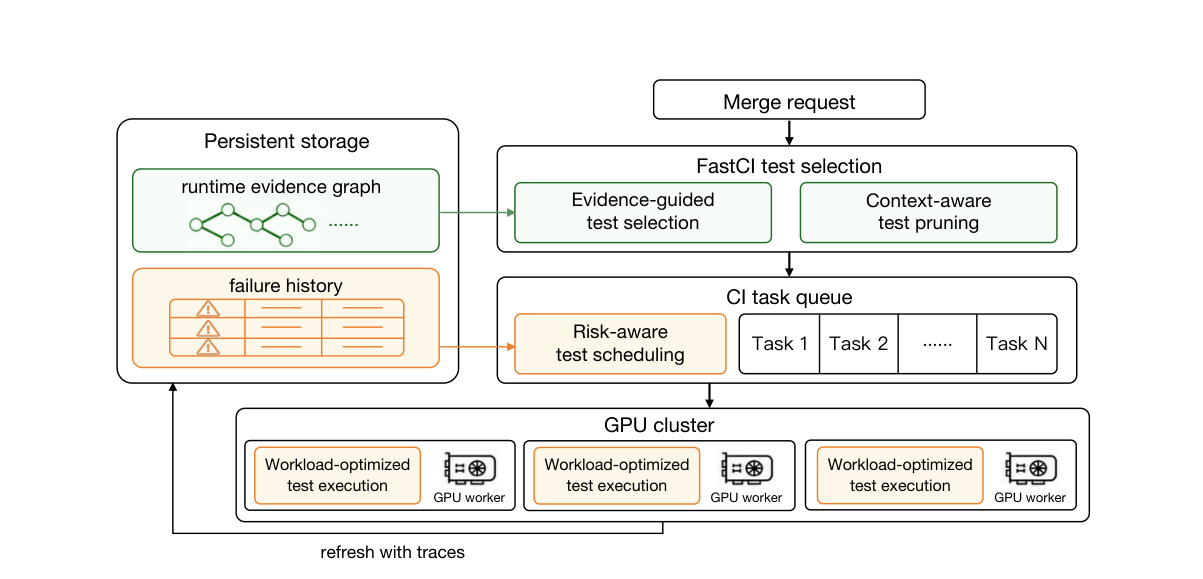
读图:代码改动进入选择与裁剪阶段,留下的测试经过排序和负载调整;历史运行证据持续更新底部的证据存储。
在作者所在 ByteDance 训练框架的工作负载上,相比原部署流水线,CI 延迟下降 77.5%、GPU 用量下降 63.9%。值得看的是“减小测试但保留验证目的”的机制。 改动代码覆盖保留率不能等同于所有缺陷的检出率,采用时仍要关注新代码缺少历史证据和工作负载缩减遗漏回归的问题。
10 · LOGOS:从原始日志压缩出可追查的故障链
From Alert Floods to Precedence Forests: Zero-Prior-Knowledge Incident Triage with LOGOS
Radhika Niranjan Mysore · 2026-10-01
没有完整 tracing 或拓扑时,LOGOS 通过实体与事件共现、时间先后关系,从日志中构建紧凑的 precedence forest,再供人或 LLM 诊断。25 起企业事故与 12 个开源问题中,作者报告处理耗时中位数 4.5 分钟、平均召回率 0.76。
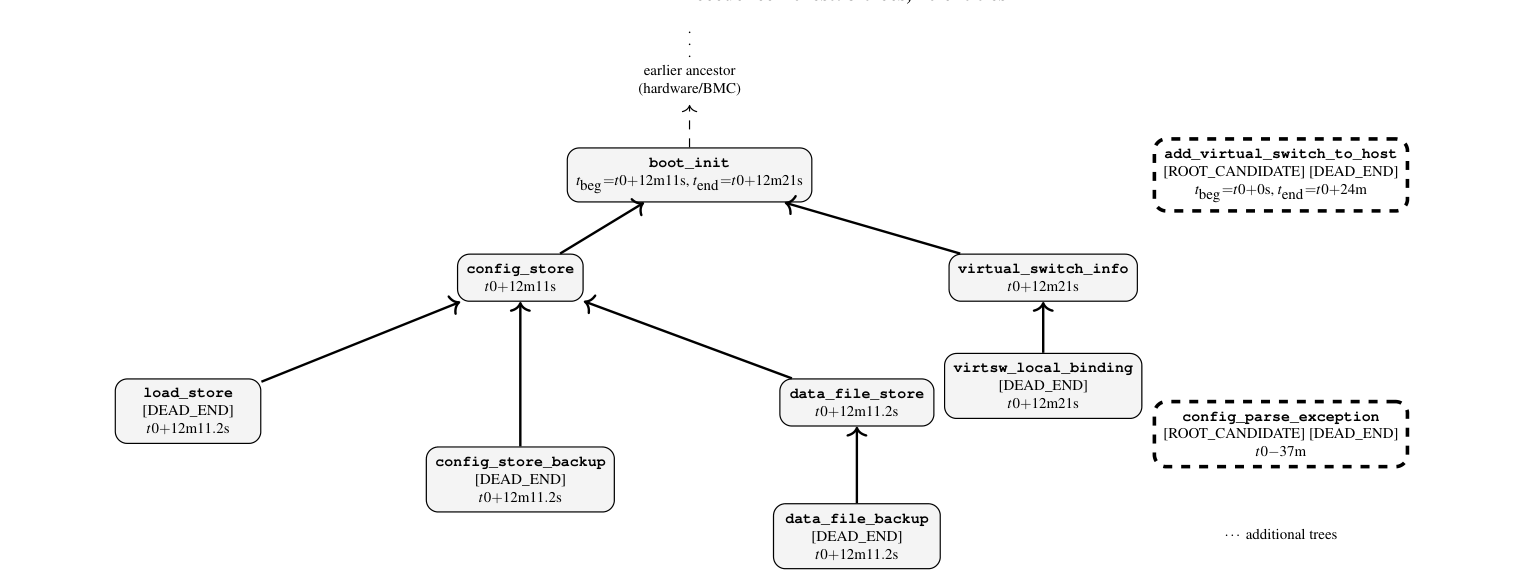
读图:实体沿较早出现的共现关系组织成多棵树,叶节点和根候选帮助缩小调查范围;箭头表示构造的先后关系,不能直接当作因果证明。
价值在于为诊断准备上下文,而非自动证明根因。 “零先验”不代表零接入成本:仍有按厂商实现日志解析的工作;只选最大连通部分还会漏掉次要子图里的根因。它是离线日志包的初筛,不是持续在线、可交互的完整诊断平台。
技术阅读:两篇独立 Tech Notes
- TLX Jagged Flash Attention:让不等长序列填满 Blackwell 流水线——看高层语言如何暴露底层调度,以及为什么推荐模型的 jagged 结果不能直接推广到稠密 LLM。
- KV Cache 与 LMCache:从一次生成到多轮状态复用——解释缓存保存什么、为什么增长、何时复用值得,以及外部存储层要解决的问题。
社区与数据集动态
GitHub Copilot coding-agent 轨迹开放。 Azure 官方数据说明确认,公开集包含 301K 会话、9.3M 次 LLM 调用与 8.7M 次工具调用,采样自 2026 年 6 月 1—7 日的非企业用户会话。
这份数据适合研究时延、缓存、调度和调用结构;它不含提示词、回答、工具输出或代码正文,模型名也被匿名化,因此不应当作可直接监督训练的完整对话集。用户提供的 @haoran_qiu98 消息时间是 10 月 2 日 01:05(上海),本期作为次日补充收录;具体发帖分钟未独立核验,内容以官方数据仓库为准。
接下来值得跟踪什么
本期最清晰的趋势是:系统优化正在更认真地管理状态和证据的寿命。 失败模式是否过时、旧执行是否仍有权限、训练状态能否跨进程存活、缓存能否跨请求复用,分别影响不同层面的可靠性与成本。后续可以重点看这些机制在更长时间、更复杂分布下的退化与恢复表现,而不只追踪单次实验的最高提升。