本期看点
本期重点是 Agent 可靠性里几种容易被“成功运行”掩盖的问题:固定 RCA 流程可能漏读关键证据;容器重启后,状态还在却没有人继续任务;提示缓存失效时,答案仍然正确,账单和统计却悄悄改变。三项工作分别从共同评测、平台事件和真实修复记录给出证据。
另一些进展把控制边界拆得更细:独立 reviewer 的投入是否划算,记忆加工是否真的优于原始检索,回顾生成的规则能否帮助后续任务。推理系统侧,ZipFusion 将无损 KV 解压融合进 attention;InferScale 展示预测扩缩容与冷启动、资源占用之间的取舍。阅读这些结果时,区分总体准确率、局部收益和完整系统行为,比寻找一个统一的最高分更有用。
01 · RCA:让模型自己选择证据,是否比固定诊断流程更有效?
Free to Look, Free to Reason: Simple LLM Harnesses Outdiagnose Hand-Crafted Root Cause Analysis Agents
Bi, Tingzhu, Zhang, Xun, Li, Jinglin, Wang, Ping, Ma, Meng · 2026-10-26
微服务根因分析常把专家经验写成标准流程、角色分工和固定检查阶段。但系统已经提供日志、指标和调用链时,这些控制是否仍能帮助强模型?这篇工作把三种简单 harness、五种已发表 LLM RCA 方法与统计、因果方法放到共同数据上比较,直接检验了一个经常被略过的基线:让模型自己决定查什么。
先统一案例,再比较控制权
作者构建 RCAtlas,将八个公开数据来源转换成统一格式,从经过有效性审查的案例中选出 90 个,覆盖 23 个场景。输入包括异常时间段、事前窗口、实体清单及可用遥测;输出是根因实体排序。评分会把更细的容器、Pod 答案映射到数据集标注层级,避免方法仅因答案粒度不同而失分。
三种简单方案的自由度并不一样:one-shot 接收规则整理的证据包;SQL agent 自行查询遥测;Codex 自行编写分析代码。前者仍受到证据预处理约束,后两者才能动态改变调查路径。它们的共同点是没有把领域调查步骤固定成必须执行的模型调用链。
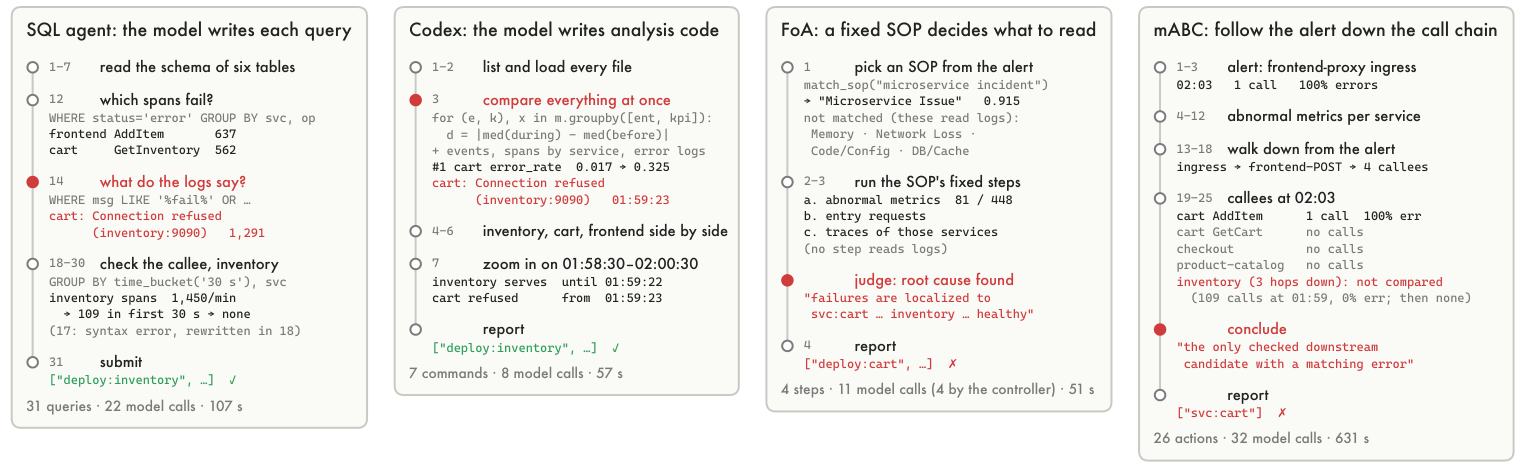
左侧两种方案主动读取日志并检查下游;右侧固定流程把调查停在症状服务。红点标出决定性步骤。
一个案例中,cart 大量报错,真正的故障却是 inventory 不再接收请求。自由查询方案读到连接拒绝日志,再检查下游请求量骤降;固定 SOP 没有日志步骤,沿告警调用链推进的方案也遗漏了已经没有调用的下游。这解释了固定流程如何错过决定性证据,而非只展示总分差距。
准确率之外,要分清模型、重复运行和成本
主表中简单方案 PR@1 为 65.3%–77.2%,已发表 LLM 方法为 15.6%–53.3%,最强非 LLM 基线 NSigma 为 38.9%。这是主表所用中档模型的汇总,部分方法与模型组合未运行;不能理解为所有方法都在完全填满的模型矩阵上取得该区间。对共同运行的模型,简单方案仍占优。
更强模型主要减少重复运行的不稳定,多轮工具使用主要增加至少一次解题成功的机会;提高推理强度则可能增加大量时间而仅换来少量准确率。这个拆分比单次最高分更适合判断事故诊断系统:需要的是稳定找到根因,而非偶尔走通。
值得优先阅读的是共同评测与失败轨迹。 部分基线经过重实现或适配,研究只测试一种通用编码 harness;单个案例和“预设调用比例”也没有构成控制流程导致低分的因果消融。因此,结论支持把简单 harness 作为强基线,并重新审视强制 SOP 的代价;它没有证明领域知识无用。将经验作为可选择的指导,再保留读取原始证据的通道,是这一结果提出的自然问题。
02 · 容器化 Agent:保存状态、恢复任务与完成停机是三种保证
Built to Remember, Shipped to Forget: Operational Contracts, Failures, and Repairs in Containerized LLM Agent Deployments
Mastouri, Meriem, Ksontini, Emna, Barrak, Amine · 2026-10-25
Agent 框架可以保存对话、暂停等待人工输入、从检查点继续执行;Docker 和 Kubernetes 则允许随时重启、替换或强制终止容器。两边各自符合文档,也可能在组合后失效。这项研究把接缝明确为“运维契约”:某个平台事件发生时,部署必须提供什么保证,才能保住 Agent 原本承诺的行为。
从两套文档推导可检查的义务
作者联合阅读 LangGraph 与 Docker、Compose、Kubernetes 的一手文档,提取、人工验证并合并出 14 项契约,覆盖保存状态、运行中工作、客户端和外部资源。一个直观例子是:框架允许后台任务在退出时排空 180 秒,容器却只给 10 秒就发送强制终止信号。实现了优雅停机函数,也无法弥补平台不给它运行时间。
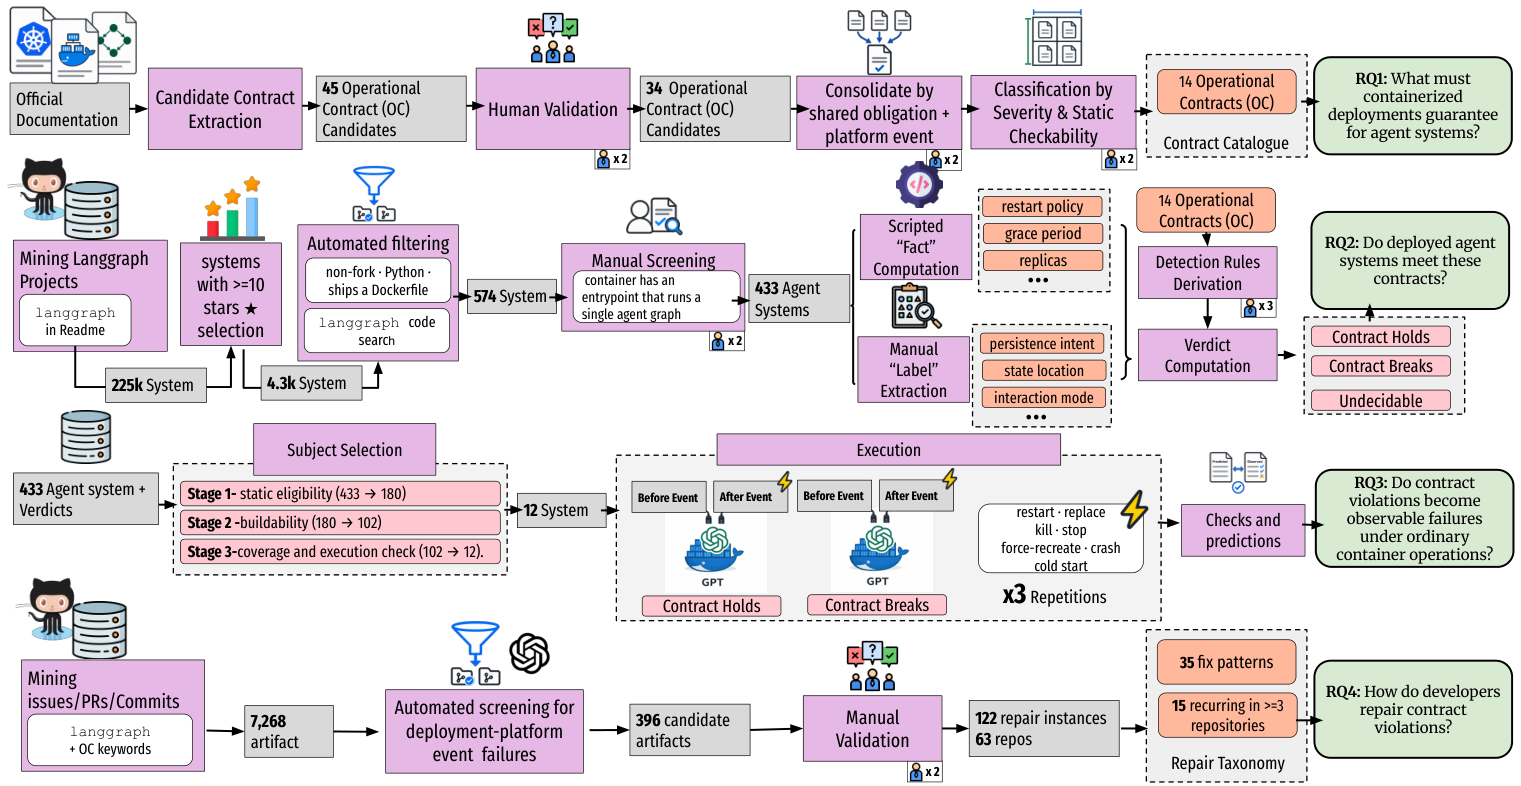
四行依次建立契约、检查仓库、执行平台事件、对照开发者修复;静态判断和运行证据分开保留。
研究随后检查 433 个开源系统,并明确区分“不适用”“满足”“违反”和“证据不足”。需要跨请求保存状态的系统有 265 个,其中 99 个不满足进程重启后的状态持久性,110 个不满足容器替换后的持久性,分别为 37.4% 和 41.5%。这些是适用契约的子集比例,不是全部 Agent 的线上故障率。
有检查点,仍可能永远停在半路
状态持久化只回答“数据还在不在”。后台任务是否会被重新认领、恢复后的步骤是否重复付款或创建资源、流式客户端能否拿到剩余输出,是另外的问题。研究中 61 个相关后台系统有 54 个未在仓库中提供恢复机制,其中 28 个已经满足状态跨进程保存的要求。这个组合说明,数据库存在不能单独证明恢复能力。
运行验证选出 12 个可执行系统,诱发重启、替换、停止、强制终止等七类事件。16 个预测违规中,14 个表现为对应运行失败;七个可评分的“满足”预测全部通过。两个未复现的违规来自镜像内部额外保障,恰好揭示静态检查的盲点:实际部署镜像可能比仓库文件多做了工作。
修复必须跨过应用与平台边界
独立挖掘出的 122 项修复里,78% 只改应用代码,约三分之二完整恢复了相应义务。尤其在排空和任务续跑上,仅增加处理函数或“任务中断”状态,仍可能没有补齐平台宽限期和重新执行机制。
这项工作的价值是把混沌测试对象从容器存活扩展到 Agent 语义。 检查点、任务完成、外部副作用和客户端交付应分别设定断言。证据目前主要来自 LangGraph 生态;运行实验为了契约覆盖而挑选系统,每项契约只测试少量对象,不能据此推算整个生态的失效率。它更适合作为部署审查与故障注入的结构化起点。
03 · CACHELINT:答案没错,缓存集成也可能悄悄失效
Silent and Costly: Characterizing and Detecting Prompt-Caching Mis-Integration in LLM Agents
Zhang, Ying, Guo, Ruoqi, Liu, Yi, Deng, Gelei, Li, Yuekang, Liu, Yepang, Zhang, Leo · 2026-10-26
Agent 输出正确、HTTP 请求成功,并不意味着提示缓存工作正常。缓存前缀里多了时间戳、模型改名后漏过能力判断、返回的缓存 token 被错误计费,都可能让系统继续回答,却持续增加成本,甚至让观测面板掩盖问题。本文把这类故障作为独立的软件集成问题研究。
请求侧与读数侧需要不同检查
作者从十个开源 Agent 系统的已合并修复中确认 120 个案例。97 个发生在请求侧,23 个涉及返回用量的处理;108 个没有显式错误,其中既有缓存失效造成的浪费,也有缓存实际正常、统计却错误的情况。因此,“没有异常”和“面板显示命中”都不能独立充当缓存正确性的判据。
独特之处是把缺陷表示成“调用位置+必须成立的前置条件”。CACHELINT 用 CodeQL 定位缓存指令和用量字段,再分别检查前缀稳定性、提供商能力与计量安全。对于时间戳或非确定序列化,需要判断改变的值是否真的进入缓存区、上游是否已有规范化;看到一个时间函数就报错会产生大量误报。
提供商能力又是另一类事实:同一模型、TTL 或缓存标记,在不同 API 上可能有不同语义,并会随时间变化。方法使用带核验日期和官方来源的能力表进行比较,不让模型凭训练记忆推测当前提供商支持什么。LLM 则负责有限代码上下文中的 guard 判断,例如已有排序或空值保护是否解除风险。
检出结果必须和规则来源一起看
在形成规则的十个项目上,作者报告 precision 0.71、recall 0.78。该召回率来自规则同源的数据,论文明确把它视作样本内上界,而非独立泛化估计。另在 571 个项目中,37 条告警经人工检查得到 32 个真实问题和五个误报,precision 为 0.86;因没有穷尽缺陷标签,这组实验不能计算 recall。正文报告已有 21 项开发者确认、18 项修复。
单点模型也有明确盲区:跨轮次修改历史、不同调用重新组装前缀,需要比较多个执行快照。120 个案例中的这两类共有 24 个,构成大多数漏报。LLM 还可能漏看实际存在的 guard,能力表本身也要更新。
值得关注的是把“正确运行”扩展到成本语义和计量语义。 对 Ops4LLM,缓存检测不应只有一个命中率,而应同时解释请求前缀、提供商能力、响应字段与账单之间是否一致。论文给出了可落到代码位置的检查框架,但它仍需要运行时证据补足跨调用行为。
04 · 验证 harness:独立复核比反复要求自查更划算
Rethinking Verification in Agent Harnesses
Zhang, Zhengxin, Zhu, Erkang, Lin, Yin, Cardie, Claire, Ding, Bolin, Zhou, Jingren · 2026-10-25
作者比较初始指令、运行中提醒、完成门禁和独立 reviewer 四层共 17 种设计。独立 reviewer 在新上下文中读取任务与修改,访问同一个沙箱执行检查,但不直接修改交付物;问题返回主 Agent 修复。
七个编码模型在 Terminal-Bench 与 SWE-bench Verified 的选定子集上,独立复核平均分别提高 5.9–9.5、3.9–6.6 个百分点,总成本含复核和修订,为基线的 1.13–1.25、1.00–1.04 倍。反复拒绝完成也能改善成绩,但代价更高。完整轨迹不总比“任务+修改”更好,且增加 reviewer 成本。
这为 AgentOps 提供了可比较的验证位置和成本设计;收益是跨模型平均,个别组合仍退步,也不是完整榜单成绩。值得看 reviewer 如何构造主 Agent 未测试过的反例。
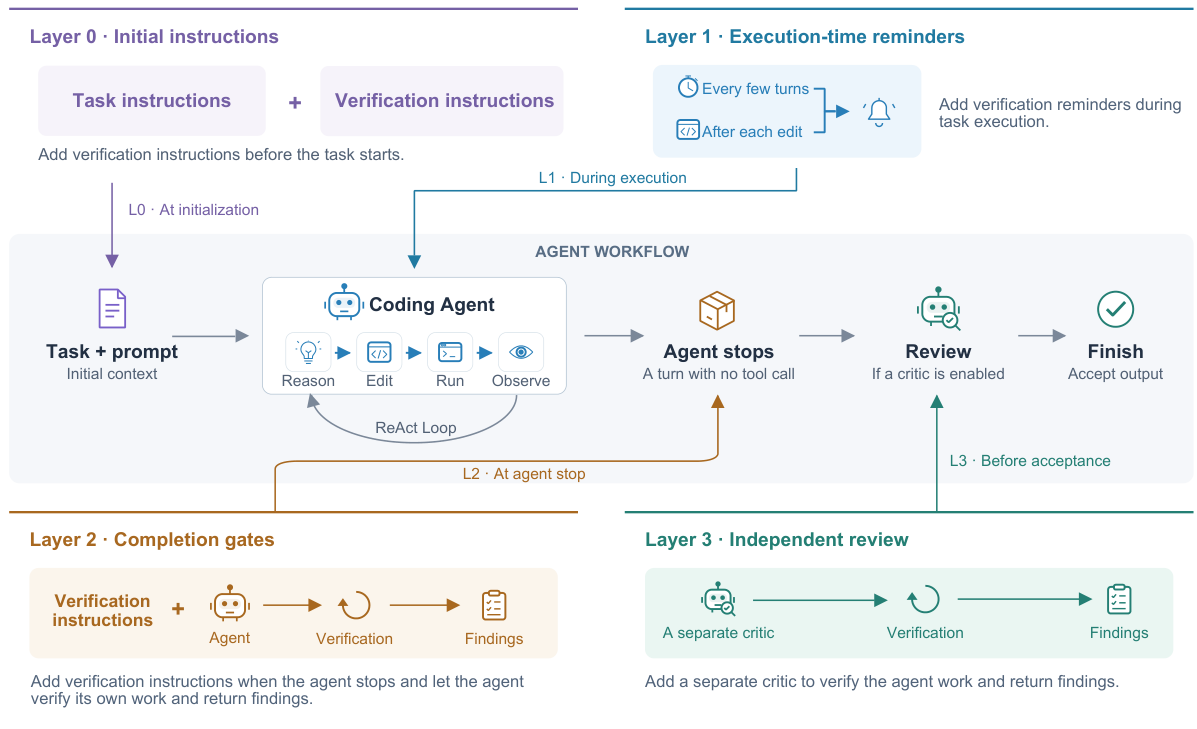
沿中间执行链读:前三层要求主 Agent 检查,最后一层由独立 reviewer 返回发现。
05 · Memory Tax:保存过的信息,也可能变得更难找
Memory Tax: Dissecting the Net Value of Agent Memory
He, Xuan, Zhoubian, Sining, Yang, Ruozhen, Wen, Yuhao, Wang, Zhineng, Hu, Yuyang, Yang, Ke, Zhang, Yuyu, Nie, Ping, Han, Jiawei, Zhai, ChengXiang · 2026-10-25
这项研究用原始历史上的简单 RAG 作参照,把记忆系统新增的答对问题与新增的答错问题分开统计。十一种代表性记忆系统、三个骨干与三个主要基准的比较表明,额外加工常抵不过丢失、改写和检索困难带来的损失。
诊断不止看总分:用正确记忆单元绕过检索,检查信息是否已在构建时丢失;多轮检索检查证据是否只是埋得更深;交叉更换构建与回答模型,测量敏感性。补充原始历史检索是论文测试的一条恢复路径。
对长周期 Agent,价值在于要求复杂记忆证明相对直接检索的净收益。评价主要静态、离线、英文,部分基准用分层子集;检索友好的任务会缩小复杂记忆的增益空间,不能据此断言所有记忆无效。
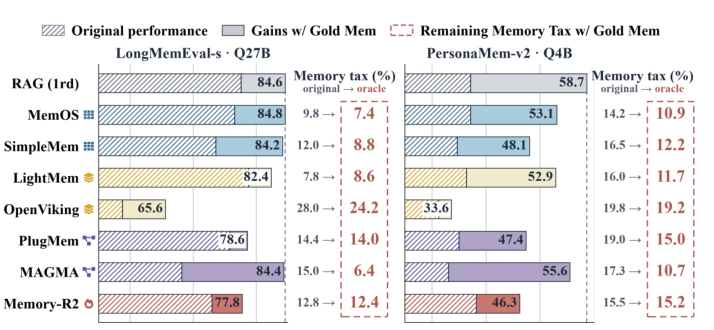
浅色延伸表示绕过检索后的收益;仍留下的红框差额提示信息构建阶段也可能造成损失。
06 · Harness 自演化:写下经验不等于后续少走弯路
How Do Coding-Agent Harnesses Self-Evolve? An Empirical Study of Retrospective Adaptation
Treude, Christoph, Baltes, Sebastian · 2026-10-26
作者让 Claude Code 在 30 个 SWE-bench Verified 任务后运行回顾,得到 125 条建议;人工选择后实施 24 条,最终评估 12 项改动在同仓库后续任务中的迁移。每个条件用新的会话和容器,重点观察目标行为是否再次发生。
七个有信息量的评估中,两项消除了目标行为,一项减少,四项没有减少。写明正确测试入口能避免反复调用不存在的 pytest;不完整的已知失败列表却可能让 Agent 在无关任务上多做检查。一例虽然消除了错误命令,附带 lint 指令仍使中位耗时从 88 秒升到 156 秒。
这是人参与选择的小样本行为研究,不是全自动自改进成功率。它给 AgentOps 的具体启示是分开检查:问题是否出现、经验是否被读取、行为是否改变、任务结果与总成本是否改善。
07 · ZipFusion:压缩 KV 一直保留到 attention 寄存器
ZipFusion: Fusing Lossless KV Decompression with Attention for Efficient LLM Decoding
Chen, Yuetao, Wang, Peng, Xu, Hong · 2026-10-24
以往无损 KV 压缩常在 attention 前恢复完整缓存,省了传输却没省反复读取 HBM。ZipFusion 将 BF16 指数编码与 attention 布局共同设计:符合指数范围条件的块用 12 位保存原来的 16 位信息,不合条件则保留原格式;线程在寄存器中恢复原始比特,无需完整解压缓冲区。
H100 80GB 上,两个 8B 模型的 decode attention 加速约 1.23–1.25 倍。8K 输入、相同显存预算且各自取最大 batch 时,相对未压缩 SGLang 的 decode 吞吐最高提高 26.3%。这组计时排除 prefill 和初始压缩,新生成 KV 未压缩,不能直接当作端到端服务收益。
值得读的是压缩格式、读取布局和跨层内存回收如何协同,而非仅比较压缩率。
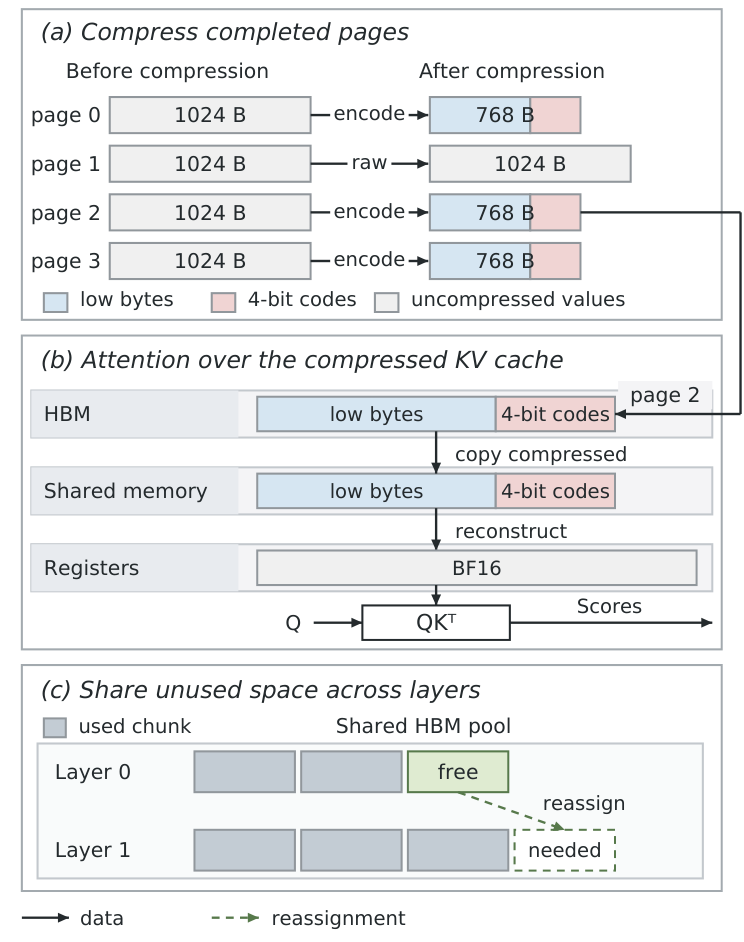
从上到下:合适的块变小;attention 在寄存器内重建;释放的内存块可跨层重新分配。
08 · ToolContractGate:把调用许可与执行保障分开
ToolContractGate: Versioned Trusted Contracts for Drift-Safe Agent Tool Invocation
Gupta, Sachin · 2026-10-22
ToolContractGate 把 OpenAPI 文件指纹、版本、权限、schema 和副作用声明放进版本化合约。启动时校验文件 SHA-256,调用时执行十项检查,再返回 ALLOW、WARN、REVIEW 或 BLOCK。其增量是把获准的来源工件与调用声明一起检查,而不只看输入能否通过 schema。
45 个合成案例中,35 个不安全案例全部产生非 ALLOW 结果,但其中只有 29 个 BLOCK,另有三项 REVIEW、三项 WARN;900 条记录是这些案例在配置间的重复,不能算 900 个真实负载。
边界尤其重要:实验端点只返回决策,宿主必须负责阻断和人工复核;启动后文件修改要重载才能发现,后端保持名称和 schema 却改变行为也可能通过。因此它是可审查的合约评估原型,不是已证明完整防漂移的生产网关。
09 · InferScale:预测的价值在于赶上冷启动
InferScale: Kubernetes-Native Predictive Autoscaling for SLO-Aware AI Inference
Huang, Wen · 2026-10-25
InferScale 在 Kubernetes 副本控制层组合短期趋势预测、SLO 状态、突增快速路径和租户优先级;每五秒读 Prometheus 指标,并用健康阶段的样本估计单副本能力,避免把过载吞吐下降误认为正常容量。它不替换调度器。
AKS 上 ResNet-50 的 CPU 推理实验,冷启动约 21 秒,三次 ramp-burst 运行的 SLO 达标率从外部指标 HPA 的 47.8%±1.5% 升到 65.3%±9.0%。代价也可见:平均副本数由 2.1 增至 5.5。另一个受控多租户实验稳定了 Gold 租户,低优先级延迟却可能变差。
这项工作提示扩缩容评价要同时看启动时间、资源占用和谁承担争用。它不是 GPU/LLM 实测;LLM 的 prefill/decode、KV 压力与动态 batch 仍需不同容量模型。