本期看点
本期优先读 OS-Bench 与 JointServe:前者追问 Agent 把程序迁到另一个操作系统后,是否还保住原平台行为;后者追问多模型 Agent 在有限显存中切换专家时,怎样避免反复搬权重、重建上下文。两篇分别把评测和调度的单位向外扩了一层,从单环境修复走向双平台约束,从单模型请求走向完整会话。
DiffTry 则提供一个更轻的系统控制点:按请求价值分配重试机会,让过载时的拒绝有所区别。配套技术阅读关注推理服务里的验证预算、KV 传输和训练数值一致性,以及如何把 Agent 执行接入已有观测系统。共同值得关注的是,局部步骤成功或变快,并不足以说明整条任务链已经可靠、高效。
01 · OS-Bench:迁好目标平台,也要保住源平台
OS-Bench: Evaluating SWE Agents on Cross-OS Code Migration
Qirui Jin、Kenan Li、Liao Zhu、Lingching Tung、Yikai Zhang、Yijia Wu、Zijian Jin、Pengfei Gao、Yu Kang、Qingwei Lin、Wenke Lee · 首发:2026-10-14 · 重点关注:Qingwei Lin 参与
把“双平台正确”写进成功条件
跨系统迁移不只是重新编译。路径、进程、编码、系统 API 与构建工具都可能改变行为,而目标平台通过的测试通常覆盖不到源平台专属分支。OS-Bench 将成功定义为同一补丁同时通过目标平台修复与回归测试,并保住源平台原来通过的测试。这使“迁过去能跑”和“迁完仍兼容”成为可比较的两个结果。
它没有直接把历史提交当题目,因为一次迁移可能跨多个提交,还混着无关修改。作者先在 Linux、Windows 原生环境运行同一仓库,以执行覆盖差异寻找平台专属区域,再用语言模型筛查条件编译、API、路径、编码等差异,并由人工进一步过滤。覆盖不对称也可能来自测试选择或依赖差异,因此并非所有差异都进入题目。
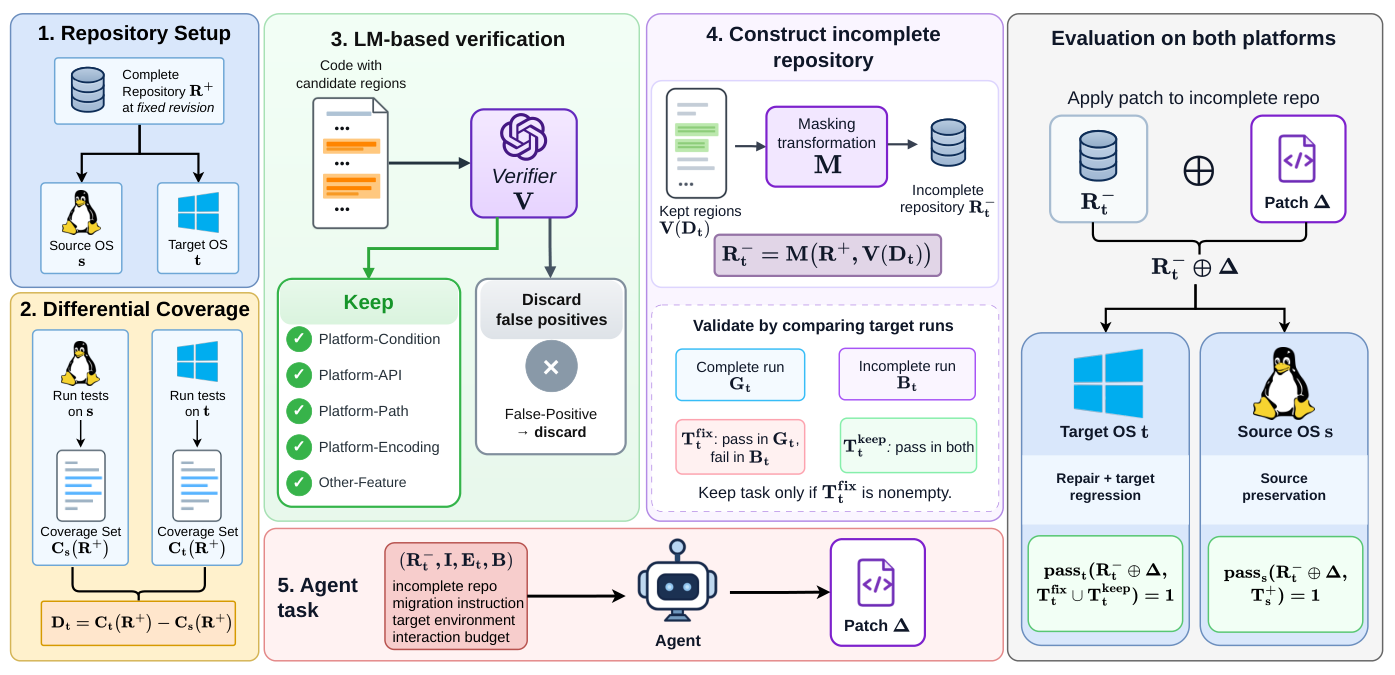
从左侧两平台覆盖差异出发,中间筛查并遮蔽目标实现,右侧要求同一补丁通过目标修复与源平台保留检查。
随后,构造器遮蔽已确认的目标平台实现,保留原测试。只有遮蔽后至少一个目标测试不再通过、源平台参考测试仍通过的候选才被保留。Agent 得到不完整仓库、迁移目标及原生工具环境,提交补丁后再做双平台检查。这是从已存在实现构造的恢复任务,其难度与从零设计新平台支持相关,但不能完全等同。
最有信息量的是两种评分之间的落差
数据集含 111 个仓库的 140 个任务,覆盖 C、C++、C#、Go、Rust;91 个迁向 Linux,49 个迁向 Windows。六个模型以 medium thinking effort 运行,每次上限 100 步、5 小时。Linux 使用三种 harness,Windows 使用 Win-agent。
| 代表配置 | 双平台成功 |
|---|---|
| Claude-Opus-4.8 + OpenHands,迁向 Linux | 24/91,26.4% |
| GPT-5.6-Sol + Win-agent,迁向 Windows | 10/49,20.4% |
更值得读的是 GPT-5.6-Sol + Claude Code:50 个 Linux 目标任务通过第一阶段,只有 22 个取得双平台通过,成功率从 54.9% 降到 24.2%。其中 28 个缺少有效的源平台通过结果,不能把这些全部武断归为已确认的代码回归,但足以说明只验目标平台会高估完成度。
作者对 35 次明确记录的目标阶段失败进行审计,18 次仍留有未恢复实现,19 次验证范围不完整,两类可重叠。这把改进方向落到具体行为:追踪跨文件迁移范围,确保局部验证没有遗漏必要测试与构建模式。
阅读判断:值得精读任务构造与双阶段评测。 同一模型换 harness 后成绩也会变化,因此榜单反映模型和工具共同能力。两个方向的题目构成不同,不能仅凭差值判定某个操作系统更难;C/C++ 样本尤其少。依赖覆盖差异还会漏掉两平台走同一路径的抽象层实现,测试通过也只支持测试覆盖到的行为。
02 · JointServe:把模型权重与会话 KV 放进同一显存预算
JointServe: Serving Multi-Model Agents on Memory-Constrained GPUs
Daijin Hu · 首发:2026-10-14
专家切换有去程,也有回程
一个规划模型调用多个独立专家时,所有权重未必能同时装进 GPU。整模型换入会拖慢下一次调用;为权重让路而丢掉 KV,则让会话返回时重新处理长上下文。只加速模型加载,无法一并解决这两种等待。JointServe 把权重层组和会话 KV 块都看成驻留对象,按预计复用概率、恢复成本与占用字节共同选择。
这与仅管理请求队列的系统有所不同:它决定显存中究竟保留什么。已有会话路由和主机 KV 恢复技术也会保存状态,本文的增量在于单 GPU 内更细粒度的权重/KV 联合分配,以及调用到达之前的准备。
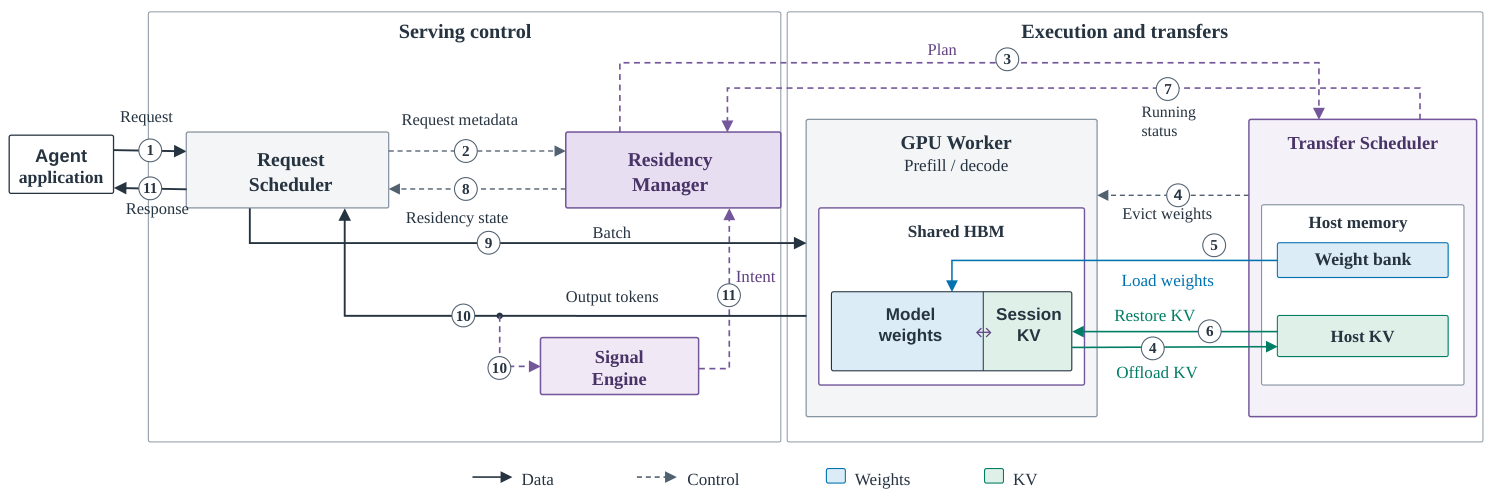
下方信号模块从输出中提取意图,驻留管理器据此分配共享显存,右侧传输调度器搬运权重与会话 KV。
信号模块读取调用者输出流中的工具调用头,在参数尚未生成完时识别下一个专家。驻留管理器保留启动所需层组,提前搬入其余部分;运行时用就绪事件控制每层执行,未到齐就等待。没有显式意图时才退回调用转移统计和热门度,因而收益取决于可见信号和实际重叠窗口。
KV 有有效主机副本时可以取回,否则需要重算。两条路径的成本不同,不能仅按块大小驱逐。传输调度器还给活跃会话 KV 流量默认保留 15% 带宽下限,避免大批权重传输长期挤占恢复通道。权重与 KV 的份额随需求调整,但在用状态和已承诺启动区域受保护;目标驻留计划也不等于数据已经就绪。
收益应按显存压力和会话结构来读
实验使用单张 A800-SXM4-80GB、1 TB 主机内存和约 24.3 GB/s 的实测主机到设备带宽。标准池由五个 7B 级专家组成。在 80 GB 的 40% 配额下,再扣除 8 GB 运行时预留,可用预算为 24 GB。作者报告中位会话完成时间为 516 秒,相对最强整模型交换基线缩短约 21.7%。
消融更能说明组合机制:去掉部分驻留,完成时间升至 608 秒;去掉主机 KV 层升至 793 秒;同时去掉自适应控制则为 641 秒。它不是单靠提前加载得益,避免返回时重算同样关键。SWE-bench 轨迹实验报告会话时间缩短 49.1%,而 τ-bench 只有 5.2%;后者仍改善首 token 延迟,因为用户思考间隙本来就能隐藏部分交换开销。
阅读判断:联合管理权重与 KV 的思路值得跟进,极端容量结果需谨慎解读。 论文的正常热切换路径写明 decode 前整模型已驻留,却同时报告整模型装不下时仍能完成的场景;这些描述尚不足以清楚解释极小预算下的完整执行路径。因此不把该场景的“46 倍”当作常规速度结论。当前原型也采用原地覆盖,而双缓冲切换仍属于目标设计。优先读驻留成本模型、执行协议和消融;硬件带宽、调用间隙、主机容量及可见工具意图都会改变实际收益。
03 · DiffTry:用不同重试上限保护高价值请求
Prioritizing Microservice Requests via Retries
Ofek Lavi、Jhonatan Tavori、Hanoch Levy、Anat Bremler-Barr · 首发:2026-10-14
DiffTry 把优先级放进重试预算:高价值请求获得更多机会,低优先级请求较早退出。各服务按传播的优先级头设置本跳重试上限,不必等待全局过载信号,也不修改应用代码。
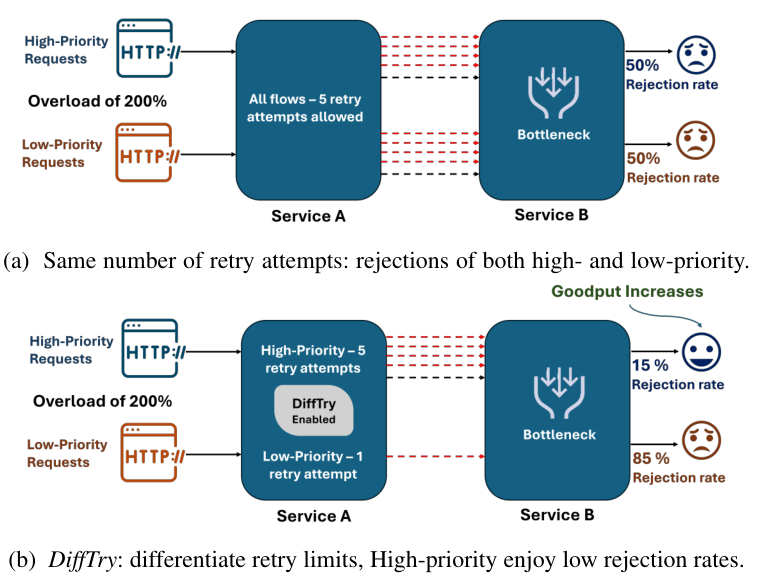
上方所有请求均可重试五次;下方将低优先级压至一次。图中百分比是两服务示例,不是后文网络实验的全部结果。
在 Kubernetes/Istio 的 DeathStarBench hotelReservation 实验中,高/低优先级预算为 5/1,对照为 5/5;高优先级到达率固定为 50,低优先级从 50 扫到 250。最重负载约为容量的 2.1 倍时,高优先级拒绝率从约 54% 降到约 15%,低优先级约为 61%。这体现拒绝的重新分配,不是所有请求都获益。理论使用重试拒绝独立性等近似,并讨论长服务时间导致的相关性;任意网络的均衡唯一性也没有全部解决。值得读的是轻量控制点及其网络分析,前提是业务优先级本身可信。
社区观察:可用性与信任都需要任务级证据
LinuxSecurity 的原帖(2026-10-13)提醒:健康端点响应成功时,实际推理仍可能停滞。其关于 vLLM 调度器的描述提示,应将有时间上限的真实生成探针、队列深度与完成请求数放在一起看。原帖没有完整给出受影响配置和漏洞验证材料,因此这里采用其观测设计提醒,不据此列出确定的修复版本或受影响范围。
Nancy Wang 的原帖(2026-10-13)介绍与 Mercor 的 SRE agent 实践,强调严格评测、只读访问和人工监督,并报告 95% 准确率、修复时间中位数降低 57%。这些是发帖者报告的项目结果;原帖没有给出样本量、准确率定义及对照协议,尚不能作为通用 SRE 自动化收益。更值得保留的是把权限边界与评测同时设计的实践方向。